环境引导:用数据流控制提升AI智能体的实用性与安全性

「环境引导」通过数据流追踪与声明式策略,在运行时纠偏LLM智能体的不安全行为,同时提升任务成功率。
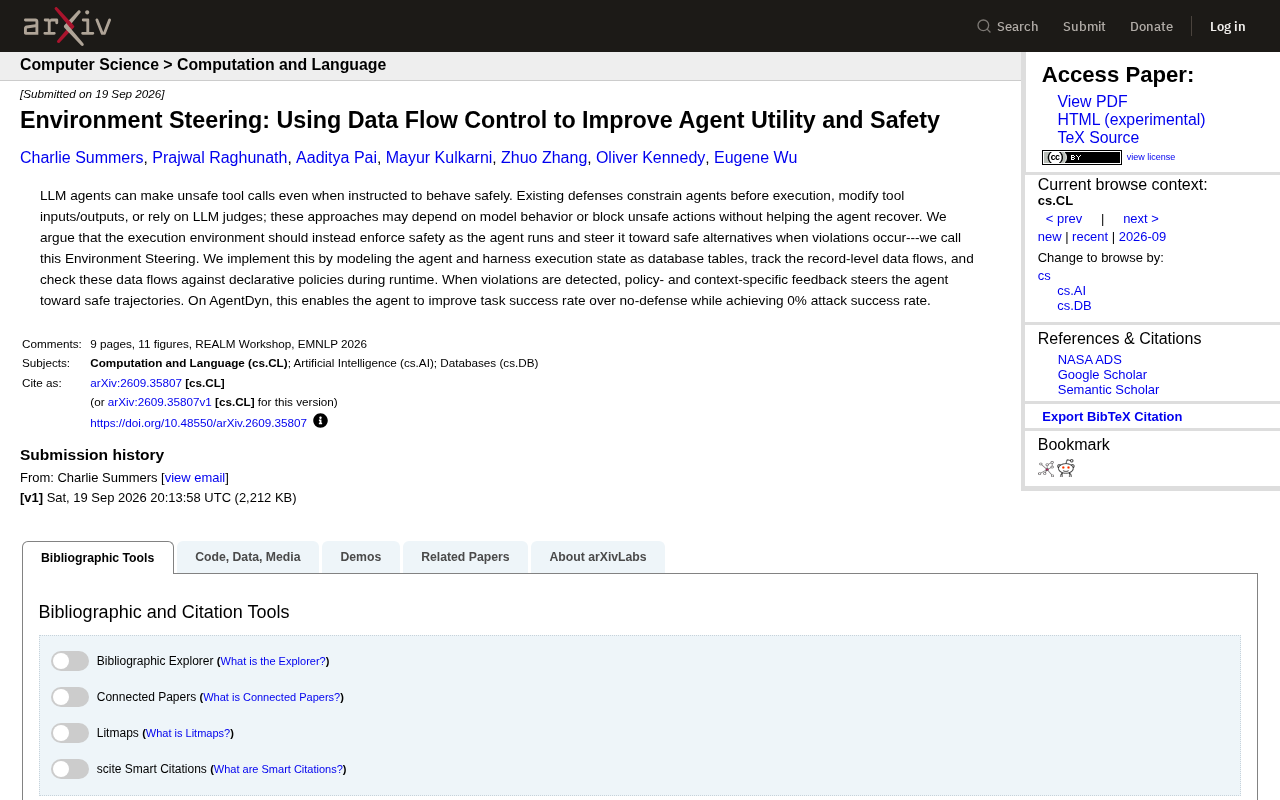
这篇arXiv论文针对LLM驱动智能体的安全防御提出了「环境引导(Environment Steering)」框架。现有三类主流防御方法——执行前约束、修改工具输入输出、引入LLM裁判——均存在结构性缺陷:它们要么依赖模型自身行为的可靠性,要么在拦截违规后就此打住,不帮助智能体从错误中恢复。环境引导的核心思路是将执行状态建模为数据库表,在记录粒度追踪数据流,并用声明式策略进行运行时校验;一旦检测到违规,系统提供与策略和上下文相关的反馈,将智能体引导至安全的替代路径,而非简单阻断。在AgentDyn基准上,该方案实现了任务成功率超越无防御基线、攻击成功率降至0%的双重成果,打破了安全与实用性此消彼长的固有假设。
LLM智能体的安全困境
大语言模型(LLM)驱动的智能体正在快速接管越来越多的自动化任务,从调用外部工具到执行多步操作。但一个现实问题始终存在:即便你明确指示智能体“要安全地行事”,它依然可能发起不安全的工具调用。指令层面的约束并不足以保证行为层面的安全。
这篇发表于 arXiv 的研究(arXiv:2609.35807v1)正是针对这一痛点提出了新思路。作者指出,现有的防御手段大多存在结构性缺陷,需要一种能在运行时真正介入并引导智能体的机制——他们称之为 Environment Steering(环境引导)。
现有防御方法为何不够
论文梳理了当前主流的三类防御路径,并逐一指出其局限:
执行前约束
第一类方法是在智能体执行动作之前施加约束,试图提前堵住不安全的行为路径。问题在于,这类静态约束往往依赖对模型行为的预判,一旦智能体的实际决策偏离预期,约束就可能失效。
修改工具输入输出
第二类方法通过改写工具的输入或输出来过滤风险。这种做法虽然直接,但它并不理解数据在整个执行链条中的流转,容易误伤正常任务,也难以覆盖复杂的多步场景。
依赖 LLM 裁判
第三类方法引入额外的 LLM 作为“裁判”来判断某个动作是否安全。这本质上又回到了对模型行为的依赖——裁判本身也是一个可能出错的模型,其判断的可靠性无法得到硬性保证。
作者的核心批评是:这些方法要么依赖模型自身的行为表现,要么在拦截不安全动作后就此打住,并不帮助智能体从错误中恢复,只是简单地“堵”,而非“导”。
环境引导的核心思路
研究者提出了一个视角转换:安全不应只在智能体内部被处理,而应由执行环境在运行时强制执行,并在违规发生时主动把智能体引导向安全的替代路径。
这套机制的实现相当巧妙,可以拆解为三个关键环节:
- 状态建模为数据库表:将智能体和执行框架(harness)的运行状态建模为一张张数据库表,让原本抽象的执行过程变得结构化、可查询。
- 记录级数据流追踪:在记录(record)粒度上追踪数据的流动,精确掌握每一条数据从哪里来、要到哪里去。
- 声明式策略校验:在运行时用声明式策略(declarative policies)对这些数据流进行检查,判断是否存在违规。
当检测到违规时,系统不会简单地终止操作,而是给出与策略和上下文相关的反馈,引导智能体走向安全的执行轨迹。这正是“steering(引导)”一词的精髓——不是阻断,而是纠偏。
实验结果:安全与实用性可以兼得
安全防御方案最常见的代价,是牺牲智能体完成任务的能力。加了太多限制,智能体连正常工作都干不好。环境引导恰恰在这一点上给出了亮眼的答案。
在 AgentDyn 基准测试中,环境引导实现了两个看似矛盾的目标:
- 任务成功率超过无防御基线:也就是说,加入这套安全机制后,智能体不仅没有变笨,反而完成任务的表现更好了。
- 攻击成功率降至 0%:面对攻击,防御的有效性达到了理论上限。
这个结果的意义在于打破了“安全与实用性此消彼长”的固有假设。通过在运行时提供有针对性的反馈,环境引导让智能体在被纠正的同时继续推进任务,而非被一刀切地拦下。
AgentDyn是一个专为评估LLM智能体动态任务执行能力设计的基准测试框架,重点考察智能体在多步骤、工具调用链场景下完成任务的成功率,同时也支持注入对抗性攻击来评估防御方案的有效性。"攻击成功率"在此语境下通常指提示注入(Prompt Injection)等攻击手段绕过安全约束、诱导智能体执行恶意操作的比例。提示注入是当前Agent安全的核心威胁之一:攻击者通过在工具返回内容、网页文本或环境数据中嵌入恶意指令,欺骗LLM将其误认为合法指令并执行。环境引导将攻击成功率降至0%的同时任务成功率不降反升,表明其反馈机制不仅纠正了恶意诱导,还为智能体提供了足够的上下文帮助其继续推进合法任务,这对于提示注入防御领域而言是相当有力的实验信号。
这项研究的启示
环境引导代表了一种从“外部约束”到“环境级治理”的思路迁移。它把数据流控制这一在数据库和信息安全领域成熟的概念,迁移到了 LLM 智能体的运行时治理中。
对于正在构建 Agent 系统的开发者而言,几个值得关注的点是:将执行状态结构化为可查询的数据模型,用声明式策略而非硬编码规则来表达安全约束,以及把“恢复引导”作为防御的一部分而不仅仅是拦截。这些设计原则对于构建既可靠又实用的智能体框架有直接的参考价值。
需要说明的是,本文基于论文摘要撰写,具体的策略语言设计、数据流追踪的性能开销以及在更广泛基准上的泛化能力,仍有待完整论文的进一步披露。
背景补充
数据流追踪(Data Flow Tracking/Taint Analysis)是信息安全领域的经典技术,其核心思想是为数据打上"标签",跟踪这些带标签的数据在系统中的传播路径,从而判断不可信数据是否污染了敏感操作。在传统软件安全中,这一技术常用于检测SQL注入、XSS等漏洞。将其引入LLM智能体场景,意味着系统需要追踪每一条输入(如用户指令、工具返回结果)如何流经各个处理步骤,最终影响哪些工具调用或输出。"记录级"的粒度强调追踪单元是具体的数据条目而非笼统的数据类型,这使得系统能够区分"这条来自外部网页的内容触发了文件写入"与"用户明确授权的写入操作",从而在多步骤、多工具的复杂Agent任务中实现精准的安全校验。
声明式策略(Declarative Policies)是一种描述"期望结果"而非"执行过程"的规则表达方式,与命令式(Imperative)编程形成对比。在数据库领域,SQL本身就是声明式的——你只需说明"查询哪些满足条件的记录",而无需指定如何遍历数据。在安全策略领域,声明式规则的典型形式如"来自外部工具返回值的数据,不得直接传入执行系统命令的工具"。这种写法的优势在于策略本身易于审计和维护,不会与业务逻辑耦合,且可以由领域专家(而非程序员)来定义和修改。相比之下,硬编码规则(如在代码中写死"if tool_name == 'shell_exec': block")难以覆盖未预见的场景,且散布在代码库中难以统一管理。环境引导将声明式策略应用于运行时数据流校验,本质上是把成熟的数据库访问控制范式移植到了Agent的执行治理层。
相关推荐
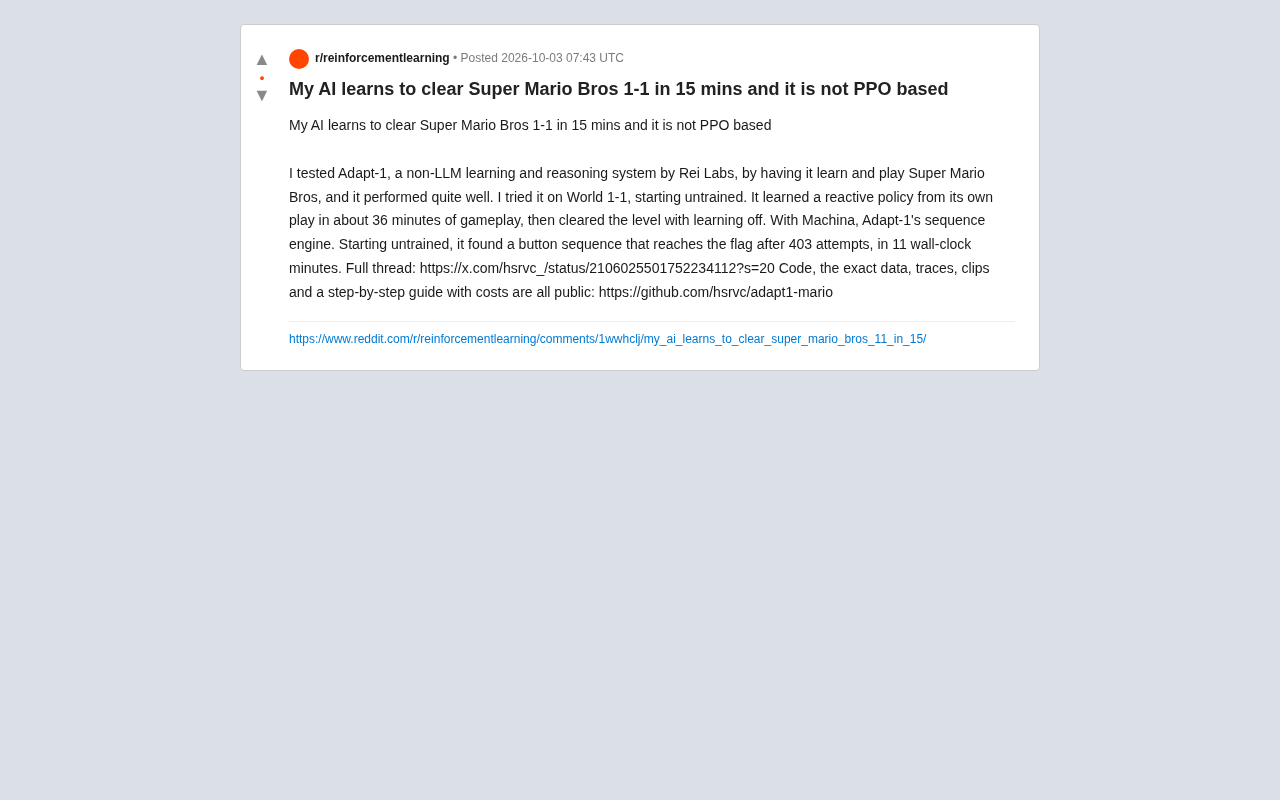
非PPO的Adapt-1:15分钟自学通关超级马里奥1-1
Rei Labs的Adapt-1是一个非PPO、非LLM的学习与推理系统,通过反应式策略和Machina序列引擎两种方式从零开始通关超级马里奥1-1,并公开全部代码与数据供复现。本文解析其方法与局限。

Seedance集成Computer:营销与品牌团队的AI新利器
Seedance 集成到 Computer 平台后,为营销和品牌团队带来 AI 视频内容生成的新可能。本文解析这类集成式 AI 工具对营销工作流的价值与落地考量。

vLLM 发布 v0.31.0:为 Transformers 版本设置上限约束
vLLM 发布 v0.31.0 版本,核心改动是在依赖项中为 Transformers 库添加版本上限约束,提升兼容性与部署稳定性。本文解析该改动的技术动机与对使用者的实际影响。