会遗忘的记忆星图:每条记忆都是一颗星的开源插件

B站开源项目用星图可视化AI记忆衰减,三层轨道和恒星机制管理记忆优先级。
本文介绍了一个来自B站的开源AI记忆管理插件,它用“星图”将每条记忆呈现为星星,大小由权重决定,亮度反映多久未被使用,直观展示记忆衰减。星图设三层轨道(稳定区、待办区、归档区)动态迁移记忆,中心恒星则永不遗忘且不进入上下文,避免干扰AI推理。工程上,项目零依赖、一条命令初始化,通过66项测试(含并发写、命令注入、坏文件),并提供HTTP接口对接外部程序。文章最后讨论了可视化可能带来的过度干预问题,以及恒星数量平衡的挑战,认为该项目在记忆可视化和工程完成度上值得开发者尝试。
在AI记忆管理工具同质化严重的当下,一个来自B站的开源项目用「星图」重新定义了记忆的呈现方式:每条记忆化为一颗星,大小取决于权重,亮度反映它多久未被想起。这个记忆插件将抽象的遗忘机制可视化,并提供了完整的工程实现。
设计理念:把记忆衰减变成可观测的星空
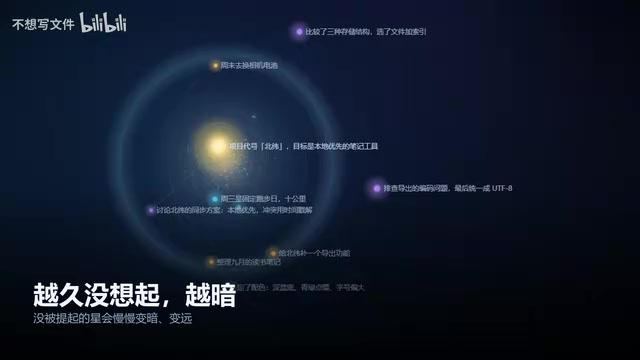
传统记忆插件通常用列表或标签管理内容,用户很难直观感知哪些记忆正在「褪色」。这个插件引入天文学隐喻:记忆的权重决定星星大小,最近被访问的频率决定亮度。随着时间推移,低权重且长期未使用的记忆会逐渐变暗,并沿着轨道向外漂移。
据UP主介绍,项目模拟了数十天的记忆演化过程,没什么存在感的记忆会变暗并慢慢飘到边缘。这种动态衰减机制让用户一眼就能看出哪些记忆正在被大脑「边缘化」,从而决定是强化还是放任遗忘。
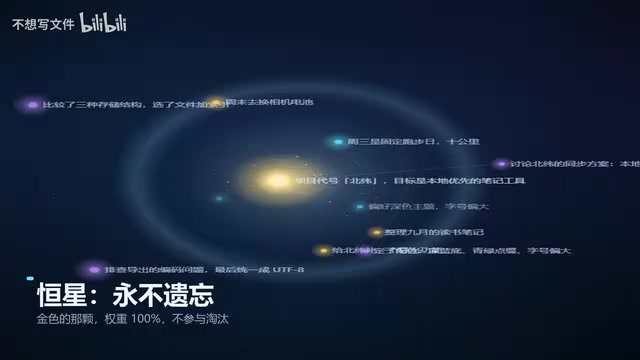
记忆衰减(Memory Decay)是认知科学和AI记忆系统中的常见机制,指记忆的强度随时间推移和缺乏访问而逐渐减弱。在AI应用中,这通常通过时间衰减函数实现,例如艾宾浩斯遗忘曲线或指数衰减模型,让低权重或长期未访问的记忆被降权、归档或删除。星图将这一抽象过程可视化,使用户能够直观感知记忆的“新鲜度”和重要性变化。这种设计借鉴了人脑的记忆巩固与遗忘机制,有助于系统自动管理记忆优先级,减少手动清理的负担。
三层轨道与恒星机制:稳定、待办与归档
星图用三条轨道对应三层记忆:内圈是稳定区,存放核心且常用的记忆;中圈是待办区,对应需要关注但尚未固化的内容;外圈是归档区,放置低频使用的记忆。这种分层并非静态标签,而是随记忆活跃度动态迁移。
最特别的是位于中心的「恒星」。据UP主描述,恒星永远不会遗忘,也不参与淘汰。这为关键记忆提供了一种「钉住」机制,避免重要信息被衰减算法误伤。恒星同样只展示在星图中,但不进入上下文,这意味着它不会干扰AI的实时推理,仅作为长期参考存在。
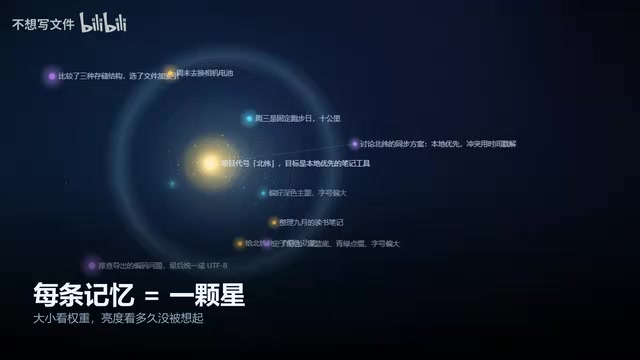
恒星机制类似于记忆系统中的“钉住”(pinning)或“收藏”功能,用于将关键记忆标记为不可遗忘。在AI记忆管理里,这类机制通常允许用户或系统将某些记忆设为永久保留,绕过衰减算法。星图的恒星不仅免于淘汰,还只展示在可视化界面中而不进入上下文,这类似于“长期参考”与“实时工作记忆”的分离。上下文窗口是AI推理时输入的有限文本,恒星不进入上下文意味着它不会占用推理资源,仅作为外部知识库存在,避免干扰实时决策。这种设计平衡了记忆保护与推理效率。
工程实现:零依赖、66项测试与HTTP接口
这个插件在工程层面同样值得关注。据UP主介绍,项目实现了零依赖,克隆后一条命令即可初始化,降低了部署门槛。功能覆盖了66项测试,包括并发写、命令注入、坏文件等场景,均为实测通过。这种测试覆盖在个人开源项目中并不常见,尤其是对安全边界(命令注入)和异常处理(坏文件)的考虑,说明作者对生产可用性有明确要求。
插件还提供HTTP接口,可以对接其他程序。这意味着星图不仅是一个可视化面板,还能作为记忆服务被外部应用调用,扩展了使用场景。仓库地址在视频简介和评论区,方便开发者直接获取。
零依赖(Zero-dependency)指项目不依赖任何第三方库或框架,所有功能均基于标准库实现。这降低了部署复杂性和版本冲突风险,使克隆后一条命令即可运行。HTTP接口则通过RESTful API或类似协议暴露记忆服务,允许其他程序(如聊天机器人、自动化脚本)调用星图的记忆管理功能,实现跨应用集成。测试覆盖的并发写、命令注入、坏文件等场景,分别检验多线程安全、安全漏洞防护和异常输入处理,这些是生产级软件的关键质量指标。
一点观察:可视化能否真正改善记忆管理?
从产品角度看,星图的价值在于把「遗忘」从隐式过程变成显式反馈。用户不再需要手动清理记忆,系统通过衰减和轨道迁移自动完成优先级排序。但这也带来一个疑问:当记忆被可视化后,用户是否会过度干预衰减过程,反而破坏了原本自动化的筛选机制?
此外,恒星机制虽然解决了关键记忆的保护问题,但如何定义「恒星」仍然依赖用户判断。如果恒星数量过多,星图的动态性会打折扣;如果过少,又可能遗漏重要信息。这需要在实践中摸索平衡。
总体而言,这个开源插件在记忆可视化方面提供了新颖的思路,工程完成度也超出预期。对于需要管理大量AI记忆的开发者来说,值得一试。
相关推荐

GPT-6 Astra读权重绝技:仅限小网络,实用靠写代码
GPT-6 Astra能直接读网络权重,但无工具设置仅限约17万权重的小网络。修复QUEN 3.5 0.8b推理循环靠写Python和50批练习,实测识别游戏耗时近一小时。本文梳理能力边界与两个安全提醒。

GPT-6 Astra 改写 Qwen 权重:7.9% 到 48.1%,是学会了数学还是学会了停?
MIT研究者用GPT-6 Astra直接编辑Qwen权重,数学得分从7.9%升至48.1%,全程无训练。但独立复现显示,提升主要来自修复循环、让模型学会终止作答,而非新增数学能力。

Qwen 3.8 27B 真能读懂神经网络权重?16GB 实测揭秘
MIT 研究声称大模型能直接读取神经网络权重并识别训练游戏。我们在 16GB 显卡上实测 Qwen 3.8 27B,发现信号真实存在,但“原生读取”说法不成立,25 行 Python 脚本即可秒级还原答案。