IGG基准:交互式GUI定位新挑战,AI智能体如何突破可见性约束?

IGG基准要求智能体先交互使GUI目标可见再点击,揭示开源VLM仅31.6%远逊人类94.6%。
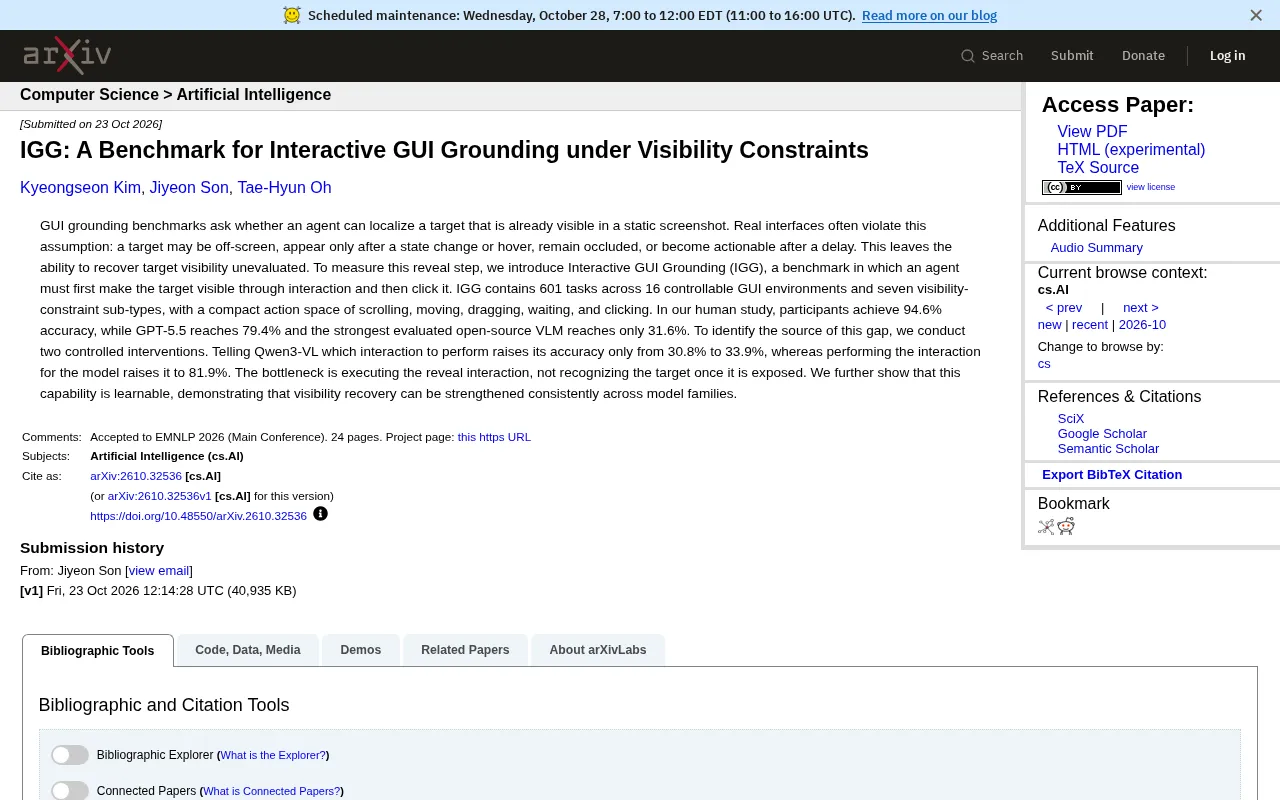
研究者提出交互式GUI定位基准IGG,要求智能体通过滚动、悬停、拖拽、等待等动作先使目标可见,再完成点击,包含601个任务、16个环境和7种可见性约束子类型。人类准确率达94.6%,GPT-5.5为79.4%,最强开源VLM仅31.6%。控制实验显示,告知模型应执行的动作仅将准确率从30.8%提升到33.9%,而由系统代执行交互后跃升至81.9%,证明瓶颈在于执行揭示交互而非识别目标。微调实验表明该能力可跨模型家族学习获得,为GUI智能体研究指明从静态感知转向交互策略的方向。
引言:当GUI元素“消失”时,AI还能点击它吗?
当前主流的GUI grounding基准测试,通常假设目标元素已经显示在静态截图中,智能体只需定位并点击即可。但真实界面往往不满足这一前提:按钮可能藏在屏幕外、需要悬停才出现、被弹窗遮挡,或者要等待加载后才可操作。这种“先让目标可见,再点击”的能力,恰恰是现有评测的盲区。
为此,研究者提出了交互式GUI定位(Interactive GUI Grounding, IGG) 基准,要求智能体通过交互动作(滚动、移动、拖拽、等待、点击)先使目标可见,再完成点击。IGG包含601个任务、覆盖16个可控GUI环境和7种可见性约束子类型。人类参与者在测试中达到94.6%的准确率,而GPT-5.5仅79.4%,最强的开源视觉语言模型(VLM)只有31.6%。这一显著差距揭示了当前AI智能体在真实交互场景中的核心短板。
GUI grounding(图形用户界面定位)是GUI智能体领域的基础任务,指给定一条自然语言指令,智能体需要在界面截图中定位到与之对应的可交互元素(如按钮、输入框、链接)并输出其坐标以执行点击。早期工作多基于Rico、ScreenSpot等数据集,采用“静态截图+元素标注”的范式,模型本质上是做视觉-语言对齐下的目标检测。
视觉语言模型(VLM) 则是同时处理图像与文本输入的多模态大模型,如GPT-4o、Qwen2.5-VL等。在GUI场景中,VLM通常被用作端到端智能体:输入当前截图与任务描述,直接输出下一步动作。与传统的模块化流水线(感知→规划→执行分离)不同,VLM智能体需要在单一模型中同时完成界面理解、状态推断和动作决策,这也使得“交互规划”成为其能力短板更容易暴露的环节。
性能鸿沟:人类94.6% vs. 开源模型31.6%
在人类研究中,参与者准确率高达94.6%,说明这些任务对人类并不困难。但AI模型的表现呈现两极分化:GPT-5.5达到79.4%,表现相对较好;而最强的开源VLM(如Qwen3-VL)仅获得31.6%的准确率。为何差距如此之大?
研究者通过两项控制干预来定位问题根源。
知道“怎么交互”≠能“执行交互”
第一项干预:直接告诉Qwen3-VL应该执行哪个交互动作(例如“向下滚动三格”),其准确率仅从30.8%提升到33.9%,几乎无实质改善。第二项干预:由系统代替模型执行交互动作,只让模型负责在目标暴露后点击,准确率跃升至81.9%。
这组对比清晰地表明:瓶颈在于执行揭示交互(reveal interaction),而非识别暴露后的目标。模型并不缺乏对目标外观的理解,而是难以规划并执行一系列动作来改变界面状态,使目标进入可点击范围。
控制干预(controlled intervention) 是认知科学与AI评测中常用的实验设计:在保持其他条件不变的前提下,人为改变某一个变量(此处为“是否告知动作”或“是否代执行交互”),观察模型表现的差异,从而将总体性能拆解到具体子能力上。
本文两项干预构成了一组“上界—下界”对照:告知动作相当于给模型一个强先验,测试其执行能力;代执行交互则直接跳过揭示阶段,测试其纯定位能力。两者之间的巨大落差(33.9% vs. 81.9%)说明失败主要发生在“状态改变”环节,而非“目标识别”环节。这种实验范式的价值在于,它把笼统的“模型不行”细化为可归因的能力缺口,为后续训练数据的构造提供了明确靶点。
能力可学习:跨模型家族的提升
研究进一步验证,这种“可见性恢复”能力是可以通过训练获得的。在多个模型家族上进行微调后,智能体在IGG上的表现均获得一致提升,说明该能力并非某个模型的偶然特性,而是一种可迁移的技能。
IGG基准的设计细节
IGG基准包含601个任务,覆盖16个可控GUI环境,每个环境模拟了不同的交互逻辑和界面布局。任务被划分为7种可见性约束子类型,例如:
- 屏幕外目标:需要滚动或拖拽才能进入视野
- 悬停触发:目标仅在鼠标悬停时出现
- 遮挡目标:被其他元素覆盖,需先关闭或移开遮挡物
- 延迟出现:需等待加载或动画完成
动作空间被压缩为五种基本操作:滚动(scroll)、移动(move)、拖拽(drag)、等待(wait)和点击(click)。这种紧凑设计降低了动作空间的复杂度,同时保留了真实交互的核心要素。
动作空间(action space) 指智能体在环境中可执行操作的集合。真实GUI操作本可包含任意坐标点击、多指手势、键盘输入等连续或高维动作,但评测中通常将其离散化为少数原子动作。IGG将动作空间压缩为scroll、move、drag、wait、click五种,一方面降低了策略学习的搜索空间,使不同模型间的比较更公平;另一方面也保留了“改变界面状态”所需的最小操作集。
需要区分的是原子动作与动作序列:前者是单步执行单元,后者是智能体为达成目标而规划的多步轨迹。IGG的核心难点恰恰在于后者——模型必须推断“当前目标不可见→应执行何种动作→动作执行几次→目标是否已暴露→再点击”这一完整链条,而非仅预测单步动作。
为什么这一基准值得关注?
GUI智能体正从“静态截图理解”走向“动态环境交互”。IGG基准填补了可见性约束下的评测空白,其价值体现在三个层面:
- 暴露真实差距:现有基准可能高估了智能体的实际能力。当目标不在初始视野中时,开源模型的表现断崖式下跌,这对部署于真实软件的Agent是一个警示。
- 指明改进方向:瓶颈不在感知而在执行,意味着未来的研究应更关注交互策略的学习,而非单纯提升视觉识别精度。
- 提供可训练的信号:IGG任务可用于微调,帮助模型学会“先改变状态,再定位目标”的推理链条。
对于AI编程和AI应用开发者而言,这意味着在构建GUI自动化工具时,需要更重视智能体的交互规划能力,而不仅仅是元素识别准确率。
微调(fine-tuning) 指在预训练模型基础上,用特定任务数据继续训练以适配下游能力。本文所述“可见性恢复能力可通过训练获得”,其意义在于区分了两种能力来源:一是零样本泛化(模型未经该任务训练即可完成),二是可学习性(模型在获得相关监督信号后能掌握)。IGG上的实验表明,开源VLM的31.6%更接近“缺乏训练信号”而非“能力上限”,这为后续工作提供了明确路径——构造交互轨迹数据并做监督微调或强化学习,即可显著提升表现。
对开发者而言,这也意味着选型时不应只看模型在静态grounding榜单上的分数,而应关注其是否经过交互式轨迹训练,以及在滚动、悬停等动态场景下的鲁棒性。
结语:从“看见”到“使其可见”
IGG基准将GUI grounding的评测从静态感知推进到动态交互,揭示了当前AI智能体在可见性约束下的核心瓶颈。人类几乎不费力的“滚动一下再点击”,对模型而言却是一道需要跨越的鸿沟。好消息是,这一能力可以通过学习获得。随着更多研究者关注交互式定位,我们有理由期待智能体在真实软件环境中变得更可靠、更自主。
相关推荐

Ollama+RAG本地知识库搭建实战:AnythingLLM喂饭教程
基于B站教程整理,详解Ollama+AnythingLLM搭建本地RAG知识库的完整流程:从通用大模型的知识局限、RAG检索增强生成原理,到文档上传、向量化入库与效果验证的实操步骤。

Ollama保姆级教程:本地免费跑大模型入门指南
Ollama是一款开源的本地大模型管理工具,支持免费下载部署DeepSeek等模型,提供命令行和Web UI,跨平台且能自动调度GPU/CPU资源,适合AI开发入门与私有化部署。

给Claude装上"手":Exoproc开源MCP服务器实现活体进程钩子
Exoproc是一个开源MCP服务器,让Claude Code通过线程劫持直接挂钩活跃Windows x64进程,绕过EDR实现动态分析。静态反编译给Claude眼睛,动态钩子给它双手。