IMGNet:用符号模式匹配挑战余弦相似度的人脸验证新方案

一个来自印尼独立研究者的思考
在人脸识别领域,余弦相似度(cosine similarity) 几乎是衡量两个特征向量是否属于同一人的默认标准。这一主导地位并非偶然——2015年前后,DeepFace、FaceNet等深度学习方法将人脸识别带入高维嵌入范式,研究者发现在128至512维的特征空间中,余弦相似度比欧氏距离更稳健:欧氏距离对向量模长敏感,而模长往往受图像亮度、对比度等与身份无关的因素影响。余弦相似度计算两个向量夹角的余弦值,完全忽略向量的模长(幅值),只关注方向——这一特性使其天然适合高维嵌入空间。当特征向量被L2归一化后,余弦相似度等价于点积运算,BLAS库的高度优化使其在百万级比对中仍保持极低延迟。ArcFace、CosFace等主流损失函数都显式地将余弦相似度嵌入训练目标,形成了"用余弦训练、用余弦推断"的闭环。
从信息几何角度看,L2归一化后的特征向量分布在单位超球面(hypersphere)上,余弦相似度等价于超球面上的测地线距离度量,这与ArcFace等方法显式建模角度间隔的出发点完全一致。然而,当我们将512维空间的所有判别信息折叠为单一标量时,必然伴随信息损失——约翰逊-林登斯特劳斯引理(Johnson-Lindenstrauss Lemma)揭示了维度压缩的内在代价。高维空间还存在"维度灾难"效应:随着维度升高,点与点之间的距离趋于集中,导致近邻区分度下降,这是所有全局相似度度量面临的共同挑战。余弦相似度本质上是一种全局度量,将整个嵌入向量压缩为单一标量,无法捕捉局部结构信息。
一位来自印尼的独立研究者正是注意到这一潜在局限,提出了一个颇具启发性的问题:我们是否过度依赖了这个默认选项? 他构建的 IMGNet 模型,尝试用一种全新的方式——滑动窗口符号模式匹配(sliding window sign pattern matching)——来替代传统的余弦相似度。
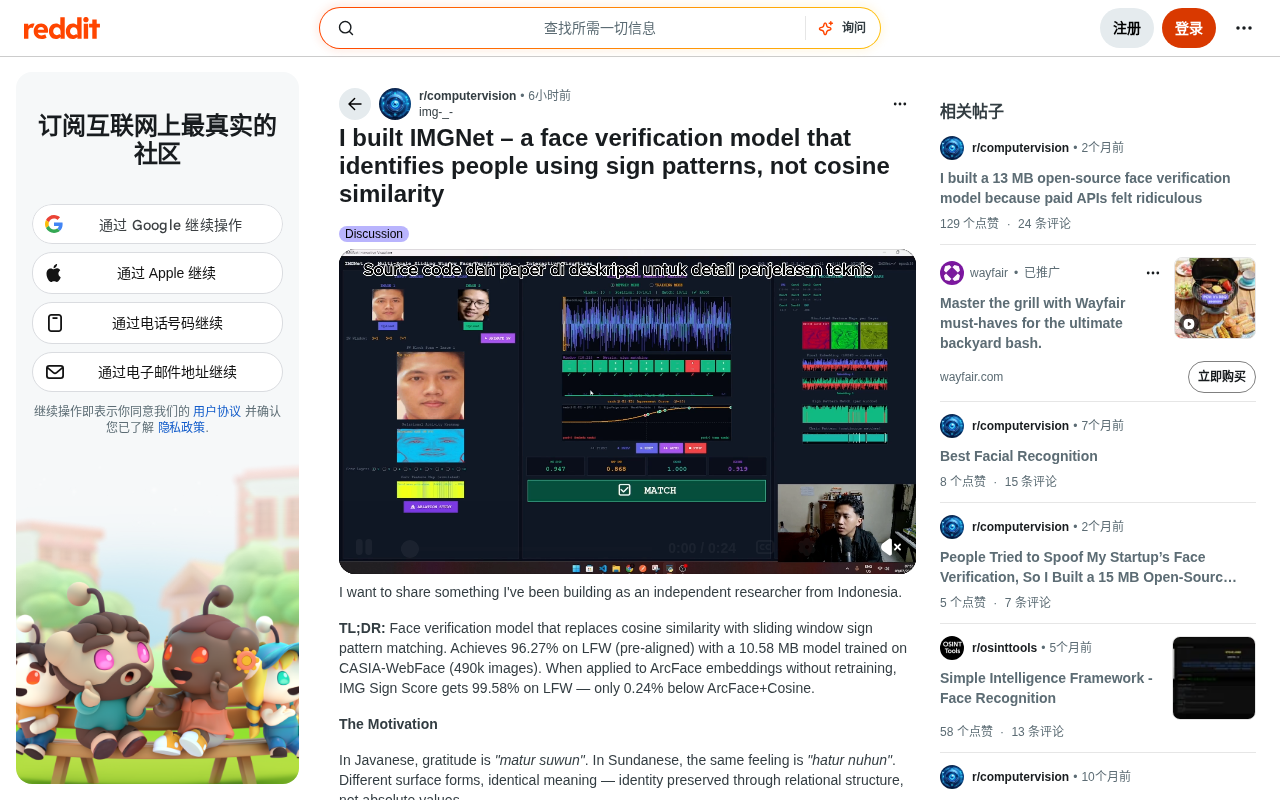
作者的灵感来源颇具文化韵味。他举例说,在爪哇语中,"感谢"是 "matur suwun",而在巽他语中,同样的情感表达为 "hatur nuhun"。两种表面形式截然不同,但传达的含义完全一致——身份是通过关系结构保留的,而非绝对数值。这正是 IMGNet 的核心哲学:与其比较嵌入向量的全局角度方向,不如在嵌入向量重叠的局部窗口中寻找一致的符号模式。
IMGNet 的核心技术创新
SW Block:多尺度关系运算
模型的底层用"多尺度关系运算"取代了标准卷积。对于每个像素,它计算该像素与所有邻居在质数窗口尺寸 {3, 5, 7} 下的差值,再由一个小型 MLP 将每个像素产生的 240 个差值映射到输出通道。选择质数尺寸并非随意——质数避免了不同尺度窗口之间的整除关系,减少了感受野的重叠冗余,使三个尺度捕获的信息尽可能互补。这一设计与神经科学中关于视觉皮层多尺度处理的发现有一定呼应:V1区的简单细胞对不同空间频率的边缘响应,本质上也是一种多尺度差分运算。从特征工程的角度看,差值运算天然具备平移不变性和光照鲁棒性——计算相邻像素的差值会自动消除全局亮度偏移,这与图像梯度特征(如SIFT、HOG)的成功经验一脉相承,区别在于IMGNet将这一操作端到端地嵌入深度学习框架中进行学习。这种设计从底层就强调"相对关系"而非"绝对值",与整个模型的关系结构理念一脉相承。
IMG Sign MSE Loss:纯符号模式损失
符号模式(sign pattern)匹配的思想有其深刻的信息论根源。理解这一设计需要追溯到局部敏感哈希(LSH)领域:2004年Moses Charikar提出的Simhash算法揭示了一个深刻事实——用随机超平面对高维向量做二值化(取符号位),两个向量符号位碰撞的概率恰好等于1减去它们夹角除以π,这直接建立了符号一致性与余弦相似度的数学等价关系。这意味着符号信息本身就是方向信息的充分统计量:在足够多的随机投影下,符号向量可以无损地还原余弦相似度。
符号函数(sign function)是最极端的量化操作,将连续实数压缩为单个比特,但这种极端压缩保留的是向量的方向信息而丢弃幅值。局部化的符号比较则进一步引入了空间上下文:相邻维度之间的符号一致性模式构成了一种结构化的局部描述子,类似于传统计算机视觉中的LBP(局部二值模式)在纹理描述上的成功逻辑。将全局比较局部化的另一个优势是天然的抗噪性:局部窗口内的随机噪声干扰不会传播到其他窗口,而全局度量中单个异常维度的影响会被平均分散到最终标量中,难以定位也难以消除。
IMGNet将这一全局符号比较局部化——不是对整个向量做全局符号比较,而是在滑动窗口内比较局部符号一致性,相当于用多个局部"超平面集合"代替单一全局决策面,理论上能捕捉到全局余弦相似度可能抹平的局部判别结构,同时提升对局部噪声的鲁棒性。
作者声称这是据其所知第一个完全基于符号模式一致性、不依赖幅值的人脸验证损失函数。核心公式如下:
score = mean(gate(tanh(β · E1 · E2)))  # 滑动窗口,β=10
loss_same = ((1 - score) ** 2).mean()   # 推向 1.0
loss_diff = (score ** 2).mean()          # 推向 0.0
在训练稳定性上,这个基于符号的损失在第 29 到 50 个 epoch 之间的方差仅为 ±0.40%,而基于幅值的变体方差高达 ±2.25%——符号模式匹配在训练过程中表现出显著更强的稳定性。
三度量共享阈值与投票机制
模型定义了三个均落在 [0,1] 区间的度量:IMG Sign Score、AMP IMG Score 和 Chain Score,共用一个从 IMG Sign 扫描得出的阈值。在此基础上设计了投票系统:2/3 或 3/3 通过判定为 MATCH(匹配),1/3 为 UNCERTAIN(不确定),0/3 为 DIFFERENT(不同)。这与集成学习中多弱分类器投票的思想异曲同工,多度量投票机制为最终判定提供了更强的鲁棒性。
实验结果:10MB 小模型的可观表现
IMGNet 在多个标准人脸验证基准上进行了测试,模型体积仅 10.58 MB(FP32),训练数据为 CASIA-WebFace 的 49 万张图像(CASIA-WebFace 是学术界广泛使用的训练集,包含约10,000个身份,体量远小于工业级数据集如MS-Celeb-1M的百万级规模)。以下是 IMG Sign 与传统 Cosine 的对比:
| 数据集 | IMG Sign | Cosine |
|---|---|---|
| LFW | 96.27% | 95.53% |
| AgeDB-30 | 78.80% | 77.22% |
| CALFW | 78.73% | 78.32% |
| CPLFW | 76.85% | 74.62% |
| 综合 | 81.02% | 79.49% |
理解这些结果需要了解人脸识别基准的演进生态。LFW(Labeled Faces in the Wild,2007年)是第一个被广泛接受的自然条件人脸验证基准,包含5749个身份13000张图像,但由于顶尖模型已接近饱和(超过99.8%),其区分度日渐式微,IMGNet在此数据集上的96.27%属于中等水平,说明仍有较大提升空间。AgeDB-30专门收录了跨越30年年龄跨度的同一人照片,反映衰老对面部特征的影响。CPLFW(Cross-Pose)和CALFW(Cross-Age)是2018年提出的更具挑战性版本,针对主流模型在姿态和年龄变化上的短板设计,更贴近真实部署场景的挑战。IMG Sign 在所有测试集上均略优于 Cosine,尤其在跨姿态的 CPLFW 数据集上领先超过 2 个百分点,说明符号模式对姿态变化有更强的鲁棒性。值得注意的是,工业界实际部署的评估还依赖IJB-B、IJB-C等包含视频帧的集合级基准,以及针对特定人群的公平性测试集——这些是IMGNet尚未触及的维度,也是从学术探索走向工业应用需要跨越的门槛。
直接迁移至 ArcFace 嵌入
更值得关注的实验是:作者将 IMG Sign Score 无需重新训练,直接应用到 ArcFace(buffalo_l)的预训练嵌入上,在 LFW 上达到 99.58%,仅比 ArcFace + Cosine 的 99.82% 低 0.24%。
ArcFace 是当前人脸识别领域的标杆算法,其核心思想是在余弦空间中为每个类别边界添加角度间隔(additive angular margin),强迫模型学习更紧凑的特征表示。这一设计的深层逻辑在于:训练目标与推断度量的几何一致性——损失函数直接在角度空间中施加约束,使得训练出的嵌入向量在超球面上形成明确的聚类结构,类内夹角小、类间夹角大。buffalo_l 在 MS1MV3 数据集(包含约300万张图像)上训练,LFW 准确率接近 99.8%,是工业界常用的基线。正是这种深层几何属性——超球面上紧凑的聚类结构——使得即便使用非标准度量(如符号模式),依然能够提取出有效的判别信息。
这一结果表明:即便是为余弦相似度训练的成熟嵌入,符号模式的一致性依然是有效的判别特征。作者据此推测,符号模式一致性可能是训练良好的人脸嵌入的一个基本属性,独立于训练目标本身。
一个待验证的意外发现
作者在构建带自定义多边形遮罩的消融可视化工具时,观察到一个有趣现象:对同一人的照片遮挡相同面部区域,会在相似的嵌入维度上产生 delta 峰值;而对不同人的照片,这些峰值的位置差异显著。
他推测,重叠滑动窗口损失可能在嵌入空间中诱导出某种隐式的空间组织结构。作者坦诚这一发现尚未经过正式验证,属于初步观察——若后续研究能够证实,或许能为可解释性研究提供新的切入点,也可能与神经网络中"特征局部化"的已有研究产生有趣的联系。
核心主张:度量与训练目标应协同设计
IMGNet 背后更具普适意义的假设是度量-损失对齐(metric-loss alignment):相似度度量应与训练目标协同设计,而非不假思索地默认余弦相似度。
度量学习(Metric Learning)领域对这一问题已有清晰的发展脉络。早期的对比损失(Contrastive Loss,2006年)和三元组损失(Triplet Loss,2015年)本质上都隐含欧氏几何假设,将特征提取与相似度度量视为两个独立阶段。ArcFace(2019年)的突破正在于将角度间隔直接嵌入Softmax分类头,使训练目标与余弦度量在几何上完全一致,这是其超越此前方法的关键原因之一。CircleLoss(2020年)进一步统一了配对相似度学习框架,指出不同损失函数本质上是对相似度梯度权重的不同分配策略;ProxyNCA++则用类代理(proxy)替代样本配对,降低了度量学习的计算复杂度。这些工作共同揭示:特征空间的几何结构不是训练完成后的副产品,而是由损失函数的形式主动塑造的。
值得注意的是,度量-损失对齐原则在机器学习中有着超越人脸识别的普适价值。在自然语言处理领域,对比学习框架(如SimCSE)同样面临类似问题:用余弦相似度衡量句子语义相似性,但预训练目标(如MLM)并未显式对齐这一度量。在推荐系统中,双塔模型的向量内积与实际业务目标(点击率、转化率)之间的错位是长期存在的工程挑战。这些跨领域的案例共同指向一个深层问题:特征空间的几何结构是由训练目标塑造的,而我们在推断时使用的度量函数隐含了对这一几何结构的假设——当假设与实际几何不匹配时,性能损失就会出现。
IMGNet的尝试与度量学习的演进趋势呼应,但走得更激进:它不仅要求推断度量与训练目标一致,还要求在底层特征提取阶段就将关系结构编码进去,将度量-损失对齐的原则延伸到了特征提取器的归纳偏置层面,提醒我们特征提取与相似度度量之间可能存在更深层的耦合关系,重新审视这种耦合或许能带来意想不到的性能收益。
作为独立研究者的早期探索,IMGNet 的部分结论有待更严格的验证。但它提供了一个新颖的视角,也展示了资源有限的研究者同样能在基础方法层面做出有价值的贡献。感兴趣的读者可查阅其发表在 Zenodo 的论文、GitHub 代码库以及 HuggingFace 上的模型权重。
核心要点
核心要点
相关推荐
EmbeddingGemma 2实测:手机就能跑的多模态检索模型
Google开源的EmbeddingGemma 2把文本、图像、视频、音频映射进同一向量空间,小到能在手机运行。本文解析其架构原理,并通过Colab实测图片、语音、视频、文档的多模态检索效果与短板。

为什么我们对颜色总是各执一词?
网球到底是黄色还是绿色?从一场常见的颜色争论出发,解析为什么人们对颜色总是各执一词——这背后涉及感知科学、边界色与语言对颜色命名的影响。

Unsloth 新版发布:决策模型训练让准确率从30%跃升至80%
Unsloth v0.1.904-beta 发布,新增决策模型(Decision Model)训练能力,可将任意文本或视觉 LLM 转为 Jev 风格决策模型,准确率从30%提升至80%,并支持原生 ComfyUI 模型、扩散优化及跨平台安全沙箱。