Unsloth 新版发布:决策模型训练让准确率从30%跃升至80%

Unsloth v0.1.904-beta 新增决策模型训练,可将任意LLM微调为输出置信度评分的选择工具,准确率从30%提升至80%。
Unsloth 发布 v0.1.904-beta,核心亮点是将任意文本或视觉大语言模型通过 QLoRA 微调为「决策模型」,使模型能为每个候选选项输出置信度分数,官方称准确率可从 30% 提升至 80%。训练、测试、导出与部署全流程已整合进 Unsloth Studio,支持导出 GGUF 并通过 llama.cpp 在本地部署,包括多模态版本。此外,版本还带来了原生 ComfyUI 模型支持、INT8 ConvRot 图像优化、Qwen3.5-35B 训练速度最高提升 4.1 倍,以及跨平台(Linux/macOS/Windows)原生沙箱隔离机制,标志着 Unsloth 正从训练加速库演进为一体化本地 AI 工作站。
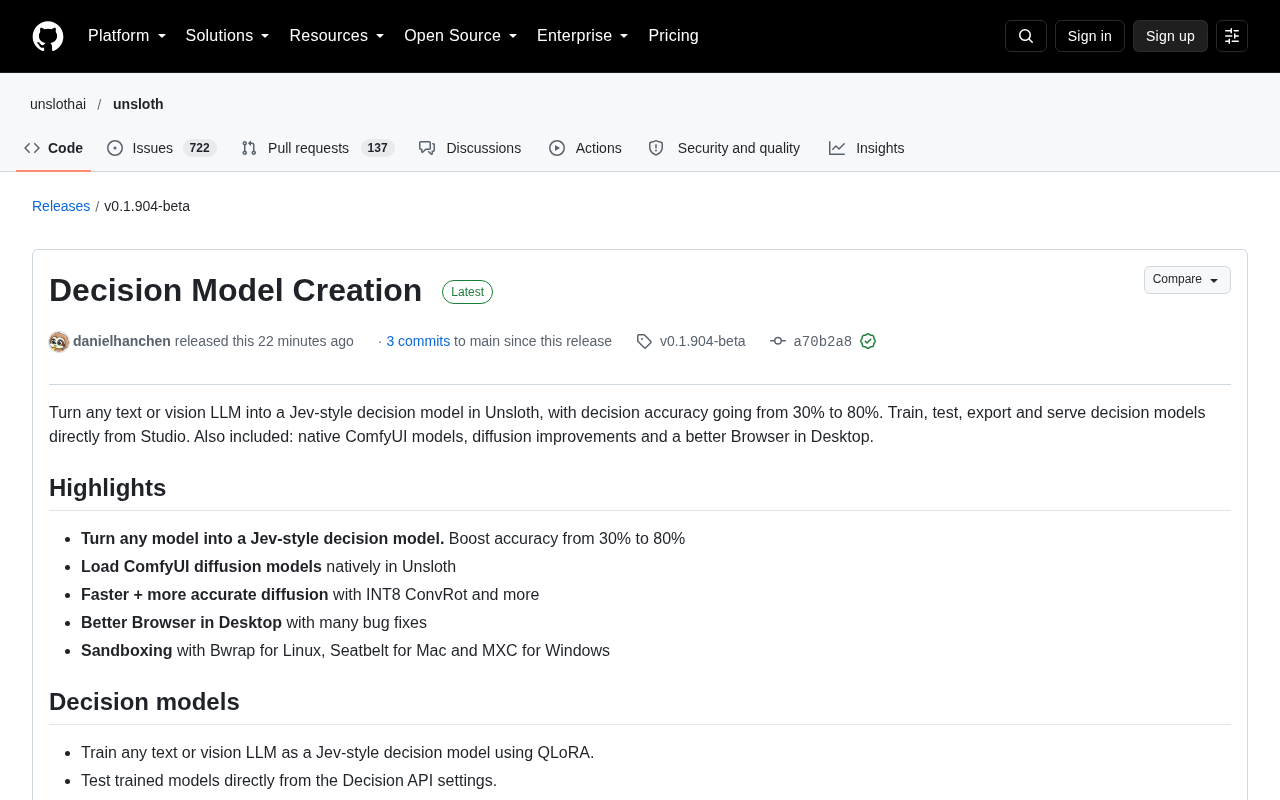
Unsloth 发布了 v0.1.904-beta 版本,带来了一项颇具实用价值的新能力——将任意文本或视觉大语言模型(LLM)转化为「Jev 风格」的决策模型(Decision Model)。官方数据显示,经过训练后,模型的决策准确率可以从 30% 大幅提升至 80%。这一更新同时附带了原生 ComfyUI 模型支持、扩散模型优化以及桌面端浏览器的多项改进。
决策模型:把普通 LLM 变成专注做选择的工具
这次更新最核心的亮点在于「决策模型」的训练流程被完整整合进了 Unsloth Studio。开发者可以直接在 Studio 内完成训练、测试、导出和部署,整个闭环无需切换多个工具。
其技术路径是通过 QLoRA 对任意文本或视觉 LLM 进行训练,使其成为一个专门处理决策任务的模型。与普通的生成式回答不同,决策模型会为每一个候选选项输出置信度分数(confidence scores),这让模型的判断更加透明、可解释,也更适合嵌入到需要明确「选择」的自动化流程中。
准确率从 30% 提升到 80% 的数字固然亮眼,但更值得关注的是它背后的工程化思路——把「做决策」这件事抽象成一个可训练、可评估、可服务化的独立任务,而非依赖通用对话模型的即兴发挥。
训练与部署的完整链路
在具体能力上,这个版本提供了相当完善的工作流支持:
- 使用 QLoRA 将任意文本或视觉 LLM 训练为 Jev 风格决策模型;
- 直接在 Decision API 设置中测试已训练的模型;
- 为每个选项生成带置信度分数的决策结果;
- 支持导出基于 Qwen3.5 骨干的 Clef 模型以及 Laya 模型到 GGUF 格式;
- 通过 llama.cpp 部署决策模型,包括能够理解图像的多模态模型;
- 支持保存和恢复更小的适配器与决策头(decision-head)检查点。
官方也提供了配套的训练指南(unsloth.ai/docs/basics/train-your-own-decision-model-with-unsloth),降低了上手门槛。能够把模型压缩成仅保存适配器和决策头的小体积检查点,对于资源有限的开发者而言尤其友好。
QLoRA(Quantized Low-Rank Adaptation)是一种参数高效微调技术,结合了量化(Quantization)与 LoRA 两项技术。LoRA 的核心思路是在原始权重矩阵旁注入低秩分解的可训练矩阵,只更新极少量参数;而 QLoRA 在此基础上将基础模型以 4-bit NormalFloat 格式量化,显著降低显存占用,使得在单张消费级 GPU 上也能微调数十亿参数的大模型。对于决策模型的训练场景,QLoRA 带来的好处是双重的:一方面保留预训练大模型的语义理解能力,另一方面通过微调「决策头」(decision head)让模型学会为有限选项输出概率分布,而非生成开放性文本。这与传统文本分类或多项选择任务在架构上有相似之处,但被整合进现代大模型的推理框架中,使其兼具语言理解深度与结构化输出的可控性。
GGUF(GPT-Generated Unified Format)是由 llama.cpp 项目定义的模型序列化格式,设计目标是让量化后的大模型能在 CPU 或消费级 GPU 上高效推理。它将模型权重、超参数、分词器词表等所有必要信息打包进单一文件,免除了多文件管理的麻烦。llama.cpp 则是一个纯 C/C++ 编写的轻量推理引擎,支持多种量化精度(如 Q4_K_M、Q8_0 等),能在笔记本甚至手机上运行大模型。将决策模型导出为 GGUF 并通过 llama.cpp 部署,意味着这类模型可以脱离 GPU 服务器、以极低延迟嵌入到本地应用或边缘设备中,对需要离线运行或隐私敏感的决策场景尤为重要。
扩散模型与 ComfyUI 原生支持
除了决策模型,这个版本在图像和视频生成方向也有明显推进。Unsloth 现在可以直接从 Hugging Face 运行受支持的 ComfyUI 图像和视频模型,并能自动识别 ComfyUI 的检查点和本地模型文件夹。
具体来看,用户可以复用自己已有的 ComfyUI 文本编码器和 VAE,直接在 Unsloth 中运行 Krea-2、HunyuanImage-2.1 和 Wan2.2 专家对(expert pairs),以及 ComfyUI 的 NVFP4 和 MXFP8 模型。这意味着原本分散在 ComfyUI 生态里的资产可以无缝迁移过来,减少了重复配置的成本。
在性能侧,Qwen-Image-2.1 默认启用了 INT8 ConvRot,使其在保留更多全精度图像细节的同时,在受支持的 NVIDIA GPU 上获得更快的生成速度。扩散模型整体朝着「更快 + 更准」的方向迭代。
ComfyUI 是目前最流行的开源扩散模型工作流编排工具,以节点式可视化界面著称,允许用户将文本编码器(Text Encoder)、VAE(变分自编码器)、采样器、ControlNet 等组件自由组合成推理管线。其生态积累了大量社区自定义节点和预训练检查点,成为图像/视频生成领域事实上的"乐高积木"平台。INT8 ConvRot 是一种结合 INT8 量化与旋转变换(Rotation)的精度优化方法,通过在量化前对权重施加正交变换来减少量化误差,在 NVIDIA 支持 Tensor Core 的 GPU(如 A100、H100、RTX 系列)上可以兼顾速度与精度。Unsloth 对 Qwen-Image-2.1 默认启用该技术,体现了从纯速度优先向速度与质量平衡演进的策略。
训练性能的显著提速
Unsloth 一贯以训练加速见长,这一版本继续巩固了这一优势。使用 QLoRA 在 A100 和 RTX PRO 6000 上,Qwen3.5-35B-A3B 的训练速度最高可提升 4.1 倍,Qwen3-30B-A3B 最高提升 3.3 倍。
此外,针对 gated-delta、Mamba2 和短卷积(short-convolution)等混合架构模型,样本打包(sample packing)得到了改进,修正了此前的打包逻辑问题。数据处理方面也有若干细节优化:支持将 prompt 和 completion 的消息列表作为一次完整对话来训练;视觉数据集现在会保留每一行各自的问题;聊天导出和训练数据也会包含系统提示(system prompt)。这些改动看似琐碎,却直接影响训练数据的质量和一致性。
桌面端浏览器与安全沙箱
桌面端的 Browser 这次迎来了大量 bug 修复和体验改进。用户可以直接针对当前打开的网页提问、确认浏览器下载并自定义保存位置、像管理聊天记录一样重新排序侧边栏中固定的页面。搜索功能也更加健壮——遇到不可用的结果时会继续往下搜索,并可回退到 Wikipedia。回复中形如 [1] 的引用标注现在会直接变成可点击的链接,RAG 嵌入模型也能从 RAG 菜单中直接选择、固定或卸载。
安全方面是这个版本不容忽视的一环。Unsloth 现在在三大平台上都为模型运行的代码提供了沙箱隔离:Linux 使用 Bwrap,macOS 使用 Seatbelt,Windows 使用 MXC。用户可以在设置中查看沙箱状态并选择保护级别。随着本地运行 Agent 和代码执行能力越来越普遍,这种原生沙箱机制为用户提供了一道必要的安全防线。
Bwrap(Bubblewrap)是 Linux 上的轻量级用户态沙箱工具,通过 Linux 命名空间(namespaces)和 seccomp 过滤器限制进程对文件系统、网络和系统调用的访问,是 Flatpak 应用隔离的底层机制之一。Seatbelt 是 macOS 内置的沙箱框架,通过声明式策略文件约束应用的权限范围。MXC 则是 Windows 平台上的容器隔离机制。当本地大模型能够生成并执行代码(即所谓的 Code Interpreter 或 Agent 能力)时,沙箱隔离从可选变成了必要——一段被恶意构造的提示(prompt injection)可能诱导模型生成危险代码,而沙箱确保这段代码无法逃逸出受控环境、访问用户的敏感文件或网络资源。Unsloth 在三大平台均提供原生沙箱,体现了随着本地 AI 能力增强,安全基础设施也需要同步跟进的设计思路。
小结
Unsloth Desktop 本身是免费且开源的,覆盖 Windows、macOS、Linux(含 ARM64)等主流平台。从这次更新可以看出,Unsloth 正在从一个单纯的「训练加速库」演进为一个集训练、推理、扩散生成、浏览器交互和安全隔离于一体的本地 AI 工作站。决策模型的引入尤其值得开发者关注——它把 LLM 的能力从「生成文本」延伸到了「做出可量化的选择」,为构建更可靠的自动化决策系统提供了新的工程基础。
相关推荐
98%家庭不付费AI:消费级AI到底是机会还是幻觉?
a16z最新报告显示全美仅2.2%家庭为AI付费,顶级1%用户支出相当于后50%总和。本文深度解析消费级AI应用榜单、大模型格局、企业采购变化,以及"消费者永不付费"的核心辩论与破局路径。

用Codex做生产监控:Grafana、K8s与安全全链路自动排障
基于 OpenAI Codex 的实战演示,拆解如何用 agentic 工作流处理 Grafana 指标异常、Kubernetes 级联故障和安全资源耗尽三类生产故障,把排障时间从一小时压缩到几分钟,并探讨从人在回路到全自动闭环的落地路径。

Cornerstone OnDemand如何用Amazon Bedrock将数据库诊断效率提升78%
Cornerstone OnDemand基于Amazon Bedrock和Strands Agents构建多智能体系统Orion AI,仅用三人团队在六个月内将数据库诊断时间缩短78%,从45分钟降至10分钟。本文解析其架构设计与可复用经验。