Inkling 2 Mini 登陆 Ollama:5.4B 模型如何实现深度推理

Inkling 2 Mini 通过中间层三次循环实现小参数深推理,现已登陆 Ollama 本地运行。
ThinkyMachines 的 Inkling 2 Mini 已登陆 Ollama,需升级至 0.40.17 预发布版使用。其核心设计是每个 token 三次循环通过中间层,以「循环深度」在仅 5.4B 激活参数下换取更强推理能力,兼顾本地部署的内存可控性。官方定位场景包括编程、computer use 等智能体工作流、视觉设计任务与金融应用,并以实时决策游玩 2048 的演示展示交互能力。接入方式为两条命令,32GB 以上内存 Mac 即可本地运行。文章也指出循环带来的额外计算开销可能推高单 token 延迟,复杂智能体任务的实际表现仍待社区实测。
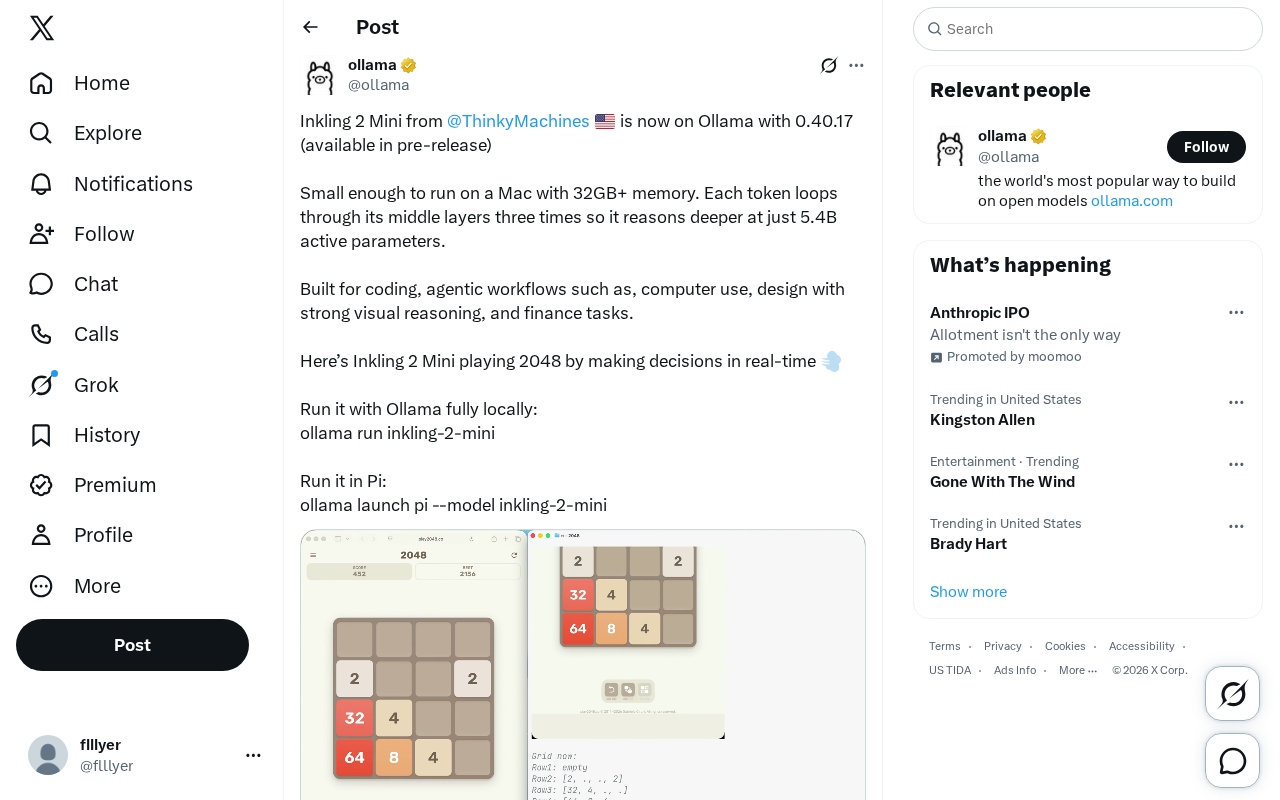
ThinkyMachines 推出的 Inkling 2 Mini 现已登陆 Ollama。据官方推文,用户需将 Ollama 升级至 0.40.17 预发布版本才能体验。这款模型主打「小体积、深推理」,在 32GB 内存的 Mac 上即可本地运行,官方演示中它甚至能实时决策游玩 2048 游戏。
核心设计:重复走中间层,用循环换深度
Inkling 2 Mini 最引人注目的设计,是每个 token 会三次循环通过其中间层。这种「循环深度」策略让模型在推理时反复咀嚼同一批中间表示,从而在仅 5.4B 激活参数的前提下获得更深层的推理能力。
传统做法往往靠堆参数换取能力,而 Inkling 2 Mini 的选择更像是在有限算力预算内,用计算步骤的重复来弥补参数规模的不足。对于本地部署场景,这意味着内存占用可控,同时保留了处理复杂任务所需的推理纵深。
激活参数指的是模型在一次前向推理中实际参与计算的参数量,而非模型权重总数。对于混合专家(MoE)架构来说,总参数量可能远大于激活参数量:每个 token 只路由到部分专家网络,因此只有被选中的专家参与运算。激活参数直接决定了单次推理的浮点运算量(FLOPs)和显存/内存带宽压力,是衡量推理成本的关键指标。5.4B 激活参数意味着每次计算涉及的权重规模约为 54 亿,这与 7B 级别稠密模型的计算开销相当,但若其总参数量更大,则模型容量仍然可观。理解这一区分有助于判断「小体积」究竟指存储占用、显存峰值还是单 token 计算量——三者并不等价。
循环深度(recurrent depth) 是一种让模型在推理阶段重复使用同一组层(通常是中间层)多次的计算策略,思想可追溯至 Universal Transformer 等工作。与标准 Transformer 每层只执行一次不同,循环深度模型对同一批隐藏状态迭代应用相同的权重,从而在不增加参数量的情况下增加等效计算深度。这相当于用「时间换空间」:参数量固定,但串行的计算步数增加。其代价是每个 token 的延迟随循环次数线性增长,且训练时需要处理展开后的计算图(可用截断反向传播控制显存)。这种设计常见于需要多步推理、算法式任务或迭代精炼的场景。
面向真实任务:编程、智能体与视觉推理
官方将 Inkling 2 Mini 的适用场景归纳为几类:编程、智能体工作流(如 computer use)、带强视觉推理的设计任务,以及金融场景。这些任务的共同点是需要多步判断和上下文理解,恰好对应模型「循环推理」的设计取向。
尤其说个细节 computer use 这类智能体场景——模型需要在动态界面中做出实时决策。推文中的 2048 演示正是这一能力的直观展示:模型不是一次性输出答案,而是在每一步操作中持续判断方向,最终完成游戏。
computer use 指让模型直接操作计算机图形界面的一类智能体能力:模型接收屏幕截图或可访问性树,输出鼠标点击、键盘输入、滚动等动作,从而在真实软件中完成任务。与调用 API 不同,computer use 要求模型具备视觉理解、界面元素定位、状态跟踪和错误恢复能力,且每一步动作都会改变环境,形成闭环决策。这类任务对延迟敏感,也对模型的规划稳定性要求很高——一次误点可能导致状态不可逆。正因如此,评测 computer use 通常采用多步任务成功率而非单步准确率。它也是「智能体工作流」中最贴近真实使用、同时最考验推理纵深的方向之一。
本地运行:一行命令与 Pi 集成
接入 Ollama 后,Inkling 2 Mini 的调用方式非常直接。官方给出两条命令:
ollama run inkling-2-mini:在 Ollama 中完全本地运行模型。ollama launch pi --model inkling-2-mini:在 Pi 环境中加载该模型。
硬件门槛方面,官方明确表示 32GB 以上内存的 Mac 即可运行,这让不少个人开发者和小型团队无需云端 GPU 也能试验推理型模型。需要注意的是,当前版本仍需预发布版 Ollama 支持,正式版用户可能需要等待后续更新。
Ollama 是一个开源的本地大模型运行与分发工具,通过统一的命令行接口拉取模型权重、管理量化版本并在本地 CPU/GPU 上推理。它内置了针对不同硬件的后端(如 macOS 上的 Metal),并对模型做了量化打包,使用户无需手写推理代码即可运行。由于 Ollama 的模型库版本与运行时版本存在兼容约束,新架构模型往往需要较新的运行时支持,这也是本文提到必须升级到 0.40.17 预发布版的原因。预发布版意味着接口和格式仍可能变动,生产环境使用需谨慎评估。
小模型深推理的路线意义
Inkling 2 Mini 的发布折射出一个趋势:模型厂商开始在「参数效率」上做文章,而非单纯比拼规模。通过中间层循环换取推理深度,5.4B 激活参数的模型得以覆盖编程、智能体、视觉与金融等偏重逻辑的任务。
当然,「循环三次」带来的额外计算开销也意味着单 token 延迟可能上升,这对实时交互场景是一个需要权衡的点。2048 演示证明了可行性,但更复杂的智能体任务表现如何,仍有待社区实测。对本地部署爱好者而言,这款模型提供了一个值得尝试的新选项。
相关推荐
GTA VI 会是最后一款"纯人力"3A大作吗?
GTA 6 被称为"最后一款同类游戏"究竟意味着什么?本文解读视频观点:它指的是数千人不用 AI、倾全公司之力打造的历史性作品,而非大预算游戏的终结,并以塞尔达时之笛重制版作为低成本高品质的反例。

物理约束新方法:让AI模型更可靠地预测混沌系统
一项新方法通过强制物理约束,解决AI模型预测混沌系统时违背物理规律的问题,提升天气、气候和湍流预测的可靠性,推动物理一致的AI建模发展。

好点子不该等对人:In Good Company 之夜谈创始人行动力
In Good Company 晚间活动聚集创作者、思想领袖与创始人,讨论好点子为何不该卡在等待合适人选上,以及小团队与独立创作者如何用最小可行方式先行启动。