Intel GPU D系列发布:无HBM也能实现大显存AI推理

英特尔D270以无HBM大容量显存切入智能体与长上下文推理市场。
英特尔在Product Hunt悄然发布数据中心GPU D270,主打“无HBM的大容量显存推理”,瞄准智能体AI、长上下文和高并发服务场景。文章指出,推理负载更关注显存容量、并发能力和单位功耗成本,而HBM容量扩展成本高、产能集中,无HBM方案在推理性价比和供应链韧性上具备潜在优势。D270的定位反映AI芯片正从“一张卡打天下”走向按负载分化。但其显存带宽、软件栈成熟度等关键参数尚未披露,实际推理性能与生态迁移成本仍有待验证,发布渠道也透露出试探意味。
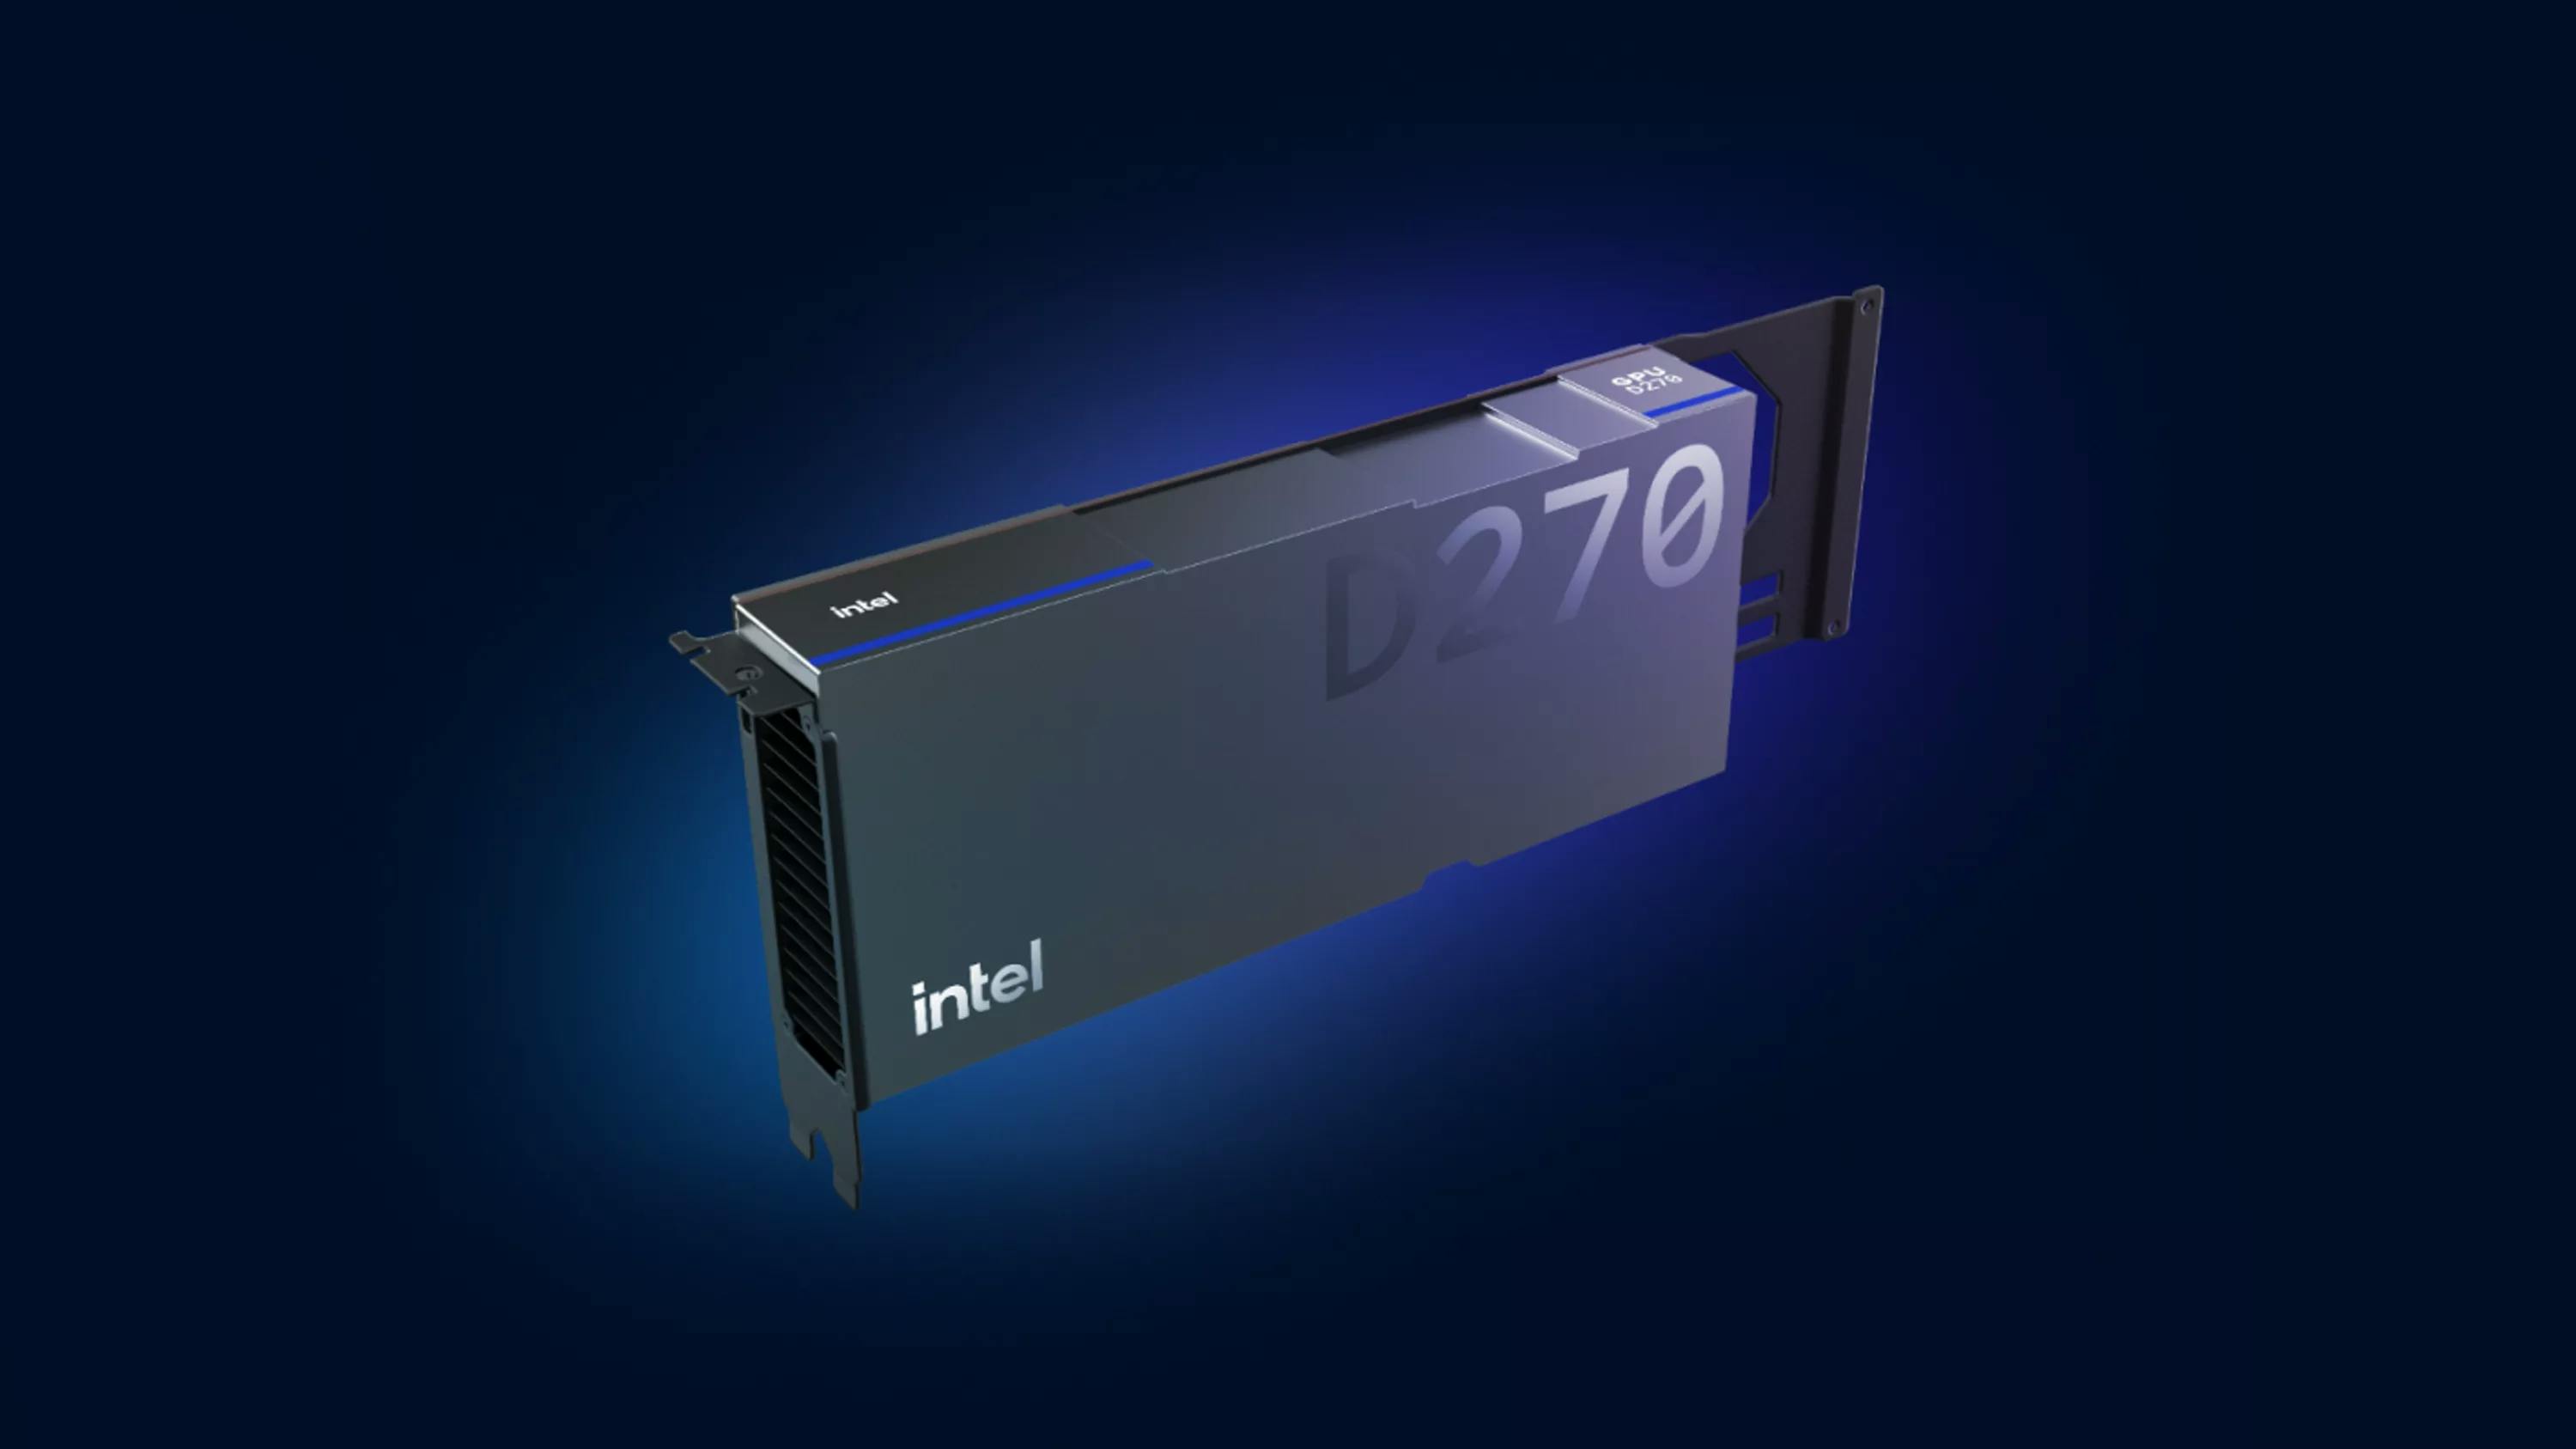
英特尔在Product Hunt上悄然发布了一款颇具针对性的数据中心GPU——D270。这款产品没有追求HBM(高带宽内存)的极致带宽,而是主打“无HBM的大容量显存推理”,目标直指智能体AI、长上下文和高并发服务场景。在HBM供应紧张、成本高企的当下,这个思路值得细看。
为什么“无HBM”反而成了卖点?
当前主流AI加速卡几乎言必称HBM,从H100到MI300,HBM的带宽优势确实让训练性能突飞猛进。但推理场景的需求曲线与训练并不相同。推理更关注的是:能否把足够大的模型和足够长的上下文装进显存,以及单位功耗下能服务多少并发请求。
HBM的痛点在于容量扩展成本极高。每GB HBM的价格远高于GDDR或LPDDR,而且封装工艺复杂、产能集中。对于大量部署推理节点的企业来说,显存容量往往比峰值带宽更影响总拥有成本。Intel D270选择绕开HBM,用更成熟的显存方案堆出大容量,本质上是一次针对推理经济性的重新权衡。
官方描述中反复强调“practical power and cost”(实用的功耗与成本),说明这款产品并不打算在训练市场与H100正面竞争,而是想在推理基础设施的性价比区间里切一块蛋糕。
HBM(High Bandwidth Memory,高带宽内存)是一种通过硅通孔(TSV)垂直堆叠DRAM芯片、并与GPU/加速器裸片通过硅中介层紧邻封装的内存技术。相比传统的GDDR或LPDDR,HBM能在极小的物理面积内提供数倍甚至数十倍的带宽,同时显著降低每比特传输的功耗,这正是H100、MI300等训练卡能在数据吞吐上突飞猛进的关键。但代价也很明显:HBM需要2.5D/3D先进封装,产能高度集中于少数存储厂商,每GB成本远高于普通显存,且容量扩展往往受限于单颗容量与封装可容纳的堆叠数。理解这一点,才能明白为何“绕开HBM、用成熟显存堆容量”在推理场景下是一种有意识的经济性取舍,而非简单的技术降级。
D270的定位:智能体与长上下文
智能体(Agentic AI)是近两年最明确的推理负载增长点。一个智能体工作流往往需要多轮工具调用、状态维护和长对话记忆,对显存的占用远超单轮问答。长上下文同理——当上下文窗口从8K扩展到128K甚至更长时,KV Cache的显存开销呈线性增长,显存容量直接决定能支持多长的上下文和多高的并发。
D270把这两个场景写进产品定位,说明英特尔对推理负载的观察是具体的。高并发服务则进一步指向了实际部署中的吞吐量问题:单卡显存越大,能同时驻留的请求就越多,单位时间内的服务能力越强。
这里的关键问题是,无HBM方案的实际带宽能否支撑这些场景的延迟要求。大显存解决了“装得下”的问题,但“跑得快”仍需实测数据验证。英特尔目前披露的信息有限,这也是D270最需要观望的部分。
KV Cache(键值缓存)是理解长上下文显存开销的关键。在Transformer推理中,模型会对已生成的每个token缓存其Key和Value向量,避免重复计算,从而把自回归解码从O(n²)降到近似线性复杂度。但代价是缓存大小随上下文长度和并发请求数线性增长:序列越长、同时在线的请求越多,占用的显存就越大。以70B级模型为例,128K上下文下单请求的KV Cache就可能达到数GB量级,高并发时累积开销非常可观。因此,在长上下文和高并发服务中,显存容量往往比峰值带宽更早成为瓶颈,这也正是D270强调大容量显存的现实依据。
推理芯片的路线分化
D270的出现反映了一个更大的行业趋势:AI芯片正在从“一张卡打天下”走向按负载分化。训练芯片追求极致带宽和互联,推理芯片则开始分层——有的追求低延迟,有的追求大容量,有的追求低功耗。
无HBM推理卡并非英特尔首创,但由一家具备完整数据中心生态的厂商来推,意义不同。英特尔在CPU侧有至强产品线,在网络和软件栈上也有积累,如果D270能与现有基础设施形成协同,对预算敏感、负载以推理为主的客户会有吸引力。
另一个不可忽视的背景是HBM的供应格局。HBM产能长期被少数厂商把控,交期和价格波动大。一条不依赖HBM的推理产品线,在供应链韧性上具备天然优势,这对需要大规模铺量的推理集群来说是个实际考量。
总拥有成本(TCO)是数据中心采购推理卡时的核心衡量指标,通常包括硬件购置、电力消耗、机架空间、冷却以及运维人力等全生命周期费用。推理集群往往需要大规模铺量部署,单卡成本与功耗的微小差异会被集群规模放大,因此“单位功耗下能服务多少并发请求”比“峰值算力多高”更能影响实际账单。无HBM方案用成本更低的显存换取更大容量,若能以可接受的延迟支撑目标并发,就能在TCO上形成优势。这也解释了为何推理芯片会出现按“容量优先”“延迟优先”“功耗优先”等不同维度分层的趋势。
需要回答的问题
D270目前公开的信息仍然偏少。显存具体容量、带宽参数、支持的模型精度、软件栈成熟度,这些决定实际可用性的指标都还没有完整披露。Product Hunt上72票、1条评论的热度也说明它尚未进入主流讨论视野。
对开发者而言,最关心的莫过于软件生态:是否兼容主流推理框架,编译器工具链是否成熟,现有模型迁移成本多高。英特尔过去在GPU软件栈上吃过亏,D270能否避开同样的坑,比硬件参数更值得关注。
从产品策略看,D270选择在Product Hunt发布而非传统数据中心产品渠道,本身也透露出一种试探意味——先看看开发者社区的反应,再决定后续投入节奏。这款产品能否成立,最终取决于实测的推理性价比,以及英特尔愿意在软件生态上投入多少耐心。
相关推荐

“黑色十月”:AI挖出史上3%严重漏洞?
Reddit 热帖称过去一个月发现了史上 3% 的严重软件漏洞,被称为「黑色十月」。本文拆解这一说法的统计口径问题,分析 AI 辅助代码审计如何加速漏洞发现,以及开发者和企业该如何应对补丁窗口缩短的挑战。

微软Project Gecko:用AI为非洲农民架起语言桥梁
微软Project Gecko项目推出PharmaChat应用,让非洲农民用母语提问,通过AI返回精准视频片段和农耕书籍章节。项目还发布三个交互式手册,推动包容性AI发展。

Node.js语音笔记App:语音转文字API选型指南
为Node.js语音笔记应用选择语音转文字API?对比AssemblyAI、Deepgram、Google Cloud和Whisper的免费额度、定价与Node集成体验,给出分阶段选型建议。