Intel MacBook跑本地大模型:400行Python管理面板实测

400行Python面板加llama.cpp,让被遗忘的Intel Mac纯CPU跑起本地小模型。
文章介绍B站UP主开发的LLM Panel:一个约400行、零第三方依赖的Python工具,通过本机源码编译llama.cpp v0.9.0,为被生态遗忘的2016至2020年Intel版MacBook提供本地大模型运行方案。纯CPU跑1.7B量化模型可达每秒22个Token,长文档预填充每秒140个Token,内存占用仅1.1GB,软件成本为零。方案具备多实例、并发排队、嵌入模型支持、看门狗等能力,并借llama-server天然兼容OpenAI接口。实测显示批处理调大与KV缓存前缀复用收益明显,Flash Attention在CPU上基本无差别;短板是长上下文等待久、发热降频掉速、70亿参数以上不宜硬扛。作者按内存给出分档选型建议,前提是CPU支持AVX2。
2026年,老Intel MacBook还能干什么?一位B站UP主给出的答案是:跑本地大模型。他为此写了一个约400行的Python小工具LLM Panel,搭配llama.cpp引擎,在纯CPU上让1.7B量化模型跑出每秒22个Token的生成速度。这个数字不算炸裂,但足以覆盖日常对话。
被生态遗忘的群体
据UP主介绍,Intel版MacBook从2016年到2020年生产了整整五年,全球保有量巨大,内存覆盖8到64GB,CPU从双核i5到8核i9。但2026年的本地大模型工具生态基本把它们忘了:下载页面默认按钮全是Apple Silicon,Intel版本要么藏在角落,要么更新停滞。
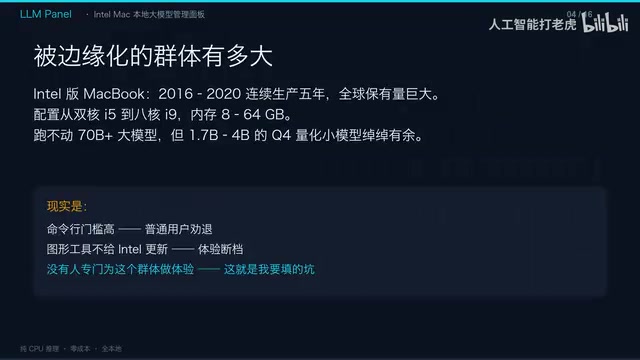
命令行工具门槛高,图形工具又不给更新,于是这个群体被卡在中间。LLM Panel要填的就是这个坑:把下载、量化、加载、卸载、对话、接口这些操作,变成点一下就能完成的事。
四个关键数字
UP主用四组数据概括了方案定位:
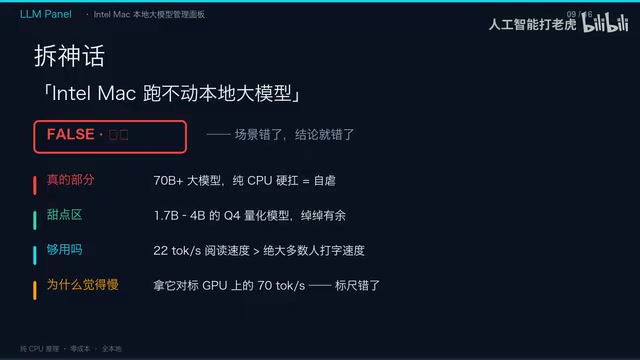
- 1.7B模型纯CPU生成速度每秒22个Token,日常对话完全够用,这一速度已超过大多数人的打字速度;
- 长文档处理速度每秒140个Token,万字材料一分钟出头就能过一遍;
- 1.1GB内存占用,跑一个1.7B量化模型只需这么多;
- 0元软件成本,开源引擎、开源模型、自己写的面板。
需要说明的是,这里的每秒22个Token是对标GPU上每秒几十个Token得出的感受差异。UP主的观点很直接:觉得慢,是因为场景错了——拿CPU小模型去对比GPU大模型,结论自然失真。
Token 是模型处理文本的基本单位,大约相当于 0.5 到 0.75 个英文单词,中文一个字通常占 1 到 2 个 Token。所谓"每秒 22 个 Token",指的是模型自回归生成时每秒钟能吐出多少个 Token——由于每次只生成一个 Token 并把它拼回输入再算下一次,这个速度直接决定了用户看到的"打字"节奏。人类正常阅读速度约为每秒 5 到 8 个 Token,打字速度更低,因此 22 Token/s 已能让对话感知接近流畅。而长文档处理时的 140 Token/s 属于**预填充(prefill)**阶段速度,该阶段一次性并行处理整段 Prompt,不吃逐 Token 循环的开销,所以远快于生成阶段,但总量大时仍需等待。
引擎怎么来的
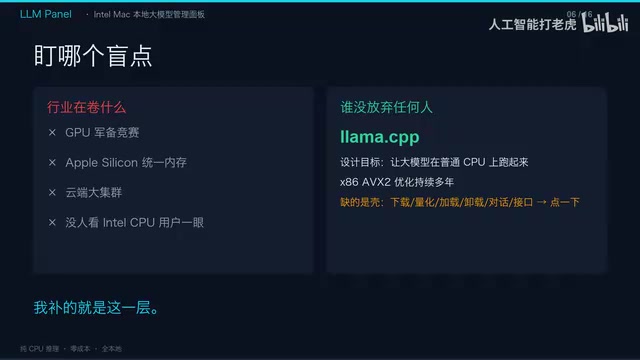
LLM Panel本身不负责推理,推理交给llama.cpp。面板从GitHub拉取llama.cpp最新正式版v0.9.0源码,在本机源码编译——不是下载别人编译好的二进制,而是让编译器针对本机CPU原生优化,AVX2指令集、FMA融合等全部按本机能力生成。
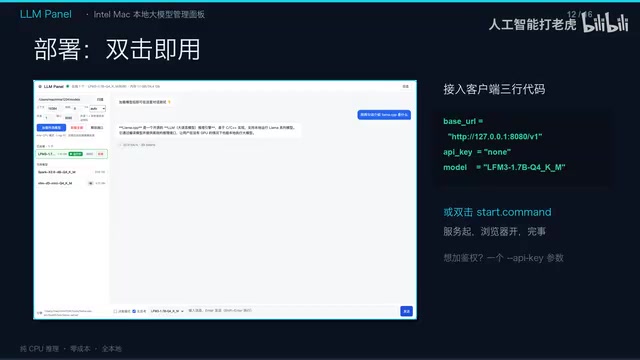
编译产出两个二进制:llama-cli命令行和llama-server服务器。llama-server天生兼容OpenAI接口,这意味着后续接入任何客户端都只是改一个网址的事。
面板的几项核心能力
- 多实例:一个模型一个进程一个端口,不同模型可同时在线互不干扰;
- 并发控制:并发数设为1,多余请求自动排队,长任务不会互相踩踏;
- 嵌入模型支持:非生成式模型走专门的嵌入接口一样能用;
- 看门狗与健康检查:引擎日志、内存水位全部显示在界面里。
右侧对话界面直接复用llama-server自带的网页端,左侧选模型、右侧直接聊,底部状态栏实时显示模型在线状态、端口占用和内存消耗。点一下加载,两秒模型就绪;点卸载,干净退出。
llama.cpp 是一个用 C/C++ 编写的开源大语言模型推理引擎,由 Georgi Gerganov 于 2023 年发起。它的核心设计目标就是让 LLM 推理摆脱对高端 GPU 的依赖:通过手写 SIMD 内核(在 x86 上对应 AVX2/AVX-512,在 ARM 上对应 NEON),把矩阵乘法等运算直接映射到 CPU 向量指令上,从而在纯 CPU 环境获得可用的推理速度。它同时支持 gguf 格式的量化权重(Q4、Q5、Q8 等),把模型体积压到原始 fp16 的四分之一甚至更低,这也是 1.7B 模型只需 1.1GB 内存的原因。llama.cpp 内置的 llama-server 对外暴露 OpenAI 风格 HTTP 接口,因此面板本身不必实现推理逻辑,只需管理进程与端口。
性能对照实验
UP主做了几组对照实验,结论有反直觉之处:
- Flash Attention开关:开启与关闭分别对应每秒13800和14000个Token(此处为UP主原始表述),基本无差别。在CPU上它不是瓶颈,别迷信开关。
- 批处理大小:从512提到4096并开启批处理线程,吃满12个逻辑核,提速约11%,属于免费性能。
- KV缓存前缀复用:这是最有效的一项。连续对话中相同前缀直接复用,只重算新增部分。省时间的大头在缓存,不在算力。
KV 缓存前缀复用(prompt caching) 的原理是:Transformer 在生成每个 Token 时都要对全部历史 Token 计算注意力,为省去重复计算,推理引擎会把每层注意力的 Key 和 Value 张量缓存下来,即 KV 缓存。多轮对话中,历史前缀完全不变,只需为新输入的那几个 Token 补算 KV,再复用旧缓存即可,省下的正是最耗时的预填充部分。这也解释了为什么"省时间的大头在缓存,不在算力"。llama.cpp 通过 --prompt-cache 或 server 模式的 slot 机制实现该能力,对连续追问、长文档反复问答等场景收益尤为显著。代价是 KV 缓存本身占用内存,上下文越长、层数越多,占用越大,需与内存水位一并权衡。
三条护城河与三盆冷水
这套方案的差异化在于三点:零依赖,整个面板只用Python标准库,不装任何第三方包;全本地,服务只监听本机回环地址,模型权重、对话内容、日志一个字节都不出网;接口标准,OpenAI兼容意味着任何客户端、任何自动化脚本只需改一个网址。
冷水同样要泼:
- 长上下文是真疼。CPU处理Prompt的速度是每秒140个Token,数万字材料需要等待数分钟,期间没有输出,像卡死,其实是在真算。
- 速度会波动。系统负载高、机器发热降频时,速度可能掉到四分之一。
- 70亿以上参数的模型别碰。纯CPU硬扛大模型不体面,这个方案的定位就是小模型、快响应、全本地。
按内存对号入座
UP主给出的配置建议相当具体:
- 8GB内存的老Air:能跑1.7B,流畅;
- 16GB:4B以下随便挑,这是最舒服的一档;
- 32GB:像UP主那台i7六核十二线程,多实例随便挂,还能留一半内存干别的;
- 更老的2013、2014年前后的机型:能跑,但建议2B以下。
前提只有一个:CPU支持AVX2指令集。据UP主说法,2013年之后的Intel芯片基本都支持。此外还有五条实践判断——模型选1到40亿参数的Q4量化版;上下文长度按需给,一万六千足够日常;简单任务开无思考模式跳过思维链;并发设为1让请求排队;盯住内存水位,32GB机器同时挂三个小模型没问题,再多就要挑着卸载。
AVX2(Advanced Vector Extensions 2) 是 Intel 自 Haswell 架构(2013 年)起引入的 256 位 SIMD 指令集扩展,一次可对 8 个 32 位浮点数或 32 个 8 位整数并行运算,是 CPU 上跑量化模型的关键加速手段;FMA(融合乘加)则把乘法和加法合并为一条指令,进一步减少运算轮次。llama.cpp 在编译时会探测本机支持的指令集并生成对应内核,若 CPU 不支持 AVX2,就只能退回 SSE 等更窄的指令路径,速度会明显下降,甚至部分量化格式无法运行。因此"CPU 是否支持 AVX2"实质上是这套方案能否成立的门槛,这也解释了为什么作者坚持源码本机编译,而非直接分发二进制。
值得关注的信号
这个项目的意义不在性能数字,而在它揭示了一个被忽视的事实:技术圈追逐GPU、追逐统一内存、追逐云端集群,但llama.cpp这类项目从未放弃任何一块CPU,X86的AVX2优化做了好几年。缺的只是一个把门槛降下来的壳。
对于手上还有Intel Mac的用户,这是一条零成本、全本地的小模型路线;对于开发者,它示范了如何用几百行标准库代码盘活一个被生态遗忘的硬件群体。旧硬件不是不能站,只是没人给它一个好用的界面。
相关推荐

Aircad:浏览器里的专业制图与3D建模新选择
Aircad在Hacker News展示浏览器端专业制图与3D建模能力,探索无需安装的CAD工作流。本文分析其定位、潜在优势与早期项目的不确定性。

AI做新闻,受众为何不买账?
AI正成为信息入口,但受众仍抵触AI生产新闻。本文分析信任赤字根源、信息入口与内容生产的边界,以及对媒体机构AI化的现实启示。

律所如何用AI重塑法律业务?Gilbert + Tobin的实践
澳大利亚律所Gilbert + Tobin合伙人兼CEO Sam Nickless谈律所如何用AI重新思考法律业务模式,从效率工具走向业务逻辑重构,以及CEO层级介入AI战略的意义。