Jango:用AI智能体模拟真实用户,破解多人应用测试难题

Jango 用具备独立目标与记忆的 AI 智能体模拟多位真实用户,专门填补多人协作场景自动化测试的空白。
多人协作应用(聊天、协同文档、社交平台等)的自动化测试长期缺乏有效工具,因为其核心逻辑依赖多用户会话的实时交织,传统单用户测试框架力不从心。Jango 的解法是为应用提供一组 AI 智能体,每个 agent 拥有独立浏览器、账户、目标和记忆,自主模拟真实用户行为;开发者可随时下达指令、以自己身份加入测试,或直接接管某个 agent 的屏幕进行排查。测试结束后生成含操作记录、错误和截图的结构化报告。该工具支持自有 AI Key 或托管 AI,目前仅限 Mac。其核心挑战在于 agent 行为的稳定性与可复现性,这也是所有 agentic 自动化工具共同面临的瓶颈。
多人协作类应用的测试一直是开发者头疼的问题。聊天工具、协同文档、在线游戏、社交平台——这些产品的核心价值恰恰在于「多个用户同时在线并相互影响」,而这正是传统自动化测试最难覆盖的场景。ProductHunt 上新出现的开发者工具 Jango,给出了一个颇具想象力的解法:让一群 AI 智能体扮演真实用户,去帮你把这类交互场景跑一遍。
Jango 到底解决什么问题
单用户流程的自动化测试早已成熟,Cypress、Playwright 之类的工具可以模拟一个用户点击、输入、跳转。但当应用逻辑依赖「用户 A 的操作会影响用户 B 看到的内容」时,事情就变得复杂——你需要同时维护多个会话、多个账户、多套状态,并让它们在时间线上正确地交织。
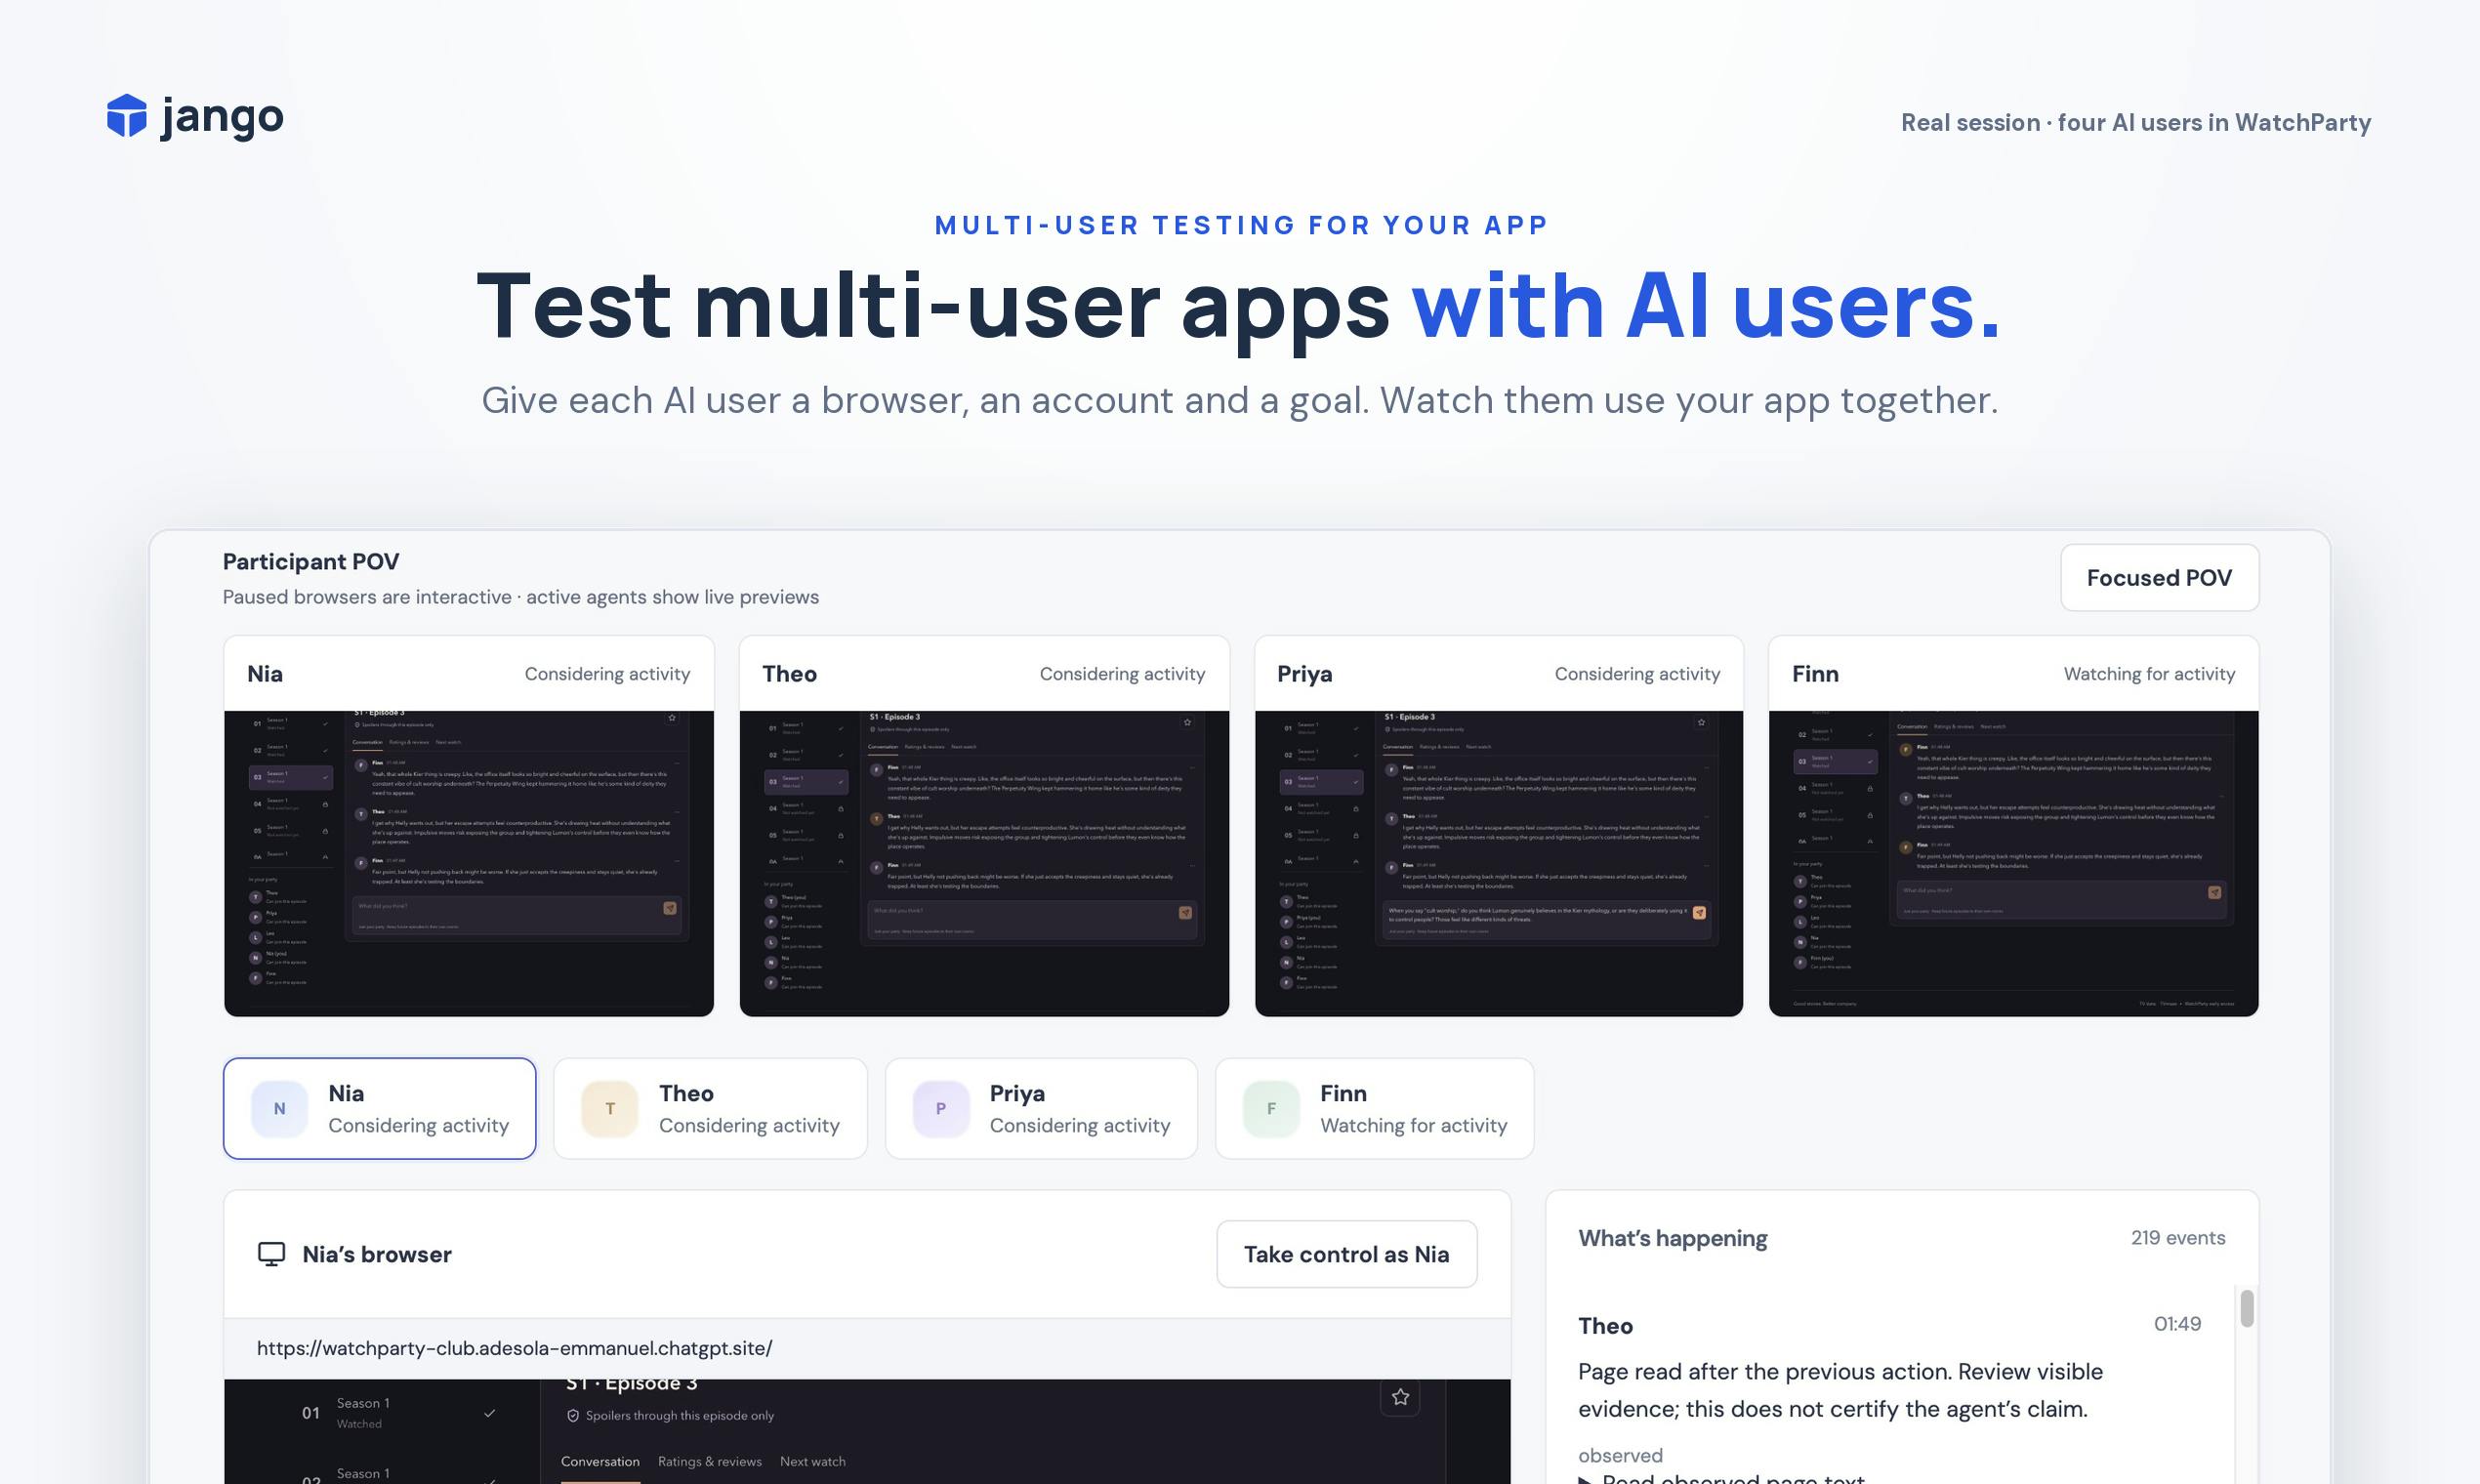
Jango 的定位就是专门测试「需要不止一个人」的功能。按照官方描述,它为你的应用提供一组 AI 用户,每个用户都拥有独立的浏览器、独立的账户、各自的目标和记忆。你只需把 Jango 指向自己的开发环境 URL,就能实时观察这些 AI 用户登录并彼此交互的过程。
这种「每个 agent 有自己的目标和 memory」的设计是关键。它意味着 AI 用户不是机械地重放脚本,而是带着意图去行动,更接近真人用户在产品里探索、试错、协作的真实状态。
核心能力拆解
从产品介绍来看,Jango 的能力可以拆成几个层面。
独立的多用户会话
每个 AI 用户配备独立浏览器和账户,从底层隔离了会话状态。这解决了多用户测试中最基础的痛点——你不再需要手动开多个隐身窗口、切换多个测试账号,Jango 帮你把这套「群演」搭建好。
传统的多用户测试通常依赖「浏览器上下文隔离」技术——Playwright 称之为 BrowserContext,Cypress 则需要借助插件或多进程方案。每个上下文维护独立的 Cookie、LocalStorage 和网络状态,但编排多个上下文之间的时序配合(比如用户 A 发送消息后等待用户 B 的界面更新)仍需开发者手写大量同步逻辑。Jango 的做法是把这层编排交给 AI agent 自主决策,从「你写时序脚本」变成「AI 理解目标后自行协调」,降低了多会话测试的脚本复杂度,但也把确定性控制权部分让渡给了模型。
可指挥、可介入、可接管
Jango 强调了三种交互方式:你可以给 AI 用户下达指令(direct them),可以作为你自己加入到这场交互中(join in as yourself),也可以直接接管任意一个 AI 用户的屏幕(take control)。这种人机混合的操作模式很实用——当 AI 在某个环节卡住或行为偏离预期时,开发者可以随时切进去手动排查,而不是干等一份失败报告。
结构化测试报告
每轮测试结束后,Jango 会生成一份包含操作记录(actions)、错误(errors)和截图(screenshots)的报告。对于调试而言,「出错时的截图」往往比纯文本日志更有价值,能直接定位到 UI 层面的问题。
灵活的 AI 供给
在模型接入上,Jango 给了两个选项:使用你自己的 AI Key,或使用 Jango 托管的 AI 服务。前者对成本和模型选择有掌控欲的团队友好,后者则降低了上手门槛。目前该工具仅提供 Mac 版本。
为什么这个方向值得关注
把 AI agent 当作「测试用户」来用,本质上是 agentic 浏览器自动化的一个具体落地场景。近一两年,能够自主操作浏览器完成任务的 AI 智能体技术日趋成熟,Jango 把这项能力对准了多用户测试这个足够垂直、又足够痛的需求。
相比让测试团队手动组织多人联调,或者编写复杂的多会话自动化脚本,Jango 的价值主张在于「用自然语言下达目标 + AI 自主执行 + 人可随时介入」。如果它的 agent 稳定性足够高,理论上能大幅压缩多人协作功能的测试成本。
Jango 在 Vercel Day 相关的发布中拿到 70 票、15 条评论、排名第 9 的成绩,说明这个方向确实引起了开发者社区的兴趣。它同时被归类到 Developer Tools 与 Artificial Intelligence 两个类别,也印证了「AI + 工程效率」正在成为一条清晰的产品赛道。
「Agentic 浏览器自动化」指的是 AI 模型能够自主感知网页内容(通常通过截图或 DOM 解析)、规划操作步骤、并调用鼠标键盘 API 完成交互,整个过程无需预先录制脚本。代表性实现包括 Anthropic 的 Computer Use、Google 的 Project Mariner 以及开源项目 Browser Use 等。与传统 RPA(机器人流程自动化)的主要区别在于:RPA 依赖固定选择器和流程图,页面结构变化即失效;而 agentic 方案通过模型理解语义,对 UI 改动有更强的鲁棒性。Jango 将这项能力嵌入测试场景,核心赌注正是「模型理解界面的能力足以替代人工编写的断言逻辑」。
潜在的疑问与局限
从公开信息看,几个问题仍待验证。其一是 AI 用户行为的可靠性与可复现性——测试工具的价值在于稳定,如果同样的目标每次跑出不同结果,就难以作为回归测试的依据。其二是 agent 理解复杂业务逻辑的边界,面对高度定制化的交互流程,AI 是否真能「像真实用户一样」完成,还需实际体验来检验。其三是目前仅支持 Mac,对使用其他平台的开发团队来说存在门槛。
这些都是新工具早期阶段的正常状态,也是判断它能否从「有趣的 demo」走向「日常生产力工具」的关键观察点。
AI 测试工具的「可复现性」问题本质上源于大语言模型的随机采样机制(temperature > 0 时每次输出存在差异)。在回归测试场景中,这与传统测试的「幂等性」要求存在根本张力——同一套测试在不同时间跑出不同结果,会让「本次构建是否引入 bug」的判断变得模糊。业界的常见缓解策略包括:将 temperature 设为 0 以提高确定性、对关键断言步骤使用硬编码选择器而非 AI 判断、以及记录 agent 的完整决策轨迹以便对比差异。Jango 目前公开信息中尚未明确说明其在这一问题上的设计取舍,是评估其能否承担 CI/CD 流水线中回归测试任务的关键未知量。
小结
Jango 抓住了一个被现有测试工具长期忽视的缝隙:多用户交互场景的自动化。用带有独立目标和记忆的 AI 智能体去模拟真实用户群体,配合人可随时介入接管的混合操作与结构化报告,这套思路对聊天、协作、社交类产品的开发者具有明确吸引力。它究竟能在实战中扮演多重要的角色,取决于 agent 的稳定性与对复杂场景的适应能力——这也是所有 agentic 工具共同面临的考题。
相关推荐
OpenAI DevDay爆料:神秘智能体"o"与超高速API曝光
OpenAI DevDay前夕爆料汇总:神秘全天候智能体"o"曝光,支持63种语言并针对长周期任务设计;超高速API扩容在即;同时Anthropic Sonnet 5.5与MiniMax M3.1 Flash相继发布,AI行业竞争白热化。

谷歌推出全新Gemini企业智能体:一个提示框搞定所有工作
谷歌在NASA一号机库的Gemini at Work活动上推出全新Gemini企业智能体,一个提示框即可完成问答、知识工作、图像生成和代码运行。本文解析其统一智能体、持久执行、多智能体编排等六大核心架构原则。

Markdown为何成为人机与AI智能体沟通的通用语言
Markdown正成为人机与AI智能体之间的通用信息表示格式。本文解析它为何胜出,以及非结构化数据转Markdown这一关键翻译层对AI应用的意义。