Java+AI实战:搭建企业级航空智能客服系统

大模型能力趋于定型,AI应用开发成为新蓝海
当DeepSeek广告 V3.1、GPT-OSS等新模型陆续发布,许多开发者敏锐地发现一个趋势:大模型的性能提升已经明显放缓。正如本次课程中许书老师所指出的,最近这些新版本的评分甚至不一定超越之前的模型,大模型的能力基本上已经"定型"。
这一现象在业界被称为"Scaling Law瓶颈"。此前OpenAI等机构发现,模型性能与训练数据量、参数规模、计算量之间存在幂律关系(即Scaling Law),只要持续增加这三者,模型能力就能稳步提升。然而从2024年下半年开始,业界普遍观察到单纯增加参数和数据的边际收益在递减。高质量训练数据逐渐枯竭、训练成本指数级增长、以及模型架构本身的理论上限,共同导致了这一"天花板效应"。
Scaling Law(缩放定律)最早由OpenAI在2020年的论文《Scaling Laws for Neural Language Models》中系统性提出,研究发现模型性能(以交叉熵损失衡量)与模型参数量N、数据集大小D、训练计算量C之间呈现平滑的幂律关系。这一发现直接推动了GPT-3(1750亿参数)、GPT-4等超大规模模型的研发。然而到2024年,业界遇到了多重瓶颈:互联网高质量文本数据已被大规模爬取殆尽(据估计全球公开可用的高质量文本约为数万亿token,已接近上限);单次训练的电力成本已达数千万美元级别;同时Chinchilla论文指出参数量与数据量需要等比例扩展,进一步加剧了数据稀缺问题。这促使行业转向合成数据、强化学习对齐(RLHF/DPO)、推理时计算(Inference-time Compute)等后训练技术路线。
这也是为什么行业重心从预训练阶段转向后训练(Post-Training)优化和应用层创新的根本原因。
这意味着什么?当模型能力趋于稳定,行业竞争的焦点便从"造模型"转向"用模型"。一个孤立的大模型本身并不能产生盈利价值——它需要落地到具体的业务场景中,才能真正创造价值。因此,AI应用开发正在成为一个需求快速增长的方向。
对于占据企业开发主流的Java工程师来说,这是一个重要的信号:不必转行学Python去卷算法,而是可以在Java的基础上叠加AI能力,从而在求职市场上同时覆盖"Java开发"和"AI应用开发"两个岗位方向。

三类AI岗位对比:Java开发者该如何选择
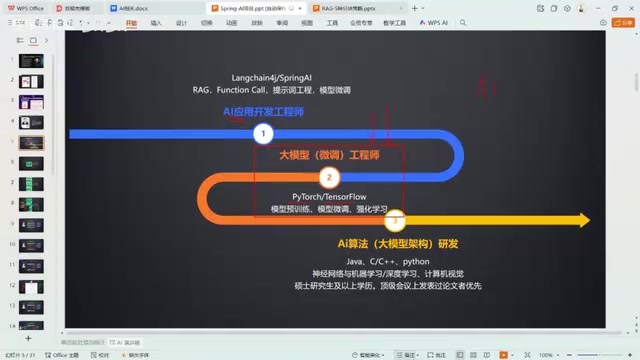
课程中对当前AI相关岗位做了清晰的分层,值得每一位想入局AI的开发者参考。
AI应用开发工程师:市场需求量最大
这是目前市场需求最旺盛的方向。开发者只需掌握如Spring AI等框架工具链,理解RAG(检索增强生成)、Function Calling、Tools、提示工程等核心技能,就能着手开发AI应用。
Spring AI是Spring官方在2023年底推出的AI应用开发框架,目标是为Java开发者提供与LangChain(Python生态)对等的AI应用开发体验。它遵循Spring一贯的设计哲学——通过抽象层屏蔽底层差异,开发者可以用统一的API对接OpenAI、Anthropic、Ollama、各类国产大模型等不同Provider。核心模块包括:Chat Client(对话客户端)、Embedding Client(向量化客户端)、VectorStore(向量存储抽象)、以及对Function Calling、RAG、Advisor(拦截器链)等模式的原生支持。对Java开发者而言,Spring AI最大的优势在于无缝融入Spring Boot生态,可以直接利用Spring Security、Spring Data、Spring Cloud等成熟组件构建企业级AI应用。
而企业级应用还需要具备稳定性,甚至互联网应用所需的"高并发、高可用、高性能"三高特性——这恰恰是Java最擅长的领域。
模型微调工程师:岗位需求有限
这个方向需要掌握Python及PyTorch、TensorFlow等深度学习框架。但现实是,一家公司真正需要微调的模型数量非常有限,且通常会配备专门的微调工程师,因此岗位需求相对较少。
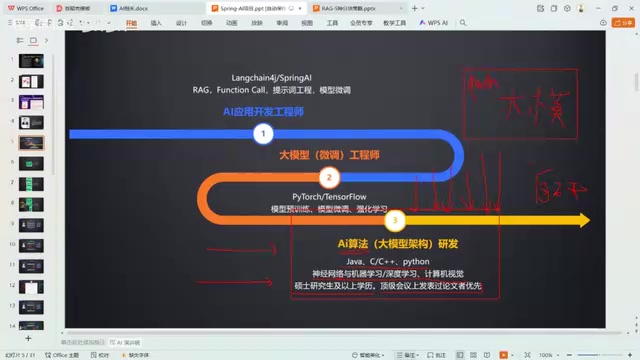
AI算法工程师:天花板最高但门槛极高
这是天花板最高的岗位,但也意味着极高的门槛:需要精通Java、C++、Python,掌握深度学习、机器学习乃至计算机视觉,甚至要求985/211硕博学历、发表过算法论文。课程中直言,对于普通本科出身、有几年Java开发经验的工程师,不建议从这个方向切入。更何况在开源大模型盛行的今天,很多模型都是基于Qwen(通义千问广告)等开源基座进行预训练和微调,自研大模型的需求进一步萎缩,这类岗位也随之减少。
结论很明确:对多数Java工程师而言,AI应用开发是性价比最高、最现实的切入点。
项目实战:用Spring AI重构传统航空票务系统
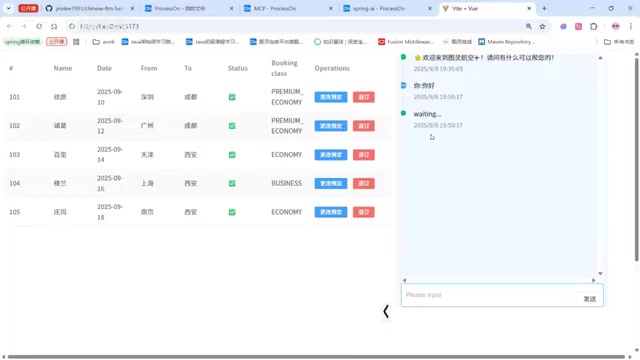
课程的核心是一个落地实战项目:将一个传统的航空票务系统,通过AI进行赋能,改造为智能客服系统。
这个改造思路极具代表性。传统系统基于"事件驱动"——用户必须点击按钮、点击链接才能完成查询和操作。而AI赋能后,用户可以通过自然对话完成系统中的所有操作。这也预示了一个更大的趋势:未来会有越来越多的传统系统被AI重构,或用AI赋能形成智能化的AI应用项目。
角色预设:赋予智能客服业务"人设"
当用户发送"你好"时,系统会回复"欢迎联系图灵航空公司"。这正是角色预设的作用——基础大模型(如直接使用DeepSeek)是不具备这种业务身份的,必须通过定制化的提示工程来实现。这也是企业级AI应用与通用聊天机器人的第一个本质区别。
角色预设在技术实现上通常通过System Prompt(系统提示词)完成。开发者在每次对话开始时,向大模型注入一段系统级指令,定义AI的身份、职责边界、话术风格和行为约束。例如:"你是图灵航空公司的客服代表,只回答与航班预订、退改签相关的问题,对无关话题礼貌拒绝。"这段System Prompt对用户不可见,但会持续影响模型的每一次回复。好的角色预设不仅包含身份定义,还应包含回答格式要求、敏感信息处理规则、以及异常场景的兜底策略。
Tools与Function Calling:让大模型调用业务API
项目中最关键的能力,是让大模型能够调用系统自身的业务方法。以退票为例,系统中存在一个 cancelBooking 方法,需要接收预定号和姓名两个参数。当用户在对话中表达退票意图并提供信息后,大模型通过 Tools(Function Calling) 机制调用该API,订单状态便从"已预定"变为"已取消"。
Function Calling的工作原理是:开发者在调用大模型API时,除了传入用户消息,还会传入一组"函数声明"(包含函数名、参数描述、参数类型等JSON Schema)。大模型在理解用户意图后,如果判断需要调用某个函数,会返回一个结构化的JSON对象,包含要调用的函数名和参数值。注意,大模型本身并不执行函数,它只是"决定"调用哪个函数并提取参数——实际的函数执行由应用程序完成,执行结果再返回给大模型进行最终回答的生成。这种设计让大模型能够安全地与外部系统交互,同时保持了应用层对业务逻辑的完全控制。
Function Calling虽然赋予了大模型与外部系统交互的能力,但也引入了安全风险。Prompt注入攻击(Prompt Injection)是最主要的威胁之一——恶意用户可能通过精心构造的输入,诱导大模型调用不应被调用的函数或传入恶意参数。因此企业级实现通常需要多层防护:参数校验层(验证大模型返回的参数是否在合法范围内)、权限控制层(确认当前用户是否有权执行该操作)、确认机制(对高风险操作如删除、支付等要求用户二次确认)。Spring AI通过Advisor机制提供了拦截器链,开发者可以在函数实际执行前插入自定义校验逻辑,类似于Spring MVC中的Interceptor或AOP切面。
这一步完成了从"对话"到"执行业务操作"的闭环,是AI真正落地业务的核心技术点。
RAG检索增强:让回答贴合真实业务规则
项目还实现了 RAG(检索增强生成)。例如,当用户询问退票政策时,系统能准确回答"退款将在七个工作日内处理""退票需在航班起飞前多少小时才能取消""取消后将收取多少费用"等信息。这些内容并非模型凭空生成,而是从企业自身的业务知识库中检索得到,确保回答的准确性与合规性。
RAG的具体技术流程包括:1)将企业文档(如退票政策文件、常见问题手册等)通过Embedding模型转化为高维向量并存入向量数据库(如Milvus、Pinecone、Chroma、PGVector等);2)用户提问时,将问题同样转化为向量,在向量数据库中进行相似度检索(通常使用余弦相似度或内积距离);3)将检索到的Top-K最相关文档片段拼接到Prompt中作为上下文;4)大模型基于这些真实信息生成回答,而非依赖训练时记忆的可能过时或不准确的知识。RAG有效解决了大模型"幻觉"问题——即模型一本正经胡说八道的现象,确保每一个回答都有据可查。
向量数据库中的相似度检索是RAG系统的核心环节。Embedding模型(如OpenAI的text-embedding-3、BGE等)将文本映射到高维向量空间(通常768-3072维),语义相近的文本在向量空间中距离更近。检索时使用的ANN(Approximate Nearest Neighbor,近似最近邻)算法包括HNSW(Hierarchical Navigable Small World)、IVF(Inverted File Index)等,能在毫秒级别完成百万级向量库的检索。在实际工程中,还需要考虑文档分块(Chunking)策略——过大的分块会引入噪声,过小的分块会丢失上下文。常见的分块方法包括固定长度分块、按语义段落分块、递归字符分割等。此外,混合检索(Hybrid Search)结合稀疏检索(BM25关键词匹配)和稠密检索(向量语义匹配)通常能获得更好的效果。
企业级AI应用的完整技术栈解析
综合来看,这个航空智能客服项目覆盖了企业级AI应用开发的关键能力矩阵:
- 大模型接入:对接开源大模型作为底层能力
- 多轮对话与记忆:维持上下文连贯性
- 角色预设:定制业务身份与话术
- 对话拦截:过滤不合规或越界请求
- Tools/MCP:让大模型与业务系统API互动
- RAG检索增强:基于企业知识库进行精准回答
多轮对话的核心挑战在于上下文窗口(Context Window)的管理。大模型的上下文长度有限(如GPT-4o为128K tokens,DeepSeek为64K-128K tokens),长对话可能超出窗口限制。常见的记忆管理策略包括:滑动窗口(只保留最近N轮对话)、摘要压缩(用LLM对早期对话进行摘要)、以及基于重要性的选择性记忆。在Spring AI中,对话历史通过ChatMemory接口抽象,开发者可以选择InMemoryChatMemory(内存存储,适合开发测试)、JdbcChatMemory(数据库持久化)或自定义实现(如Redis存储以支持分布式部署)。对于企业级应用,还需要考虑多会话隔离、对话历史审计、以及用户隐私数据的脱敏处理。
其中MCP(Model Context Protocol,模型上下文协议)是Anthropic在2024年11月开源的标准协议,旨在解决大模型与外部工具/数据源之间的互联互通问题。在MCP出现之前,每个AI应用都需要为不同的工具编写定制化的集成代码,形成"M×N"的组合爆炸问题。MCP通过定义统一的通信协议,将工具提供方抽象为"MCP Server",AI应用作为"MCP Client",两者通过标准化的JSON-RPC协议通信。这类似于USB协议对外设的统一——任何符合MCP规范的工具都能被任何支持MCP的AI应用调用。Spring AI已经原生支持MCP协议,使得Java开发者可以方便地将业务系统暴露为MCP Server,或消费第三方MCP服务。
MCP采用Client-Server架构,通信基于JSON-RPC 2.0协议。MCP Server暴露三类核心能力:Tools(可执行的函数)、Resources(可读取的数据源)、Prompts(可复用的提示模板)。传输层支持两种模式:stdio(标准输入输出,适用于本地进程间通信)和HTTP+SSE(适用于远程服务调用)。MCP的生命周期包括:初始化握手(协商协议版本和能力)、能力发现(Client查询Server提供的Tools列表)、调用执行(Client发起tool/call请求)、结果返回。截至2025年,GitHub、Slack、数据库等多种服务已提供官方MCP Server实现,开发者可以像安装插件一样为AI应用增加新能力,大幅降低了集成成本。
除此之外,课程还强调了企业级AI应用开发中的痛点与难点——这也是真实项目与Demo的分水岭。一个能演示的对话框很容易搭建,但要做到稳定、可靠、能承载真实业务流量,才是工程化的真正挑战。
在AI应用场景下,"三高"挑战被进一步放大。高并发方面,大模型推理本身耗时较长(通常数百毫秒到数秒),如何在有限的GPU资源下支撑大量并发请求,需要异步流式输出(SSE/Server-Sent Events)、请求队列、限流降级等策略。高可用方面,当主力模型服务出现故障时,需要快速切换到备用模型(如从GPT-4o降级到GPT-4o-mini),这要求应用层具备模型路由和故障转移能力。高性能方面,RAG检索的延迟、Function Calling的多轮交互、对话历史的存储与加载都是性能瓶颈点。Java生态在这些方面有成熟的解决方案(如Spring WebFlux实现响应式编程、Redis缓存对话历史、Sentinel实现限流熔断等),这正是Java开发者做AI应用相较于Python开发者的独特优势。
写给Java工程师的转型建议
对于已经有几年经验的Java开发者,与其焦虑地转向Python算法赛道,不如在现有技术栈上叠加AI应用开发能力。这条路径既符合市场需求的实际走向,也能最大化利用已有的Java工程经验(尤其是对稳定性和三高架构的理解)。
当大模型能力趋于收敛,真正的价值将从"模型层"转移到"应用层"。谁能把大模型的能力工程化、落地到具体业务,谁就能抓住这一轮AI浪潮中最扎实的机会。而这套航空智能客服项目,正是一个可以完整复现的企业级实战范本。
核心要点
- 大模型能力已趋于定型:Scaling Law遭遇瓶颈,高质量数据枯竭与训练成本的指数增长共同导致模型性能提升放缓,行业重心从预训练转向应用层创新
- AI应用开发是Java工程师的最优切入点:相比门槛极高的算法工程师和需求有限的微调工程师,AI应用开发工程师市场需求最大,且能充分复用Java工程经验
- Spring AI框架降低了Java开发者的入门门槛:通过统一抽象层对接多种大模型Provider,原生支持Function Calling、RAG、MCP等核心模式,无缝融入Spring Boot生态
- Function Calling实现对话到业务操作的闭环:大模型负责意图理解和参数提取,应用层负责实际执行,在保持安全可控的前提下让AI驱动业务流程
- RAG检索增强解决大模型幻觉问题:通过向量化检索企业知识库,确保AI回答基于真实业务数据,而非模型训练时记忆的可能过时信息
- MCP协议统一了AI应用与外部工具的集成方式:类似USB协议的标准化效应,消除M×N的集成复杂度,Spring AI已原生支持
- 企业级AI应用的核心挑战是工程化:高并发(流式输出、限流降级)、高可用(模型路由、故障转移)、高性能(缓存优化、异步处理)正是Java生态的传统优势领域
相关推荐

Apple HomeView 上手评测:300美元智能家居中枢值不值?
Apple HomeView 上手体验:300美元智能家居中枢,支持面部识别快速切换账户,但缺乏App Store和语音识别,壁挂版性价比存疑。第一代产品是否值得入手?

Meta Muse Wonder 发布:重返前沿AI赛道的意义
Meta 发布 Muse Wonder 与 WonderFull 模型系列,基准测试跻身前沿,社区反馈两极分化。深度解析 Meta 重返前沿 AI 竞赛的意义、个人智能体战略与扎克伯格的不同路线。

Apple Home 智能家居新品首曝:LG 与施耐德联手,UWB 门锁加持
Apple Home 生态迎来 LG 与施耐德新品:UWB 智能门锁靠近解锁、2.5K 双摄门铃、隐私室内摄像头,以及类似 AirPods 的无缝配对体验。