Java后端进阶AI开发:Spring源码到Spring AI RAG实战
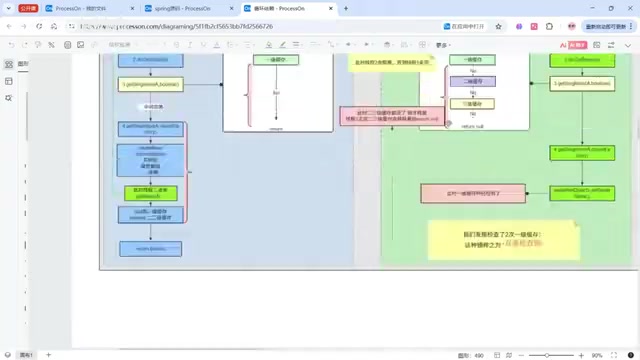
Java后端进阶AI开发:从Spring源码到Spring AI RAG的五段式工程化路线。
本文拆解了一套面向Java后端工程师的AI开发进阶教程。该教程采用五段式路线:先吃透Spring IOC与AOP源码、掌握Spring Boot自动配置原理,再补齐AI与Agent架构认知,最后用Java + Spring AI实战多模型切换、SSE流式对话、自定义Advisor拦截、企业API与MCP接入,并以RAG企业知识库压轴。文章强调,先修Spring内功并非多余——AI组件的装配、代理与排查都绕不开IOC容器与三级缓存等底层机制;而RAG部分直面分片策略、TopK瓶颈、回答溯源与增量清洗等生产问题,不停留在Demo层面。该路线适合有Java基础、想切入AI应用开发的后端工程师与大厂求职者,但不覆盖模型训练与算法调优。
Java后端进阶AI开发:Spring源码到Spring AI RAG实战
大模型应用开发不再是Python的专属领地。一套面向Java后端工程师的进阶教程,正试图把「只会调API」的尴尬局面翻篇——从Spring IOC/AOP源码、Spring Boot自动配置,一路讲到Spring AI、RAG知识库与Agent工程化落地。本文基于该教程的核心脉络,拆解这条五段式路线的技术逻辑与实战价值。
五段式路线:先修内功,再练招式
这套教程的设计思路很明确:不跳过Spring底层直接讲AI组件装配,否则线上排错会寸步难行。据B站该教程的介绍,完整路线分为五段:
- 吃透Spring IOC、AOP源码;
- 掌握Spring Boot自动配置原理;
- 补齐AI与Agent架构认知(不涉及Python算法);
- 用Java + Spring AI实战多模型切换、SSE流式对话、自定义Advisor、企业API与MCP外部能力接入;
- 压轴落地RAG企业知识库,覆盖分片策略、TopK瓶颈、回答溯源与增量清洗。
前两段是「内功」,是Spring AI组件能正确装配、线上能定位故障的前提;后三段是「招式」,把大模型能力真正嵌入Java工程体系。
为什么必须先啃Spring IOC源码
教程开篇花了大量篇幅讲Spring IOC与循环依赖,理由很实在:面试中Spring IOC和循环依赖几乎是必问项,占比高达百分之八九十。但更重要的原因是,AI组件的装配、代理、拦截,底层都绕不开IOC容器与AOP机制。
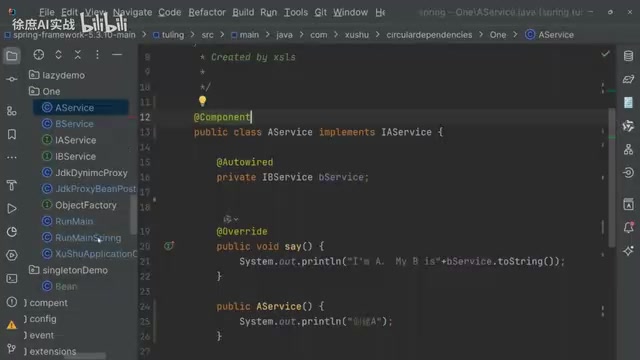
讲师从「自己new一个对象」与「从容器getBean」的区别切入:自己new的对象不会经过生命周期和依赖注入,而Spring Bean需要走完整个生命周期才能拿到完整对象。A依赖B、B依赖A时,双方都在创建过程中互相等待,循环依赖问题由此产生。Spring通过三级缓存解决了这一问题,但面试官往往会追问「二级缓存能不能解决」「多线程下如何保证安全」,这些连环问只有真正理解源码才能扛住。
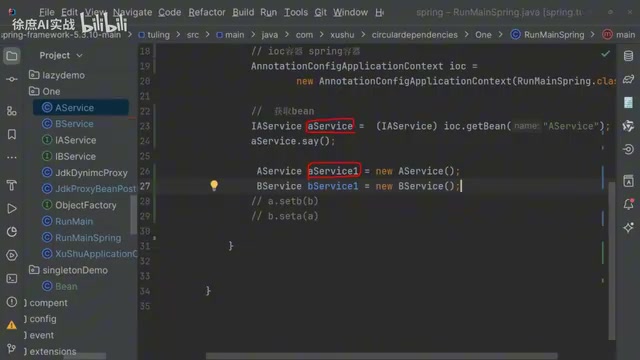
IOC容器加载的关键节点
教程把IOC容器加载拆成几个关键步骤:创建ApplicationContext后,首先读取Bean的定义信息(BeanDefinition),包括class、scope、lazy、dependenceOn等;这些定义信息被维护在BeanDefinitionMap中,key是Bean名称,value是BeanDefinition对象。
一个值得记住的排错信号:如果getBean时抛出「NoSuchBeanDefinition」异常,通常意味着Bean没有被扫描到。因为只要扫描到,就会生成对应的BeanDefinition。只有满足非懒加载、单例等条件的Bean,才会在容器加载时被真正创建。

实例化靠反射
Bean的实例化底层通过反射完成——BeanDefinition中已经保存了Bean的class对象,容器据此反射创建实例,再填充单例/多例等属性。理解这一点,才能明白为什么Spring AI的组件能被容器接管、被Advisor拦截。
Spring 解决循环依赖依赖的是「三级缓存」:一级缓存 singletonObjects 存放完全初始化好的 Bean;二级缓存 earlySingletonObjects 存放提前暴露的早期 Bean 引用;三级缓存 singletonFactories 存放用于生成早期引用的 ObjectFactory。当 A 依赖 B、B 又依赖 A 时,A 实例化后先把工厂放入三级缓存,再填充属性时发现需要 B,于是去创建 B;B 填充属性时回头取 A,就能从三级缓存拿到 A 的早期引用并升级到二级缓存,从而打破死循环。
面试常见的追问是「二级缓存够不够」。对普通 Bean 确实够用,但一旦涉及 AOP 代理,二级缓存就不行了:因为最终注入的应当是代理对象而非原始对象,三级缓存的工厂允许在需要时提前生成代理,而二级缓存只能存已经确定的对象。另一个追问是多线程安全,Spring 在 getSingleton 过程中会对 singletonObjects 加锁,保证同一时刻只有一个线程创建单例。
Spring AI实战:多模型、流式对话与外部能力
第四段进入AI工程化核心。教程强调全程用Java + Spring AI完成,而不是转向Python算法。覆盖的能力点包括:多模型切换、SSE流式对话、自定义Advisor对话拦截、企业API与MCP接入外部能力。
这些能力对应的是生产环境中的真实诉求:模型供应商需要可替换、对话体验需要流式输出、敏感内容需要拦截、企业既有系统需要被大模型调用。Spring AI的价值在于把这些能力纳入Spring的装配体系,而不是另起一套技术栈。
SSE(Server-Sent Events)是一种基于 HTTP 的服务端单向推送协议,响应头为 text/event-stream,服务端可以持续向客户端发送 data 事件,直到连接关闭。相比 WebSocket 的双向长连接,SSE 更轻量、天然兼容 HTTP 基础设施、断线可自动重连,因而成为大模型流式输出的主流方案:模型每生成一个 token 就推送一次,用户不必等整段回答生成完才看到内容。在 Spring 体系中,可以用 SseEmitter 或 WebFlux 的 Flux 返回流式响应,再交由 Spring AI 的流式 API 对接。理解 SSE 的帧格式、心跳保活与超时处理,是排查「回答卡住不动」「连接被网关掐断」这类线上问题的关键。
MCP(Model Context Protocol)是一套标准化协议,用于让大模型应用以统一方式接入外部工具与数据源。它把「模型能调用什么、怎么调用」抽象为 Server 端暴露的 tools、resources、prompts 等能力,客户端(如 Spring AI 应用)按协议发现并调用,从而避免为每个外部系统单独写一套适配代码。对企业而言,MCP 意味着既有的内部 API、数据库、文档系统可以通过一次封装被多个模型应用复用,也让工具调用的权限与边界更可控。Spring AI 提供了 MCP 客户端与服务端的集成支持,使这类外部能力可以像普通 Spring 组件一样被注入和管理。
RAG知识库落地:分片、TopK与溯源
压轴部分是RAG企业知识库。教程没有停留在「填气泡Demo」,而是直面生产问题:分片策略怎么定、TopK检索的瓶颈在哪、回答如何溯源、增量数据如何清洗。普通教程只教跑通Demo,这套教程则把持久化、模型切换、全线拦截、工具调用兜底、检索调优、故障排查、代码配置模板和避坑清单都备齐了。
对Java后端而言,这意味着RAG不再是一个黑盒,而是可以像普通Spring组件一样被调试、被替换、被监控的工程模块。
TopK 是向量检索中「返回最相似的 K 条结果」这一参数。K 太小,召回不足,模型拿不到足够上下文;K 太大,一方面会把相关性低的内容塞进提示词,稀释关键信息、增加幻觉风险,另一方面会迅速吃满上下文窗口并推高延迟与成本。因此 TopK 往往需要配合相似度阈值、重排序(Rerank)等手段一起调优,而不是简单调大。
回答溯源则是让模型在生成时标注引用的原文片段或文档来源,既提升可信度,也便于人工核查。工程上通常要求检索结果携带文档 ID、页码或段落偏移,并在提示词中要求模型引用编号;增量清洗则是指知识库文档更新时,通过哈希或版本比对只重新处理变化的部分,避免全量重建索引带来的开销。
谁适合这套路线
这套教程的定位清晰:有Java基础、想切入AI应用开发的后端工程师;准备面试大厂、需要讲清Spring底层原理的求职者;以及正在把大模型能力接入企业系统的工程团队。它的局限也同样明显——不覆盖模型训练与算法调优,侧重的是工程化落地能力。
从Spring装配原理讲到RAG调优,能讲得清、扛得住追问,才是这条路线真正想交付的东西。
相关推荐
WorkBuddy实战:AI Agent自动化工作流搭建与文件批处理
WorkBuddy 实战教程:通过批量 Word 转 PDF 并归档的真实案例,演示 AI Agent 如何从理解需求到自主执行任务,涵盖授权、积分消耗、结果验收全流程,并分析其适用边界。

AI+网络安全实战:从Agent入门到智能体挖漏洞
B站AI+网络安全教程解读:把AI当作工具而非替代品,从Agent搭建、MCP调用到Web漏洞实战,讲清AI在渗透测试中的定位与从业者必备的判断力。
具身智能四阶段学习路线:从ROS到VLA实战
一份完整的具身智能学习路线,分四阶段覆盖Python/C++与Linux基础、ROS通信、感知与控制(MoveIt2、Nav2、Gazebo/Isaac Sim)、模仿学习与强化学习、VLA模型,以及项目实战与作品集整理,适合想系统入行的开发者。