JEV-27B-VL视觉决策模型入门指南

JEV-27B-VL 把图像输入直接映射为带校准概率的选项决策,而非生成文本。
JEV-27B-VL 是 Autotrust 维护的 270 亿参数视觉语言模型,采用 Apache-2.0 许可,核心特点是 System 1 模式从 logits 直接读出选项概率,一次前向传播即可返回带类型的决策,无需生成再解析文本;System 2 则是可输出文本与逐步推理的 Qwen3.8-27B。它在短视频封面冷启动排序、智能体任务完成判断、多模态答案对比、截图动作选择和草图早期分类五类任务上有具体评测,其中 AgentRewardBench 上 AUROC 0.91,VL-RewardBench 整体 78.3%。但图像编辑项仅 57.8、一般性问题 58.0,且模型卡缺失图像分辨率、显存要求、量化选项等部署关键信息,也未提供可直接运行的完整推理示例。
视觉语言模型大多被当作对话工具使用,但 Autotrust 维护的 JEV-27B-VL 走了一条不同的路:它把图像输入和"带概率的决策输出"绑在一起,让模型在一次前向传播中直接给出选项概率,而不是生成一段需要解析的文本。对于需要可校准分数的工程场景,这个差异比参数规模更有意义。
两种模式:决策与推理分离
JEV-27B-VL 是一个 270 亿参数的视觉语言模型,采用 Apache-2.0 许可。它在 autotrust/JEV-27B 的基础上增加了图像输入能力,并对外暴露两个互不相同的接口。
System 1 读取 logits,在给定选项上返回带类型的决策和校准概率,支持是/否判断、2 到 256 个选项之间的选择、以及 0 到 5 的评分,提示长度最高 256K token。System 2 则被描述为未经修改的 Qwen3.8-27B,可以接收图像输入并输出文本或逐步推理。
这个设计的实际价值在于:System 1 不需要生成答案再解析,概率直接从一次前向传播中读出。对离线评测、过滤和奖励信号这类需要稳定数值的场景,这比自由文本评论更实用。模型卡没有说明两个模式是否共享权重,也没有交代视觉编码器的具体实现。
logits 与校准概率:在神经网络中,logits 指模型最后一层(通常是分类头)输出的未归一化实数向量,每个分量对应一个选项的“原始分数”。要得到概率,需经 softmax 或 sigmoid 归一化,使输出落在 0 到 1 之间并可解释为置信度。校准(calibration)则要求模型给出的概率与真实频率一致——例如在所有预测为 0.8 的样本中,实际正例比例应接近 80%。System 1 直接从 logits 读出选项概率,绕过了自由文本生成与解析,因此数值更稳定、可复现,适合评测打分和奖励信号;但校准质量仍取决于训练数据和后处理,模型卡中的期望校准误差(ECE)是衡量这一点的关键指标。
五类经过验证的使用场景
短视频封面排序
System 1 可以把候选封面与用户最近观看的五个封面进行对比,返回用户会观看该候选视频的概率。在 MicroLens-100k 的评测中,仅用封面打分在 20 个候选中达到 0.727 AUC 和 0.590 HR@5;而基于 59,045 名用户历史训练的协同过滤为 0.728 AUC 和 0.490 HR@5。对新视频而言,这提供了一个可用的冷启动排序信号。需要说明的是,这是 200 名用户的离线评测,不能等同于信息流规模下的线上表现;演示中单 GPU 打分 20 个封面约耗时 2.6 秒。
判断网页智能体是否完成任务
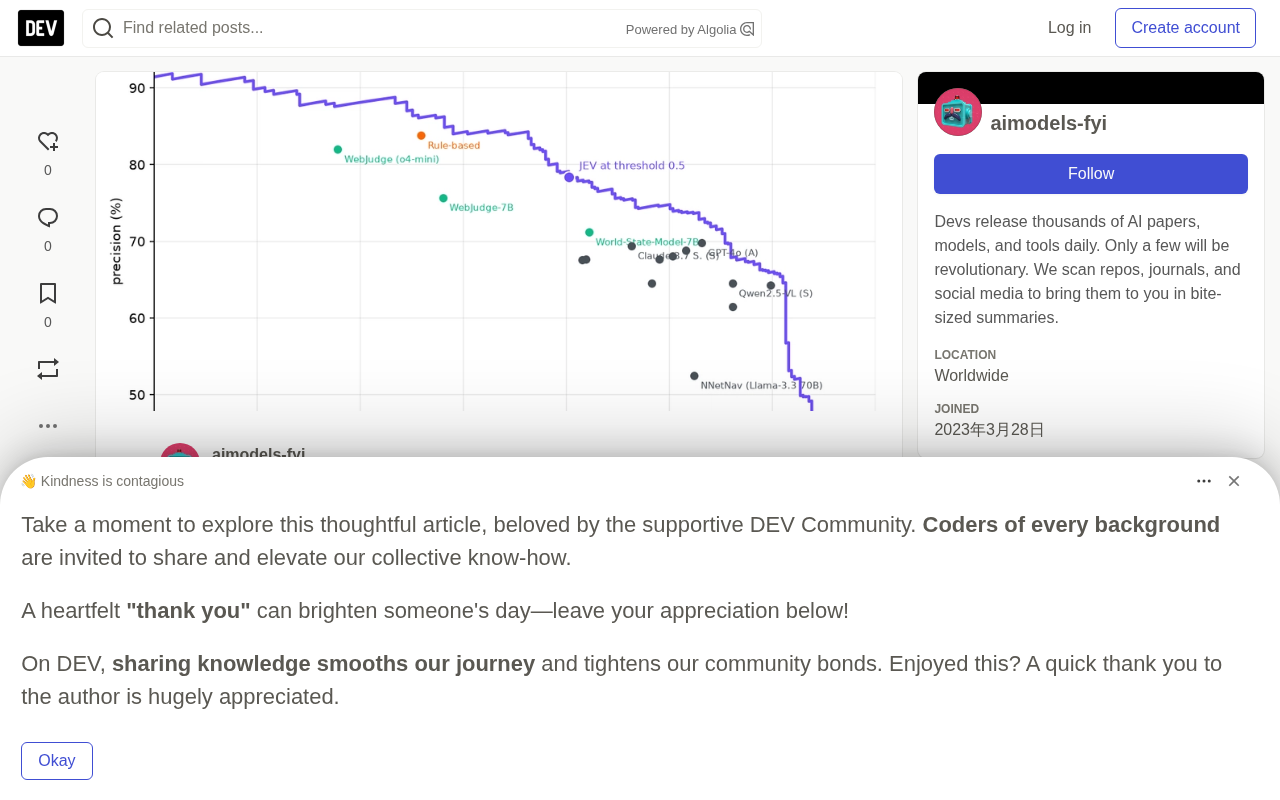
输入用户目标、智能体的动作与最终消息,再加一张最终截图,System 1 一次前向传播即可返回任务完成概率。在 AgentRewardBench 的 1,302 条专家标注轨迹上,模型报告 AUROC 0.91,阈值 0.5 时精确率 78.4、召回率 70.2。其精确率在每个对比评委各自的召回水平上都更高。这适合做离线评估、过滤或奖励信号。
多模态答案对比
给定图像、问题和两个候选答案,System 1 可以判断哪个更好。在 VL-RewardBench 上整体准确率 78.3%,幻觉项 83.2%,推理项 78.2%,但一般性问题准确率只有 58.0%。在较新的 Multimodal RewardBench 2 上,四项任务平均 63.8,与 GPT-4.1 和 Qwen3-VL-32B 在同一张表上接近,但落后于 GPT-5 和 Gemini 3 Pro。图像编辑项 57.8 是明显短板,如果主要评测目标就是编辑,需要谨慎。
从截图选择动作
README 演示了游戏动作决策:超级马里奥中的移动与跳跃、俄罗斯方块中的列与朝向、贪吃蛇中的方向。报告的单次决策耗时约为马里奥 150 毫秒、俄罗斯方块 122 毫秒、贪吃蛇 300 毫秒。这类任务适合动作集有限、视觉状态可以用图像加文本表达的场景,但不能据此推断通用游戏能力。
未完成草图的分类
在 320 名真实玩家参与的 Quick, Draw! 评测中,画作完成后模型选中正确类别的比例为 88%,在完成 60% 笔画时为 62%,而 16 个答案中随机猜测为 6%。这说明在候选标签已知、早期预测有价值的分类任务上,该模型有实际用途。
AUC、HR@5 与 AUROC 的区别:文中出现的几个排序指标容易混淆。AUC(ROC 曲线下面积)衡量模型把正例排在负例之前的整体能力,0.5 相当于随机;AUROC 是二分类场景下 AUC 的同义说法,AgentRewardBench 的 0.91 即表示完成与未完成轨迹的可分性。HR@5(Hit Rate at 5)则关注前 5 个推荐中是否命中用户实际交互项,0.590 意味着约六成情况下命中,比 AUC 更贴近推荐列表的实际体验。协同过滤 0.728 AUC 与 0.490 HR@5 说明其整体排序不差但头部命中偏低,而封面打分在 HR@5 上的优势正是冷启动场景的价值所在。
必须了解的局限
模型卡没有给出最大图像分辨率、单次请求的图像数量、支持的图像格式、图像预处理规则,也没有最低 GPU 或显存要求。同样缺失的还有模型文件格式、量化选项、批大小建议和通用吞吐基准。27B 的参数规模和单 GPU 演示,不能证明某块具体显卡一定能加载模型,部署前应按照实际 checkpoint 和 serving 配置核对显存。
System 1 面向的是给定选项上的决策,而不是开放式答案生成。概率会随问题、状态和选项描述变化。README 提到,一行"何时使用"的描述有助于区分相似选项;而在测试的提示研究中,问题措辞、JSON 与纯文本格式、额外指令都没有产生可测量的差异。选择任务的上限是 256 个选项。256K token 的说法来自一项具体测试:在最多 250K token 中随机深度隐藏一句话,各测试长度下 20 次全部正确——这是窄条件下的结果,不能理解为长上下文检索永远可靠。
长上下文测试的解读边界:256K token 的提示长度上限来自一项“大海捞针”式测试——在最多 250K token 中随机深度隐藏一句话,要求模型检索出来。这类测试只验证单一事实的定位能力,不覆盖多跳推理、跨段落综合或干扰项密集的场景;20 次全部正确是小样本,且未报告不同隐藏深度下的失败率。因此 256K 应理解为“接口支持的最大长度”,而非“该长度下检索永远可靠”。工程上若依赖长文档做决策,仍应在自己的数据分布上做压力测试,并关注位置偏置(模型对开头和结尾内容更敏感)带来的召回差异。
与其他模型的定位差异
AutoJev-27B 报告整体准确率 84.60%,但没有可比的视觉基准、速度或成本数据。需要图像输入时选 JEV-27B-VL;看重自主智能体开发流程、TypeSafe 兼容 API 或浏览器 playground 时考虑 AutoJev-27B,现有数据不足以对两者做质量或速度排序。
OpenJev 被描述为面向文本、网页和截图的类型化决策模型,最多 52 个选项,在单张 H100 上处理一次孤立网页决策约 210 毫秒,使用约 1,460 个提示 token 和 23 个选项。这是 JEV-27B-VL 通用请求所缺少的具体速度参照,但两者没有在同一任务上的质量对比。
open-jev-deberta-v3-large 是类型化决策格式的独立复现,支持最多 255 个选项、210 个有序等级评分和是/否判断。其描述明确说明,由于使用公开金标签而非私有工作流,结果不能与 TypeSafe 结果直接比较。它没有确立视觉支持能力,因此不是截图判断的同类替代。
imajev-4b 的页面没有提供描述,无法就质量、速度、成本、输入或使用场景做有依据的比较。lev 是 Qwen3.5-4B 上的 LoRA 适配器,输出 token 为零,兼容 TypeSafe 的 /v1/systemone 协议;更小的基座可能适合紧凑型类型化决策部署,但同样缺少可比的延迟或质量结果。
技术规格与接入方式
模型被列为 image-to-text 流水线,库为 Transformers。README 还描述了 serve_decide.py,它为 vLLM 服务器增加 POST /v1/decide 端点。System 1 的 HTTP 请求体为 {kind, state, question, options},但没有完整的请求示例或精确的响应 schema。
在六项公开文本决策基准上,JEV-27B / JEV-27B-VL 行的六组均值为 84.07%,高于 TypeSafe Jev 1.13 托管 API 的 83.85% 和 NeoHorse-Jev-4B 的 77.70%。在 jev-distill-corpus-v3 的留出集 test_set_30k 上,与 TypeSafe Jev 1.13 分布的 KL 散度为 0.017,是/否 AUROC 0.995,在存在明确首选的行上选择 top-1 一致率 95.8%,0 到 5 评分 MAE 0.098,期望校准误差 0.0009。在一项独立的 800 题压力测试中,2、4、8、16 个选项下的准确率分别为 0.876、0.784、0.767 和 0.740。
模型元数据显示下载量为 179,237。许可为 Apache-2.0,但材料没有说明额外使用限制、安全测试、偏差评估或微调配方,也没有维护计划或未来更新承诺。README 把一组功能标为"New (1 October 2026)",但这个日期本身不能证明持续维护。
上手前需要确认的事
README 记录了 System 1 的 vLLM HTTP 端点,却没有完整的 Python 加载或推理示例,没有模型加载调用,也没有完整响应 schema,因此无法从现有材料给出经过验证、可直接复制运行的 Transformers 推理代码。建议先阅读模型的 serving 代码,确认 kind 的取值、图像编码方式、端点响应格式和服务器启动参数,再决定是否集成。如果你需要的是带校准概率的视觉决策接口,而不是又一个多模态聊天模型,JEV-27B-VL 值得放入评估清单;如果主要任务是开放式图像理解或图像编辑评估,现有数据提示它未必是最优选择。
相关推荐

iPhone Duo上手体验:2000美元的小屏折叠,值不值?
YouTube博主Allison分享iPhone Duo上手体验:双屏多任务效率翻倍,视频观看体验出色,磨砂质感好评,但机身偏厚、单屏操作偏小,2000美元定价进入MacBook区间,属于奢侈品定位。

Sentry广告笑疯开发者:On-call也能变有趣?
Sentry广告短片以开发者On-call焦虑为切入点,用幽默对话展示其将错误、日志、链路、指标、录屏和发布记录集中一处的可观测性能力,引发开发者社区共鸣。
LLM应用越改越糟?三步构建有效评估体系
LLM应用迭代时如何判断变好还是变坏?本文基于Reddit开发者讨论,详解构建测试集、自动化回归评估、LLM-as-judge评分与结构化追踪智能体行为,建立从生产反馈到评估追踪的持续闭环。