Jev + Claude Code:快慢思考如何让AI Agent成本暴降90%

Jev是专为决策设计的"系统一"AI模型,以毫秒级速度输出概率,与慢思考大模型协同构建低成本编程反馈闭环。
Jev是TypeSafe推出的一类全新"系统一模型",与GPT、Claude等生成式大模型截然不同——它不生成文本,而是针对用户预设的选项集合输出概率分布,响应速度200~300毫秒,成本极低。它提供真伪判断、多项选择(最多255项)和光谱评分三种基础原语,适合用作高频结构化决策的智能开关。结合"思考快与慢"的双系统框架,Jev被定位为系统一(快速直觉),与Claude Fable、GPT-6 Astra等系统二(深度推理)协同:Jev负责广泛、低成本的即时筛选,系统二负责深层规划与标准重写,形成可自我进化的闭环。在编程工作流中,这套组合已展现出四类实际价值:代理技能路由省下万级token、浏览器流程验证成本降至分美分级、定性代码检查覆盖语义层、代码坏味道扫描全库仅需1美元出头。作者认为,这将推动代理式编程的成本结构发生根本性重构。
近几年真正让人眼前一亮的模型不多,Jev(源自"Jevons悖论"命名)却是个例外。它不是又一个更大更强的语言模型,而是一类被称为"系统一模型"的全新前端模型——快、便宜、结构化,专门用来做决策。当它与 Claude Code、Codex 这类"系统二"编码代理组合,能在编程工作流里构建极其紧密、低成本的反馈循环。本文梳理这套思路的原理与实际应用。
Jev 是什么:不生成文本,只输出概率
普通大语言模型的工作方式是:给它提示和数据(比如一张发票加上"这张发票是否欺诈"的问题),它会逐个 token 生成一句话回答。由于自回归架构,这个过程往往耗时较长。
Jev 的思路完全不同。你给它同样的提示和数据,同时提供一组预设选项(欺诈 / 干净 / 需人工审核),它会基于概率为每个选项打分,比如"这张发票有 88% 概率是干净的"。它不生成任何文本,只在你提供的答案集合里返回概率。
由于架构差异,响应速度极快——通常 200 到 300 毫秒内就能拿到结果。你可以把它理解成一个"聪明的开关语句":把返回的概率丢进 if 判断,就能快速对海量数据做决策。
在 TypeSafe 的 playground 里,Jev 提供了几种基础原语:
- Null(真伪判断):评估某件事的真实性,返回是/否的概率。粘贴一张虚构的欺诈发票,它给出 85% 真实性;加入欺诈信号说明后,判断变成 94%,反复运行数值都稳定在附近,波动仅 2~3 个百分点。
- 选择(多项选择):最多可定义 255 个选项。把发票问题改成"人工审核/欺诈/干净",它在 100 毫秒内返回 98% 欺诈、2% 人工审核。
- 评分(光谱打分):最多 11 档评分标准(0~10 分)。比如给销售线索打分,定义"0 分是没预算的学生、3 分是大型企业",输入一个企业负责人信息,它返回 2.91 分,可据此触发不同的跟进逻辑。
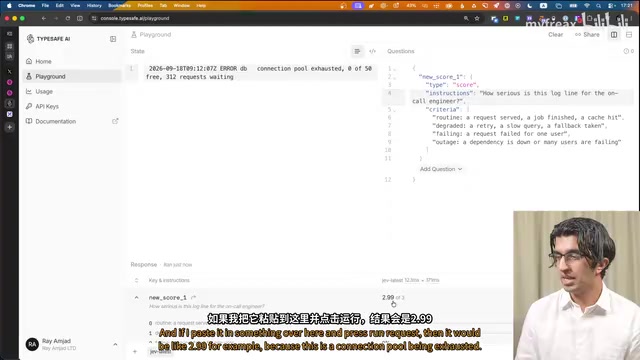
评分原语的另一个典型场景是日志分级——把"连接池被耗尽"的日志丢进去,它给出 2.99 的严重度评分,超过 2.5 就立即通知值班工程师。由于 Jev 又便宜又快,你几乎可以实时监控关键系统。
Jev 背后的架构原理与传统自回归语言模型有本质区别。传统大语言模型采用"下一个 token 预测"机制,每生成一个词都需要完整的前向传播,序列越长耗时越线性增长。Jev 则更接近判别式模型(Discriminative Model)而非生成式模型(Generative Model)——它的任务不是"写出答案",而是"从候选集中挑选答案",本质上是一个多类别概率分类器。这使得它能绕开自回归推理的延迟瓶颈,将单次决策压缩到毫秒级。类比来看,它更像 BERT 系列的填空式模型,而非 GPT 系列的续写模型。这种架构的代价是无法处理开放式生成任务,但在结构化决策场景(欺诈检测、日志分级、任务路由)中,这个限制反而成为优势:输出空间有界,结果可直接接入 if/else 逻辑,无需再用另一个模型做"意图解析"。
系统一与系统二:快慢思考的分工
TypeSafe 把 Jev 定位为"系统一模型",这个概念显然受《思考,快与慢》启发。人类认知有两套模式:系统一快速、自动、反射式,几乎不需要有意识努力;系统二缓慢、注重细节。重要的是,通过训练可以把某些任务从系统二迁移到系统一——就像学开车,起初要不断检查后视镜、挡位(系统二),熟练后变成条件反射(系统一)。
对应到 AI:Claude Fable 5.1、GPT-6 Astra 这类速度较慢、注重细节的模型是"系统二";Jev 则是"系统一"。它足够快,可以始终开启、在后台持续运行。
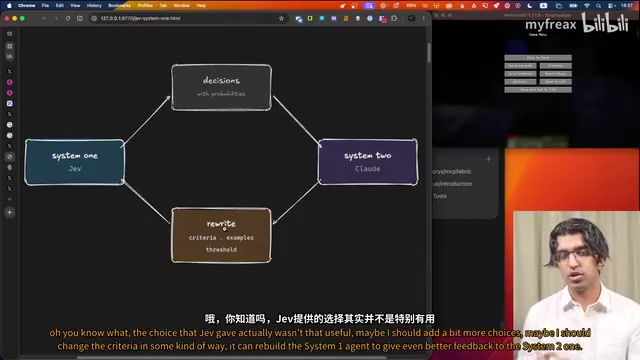
两者组合会产生化学反应:Jev 给出一堆带概率的即时决策,if 语句据此自动执行动作;而更深入的系统二模型可以定期反思"我们的策略是什么、能否改进",然后重写系统一所用的标准和指令,再回传给 Jev。这就是一个系统二训练系统一的闭环。
这套框架来自心理学家丹尼尔·卡尼曼(Daniel Kahneman)在《思考,快与慢》(Thinking, Fast and Slow)中提出的双系统认知理论。系统一(System 1)依赖直觉、模式匹配和经验,几乎不消耗认知资源;系统二(System 2)则负责逻辑推理、规划和深度分析,但速度慢、资源消耗大。在软件工程语境中,这个隐喻尤其贴切:编译器的语法检查更像系统一(规则明确、执行极快),而架构评审更像系统二(需要上下文理解和权衡)。将 AI 模型按此框架分类,本质上是在探索"哪些判断可以被规则化、结构化,从而降低单位决策成本"。TypeSafe 的创新在于,他们试图通过专门训练让一类模型在特定判断任务上达到"直觉级"的速度与成本,同时用系统二模型持续校准这些判断标准,形成可进化的闭环。
Minecraft 实验:Astra 规划,Jev 执行
视频作者做了一个直观演示:让 Jev 和 GPT-6 Astra 实时协作玩 Minecraft。分工是——Astra 负责高层规划(先建庇护所、准备工具、天黑前采矿、朝铁镐和钻石推进),Jev 负责即时执行(根据当前状态在可选任务里快速多选切换)。
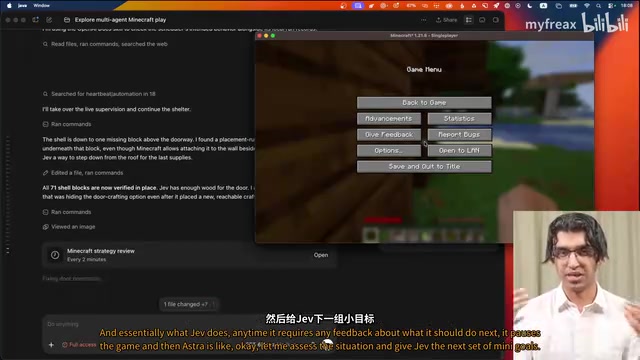
Jev 会读取中间目标、当前状态(血量、饥饿值、时间、采矿进度)、历史记录和可用任务列表,从中做多项选择;遇到需要反馈时暂停,交给 Astra 评估情况并下达新的小目标。Codex 每两分钟审查一次,遇到里程碑或"Jev 死亡"这类挫折时也会复盘"为什么会死、下次怎么改进"。
这几乎完美映射了人类玩游戏的方式:系统一完成大部分操作,系统二偶尔反思并重新训练系统一。程序跑了约 10~20 分钟,Jev 先建好带门的庇护所,拿到石镐、钻石镐,最终甚至到达了下界。
编程工作流:Jev 能解决的四类实际问题
Jev 在 AI 软件开发中的应用才是重点。
技能选择:省下上万 Token
Claude Code 用户常安装几十甚至上百个技能(skills),每个技能描述都会占用上下文窗口的 token。官方 Jev 手册提到一个例子:Hermes 代理有 182 个技能,仅靠代理自己选择时错误加载技能的比例约 17%,经 Jev 推荐后降到 7%。作者把所有技能放到 Jev 后面按需推荐,直接省下约 1 万 token。
浏览器验证:几秒、几分之一美分的反馈循环
有人用 Jev 结合浏览器操作,约 7 秒内查到航班价格,成本约 0.4 美分。这意味着可以本地运行 Jev 快速验证应用中数百种用户流程。因为 Jev 面对熟悉网站(如 Google Flights)就像人用系统一浏览一样直觉快速,可以构建又快又便宜的验证代理,交给系统二代理去修 bug。
更进一步,有团队用它搭建了"高度并行的对抗性测试套件"——几十个浏览器并行随机点击、模拟真实用户试图搞崩应用,成本只要几美分。每个 PR 可以并行启动数十到数千个 Jev 代理找漏洞,作者估算每天成本仅 5~10 美元。此时成本瓶颈不再是 token,而是计算资源。
定性代码检查:把 lint 规则变成自然语言问题
作者演示了用 Jev 清理"垃圾注释":判断注释的准确性和有用性。9.3 秒处理 150 条注释,约 0.01 美元;分析整个代码库(约 1700 条待改注释)约 0.57 美元。
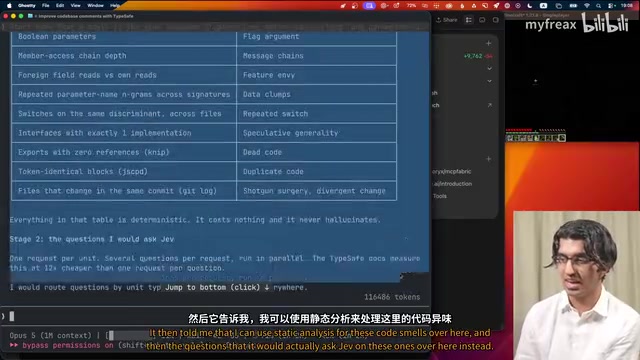
这类"定性检查"传统上很难用 lint 规则覆盖。有了 Jev,你可以直接用自然语言提问:"函数名是否描述了其功能和副作用""日志里是否记录了密钥或财务数据",记录敏感信息就报错。每个 PR 都能以极低成本跑这类检查。
传统静态分析工具(如 ESLint、Pylint)依赖预定义规则,擅长捕捉格式错误、未使用变量、潜在的类型不匹配等结构性问题,但对"语义质量"几乎无能为力。例如,一个注释在语法上完全合法,但内容过时、误导或冗余,任何 lint 规则都无法识别。Jev 在此开辟了一类新的"语义 lint"能力:它可以理解自然语言提问的意图,对代码片段做定性评估。这与近年兴起的 LLM-based code review 工具(如 CodeRabbit、Sourcery)思路相近,但 Jev 的速度和成本优势使其更适合作为 CI 流水线的常驻环节,而非仅在人工请求时触发。可以预见,未来的代码质量检查体系可能呈现"三层结构":传统 lint 处理语法层、Jev 类模型处理语义层、GPT/Claude 类大模型处理架构层。
代码坏味道扫描
沿用 Martin Fowler《重构》中的"代码坏味道"概念(重复代码、死代码、魔法数字等),作者让 Jev 扫描整个代码库。彻底检查需要 2800 万输入 token,仅 1.19 美元。做法是让系统二先做小规模检查、查看结果、调整标准,再让 Jev 大规模运行。
基于 Jev 的代码审查:把注意力用在刀刃上
作者构想了一个更完整的模式:让编码代理构建自己对代码库的"系统一理解"——包含一堆不变量、坏味道、评分标准。每个 PR 自动与一份 50500 项的检查清单比对,就像高级工程师从 1001000 个角度做直觉审查,把严重问题转交给系统二主代理修复。安全相关问题甚至可以路由给专门模型(如 GLM 5.3),因为主流云端模型往往拒绝处理安全类请求。
这个方向已有实践佐证:Sentry 的一位工程师提到,在其安全流水线上用 Jev 类小模型,比原方案便宜 5 倍、更快,同时保持高准确率。作者让运行 Opus 5 的代理评估后发现,把代码审查的 token 量减到十分之一,光成本上就有巨大优势。
一种正在成型的趋势
作者坦言,上一次对新模型这么兴奋还是四年前 ChatGPT 首次发布时。他判断这会成为未来的一种范式:系统一模型(Jev,或 OpenAI、Anthropic 可能推出的同类)与系统二模型(如 Claude Fable)协同,在代理式编程中实现更好的结果。
系统一负责在整个代码库、代码差异上做极其廉价的广泛筛选,只有最强的信号才交给系统二模型投入最多注意力;系统二又能反过来重写系统一的标准,赋予代理"反射能力"。更健壮的安全流水线、更便宜的代码审查、全天候的对抗性测试、快速的定性检查——这些应用共同指向一个成本结构被重构的编程未来。
相关推荐

Google Antigravity 上线 Claude 5.5:额度机制全解析
Google AI IDE Antigravity 上线 Claude 5.5(Opus 5.5 与 Sonnet 5.5),本文解析账号付费区分、Pro 与 Ultra 额度机制、Gemini 额度分层调整,以及 Gemini 4 Argon 展望。

Lovable创始人谈AI应用变现:从Demo到盈利的实战方法论
Lovable创始人Anton Osika分享AI应用从Demo到盈利的实战方法论:如何验证需求、定价策略、零代码后端构建,以及用10个客户测试市场的框架。估值130亿美元平台的变现经验全解析。

AI智能体主动给研究者发邮件求助:自主行为的边界在哪?
一个AI智能体主动向研究人员发邮件求助,并解释了原因。本文深入分析AI智能体自主行为的技术逻辑、可解释性难题与安全隐忧,探讨自主AI的边界与对齐挑战。