Jevman:让AI决策模型实战玩转吃豆人游戏

Jevman项目让AI决策模型实战吃豆人,通过游戏可视化展示不同模型的实时决策差异。
Jevman是一个出现在Hacker News的小型开源项目,它将AI决策模型接入经典街机游戏《吃豆人》,以直观、可对比的方式展示不同模型的实时决策行为。游戏环境因其封闭性、可量化性和多目标冲突结构,长期以来是AI能力评估的重要测试床,从DeepMind的Atari实验到AlphaGo均沿用这一思路。Jevman的价值在于将抽象的AI决策过程转化为人人可见的具体动作,降低了理解AI行为的门槛,对学习者、研究者和普通观众均有一定的教育意义。其局限同样明显:吃豆人场景相对简单,单一游戏表现难以代表模型的通用决策能力,且项目目前社区关注度有限。若后续能支持多模型横向对比并提供更丰富的决策数据分析,该项目有潜力在AI教育与研究工具领域占有一席之地。
当AI决策模型遇上经典吃豆人
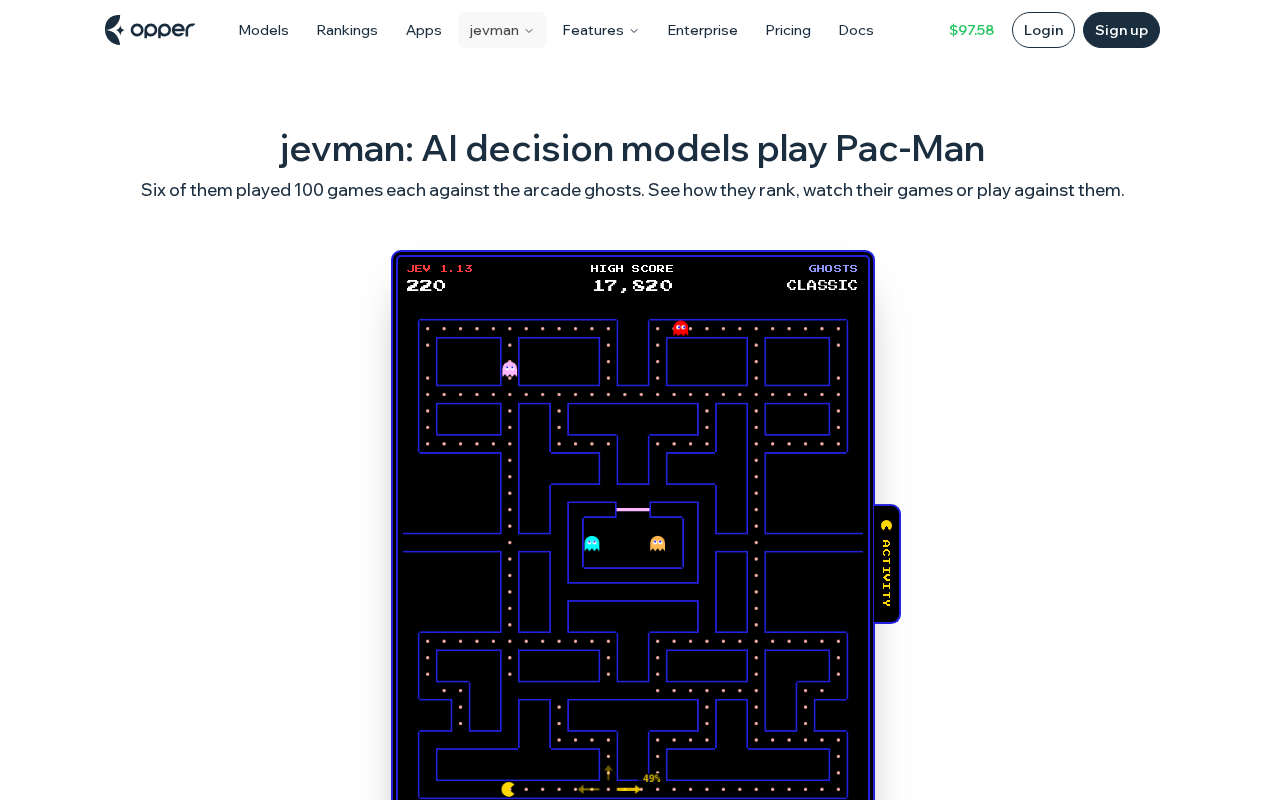
在Hacker News的Show HN板块,一个名为Jevman的项目吸引了开发者社区的关注。这个项目的核心理念简单而有趣:让AI决策模型来玩经典街机游戏《吃豆人》(Pac-Man),借此直观地展示和比较不同模型在实时决策场景下的表现。
《吃豆人》作为一个经典的测试环境,具备明确的目标(吃掉所有豆子)、动态的威胁(移动的幽灵)以及有限的空间约束。这种结构清晰、规则明确的游戏场景,恰好为评估AI的路径规划、风险规避和即时决策能力提供了一个绝佳的沙盒。
为什么选择游戏作为AI测试场
用游戏来检验AI能力并非新鲜事。从DeepMind早期在Atari游戏上的突破,到AlphaGo征服围棋,游戏环境一直是衡量AI决策能力的重要标尺。游戏提供了封闭、可重复、可量化的测试条件,让研究者能够清晰地观察模型在面对连续决策时的行为模式。
吃豆人这类游戏的特殊价值在于,它要求AI同时处理多个相互冲突的目标:既要高效收集奖励(豆子),又要规避随机移动的危险(幽灵),还需要在迷宫式地图中进行实时路径规划。这种多目标权衡的场景,比单纯的最优化问题更接近现实世界中AI需要应对的复杂决策。
Jevman把这种测试过程可视化,让观察者能够直接看到不同决策模型在同一场景下做出的不同选择,这对于理解模型的"思考"逻辑具有直观的教学意义。
DeepMind在2013年发表的DQN(Deep Q-Network)论文是这一领域的里程碑,该系统仅凭原始像素输入就能在49款Atari游戏中达到甚至超越人类水平。其核心方法是将深度神经网络与强化学习中的Q-Learning结合:模型通过反复试错,学习在不同游戏状态下选择能最大化长期累计奖励的动作。吃豆人正是这49款测试游戏之一,但DQN在吃豆人上的表现相对欠佳,原因在于吃豆人需要更长时间的策略规划和对多个移动幽灵的协同规避,这对依赖即时反馈信号的强化学习模型提出了更高挑战。Jevman项目所使用的"AI决策模型"与DQN路线不同——它更可能是调用大语言模型(LLM)的API接口,以文本或结构化数据描述游戏状态,再由模型输出决策指令,这代表了一种用通用推理模型替代专项训练模型的新兴实验思路。
决策模型的可视化价值
Jevman项目的意义不仅在于娱乐性,更在于它为AI决策过程提供了一个透明的展示窗口。当我们谈论AI模型时,其内部的决策逻辑往往是黑盒般难以理解的。而通过游戏这种人人熟悉的载体,模型的决策行为被转化为具体可见的动作——向左、向右、是否冒险穿过幽灵的路径。
这种可视化对于几类人群都有价值:对于学习者,它直观展示了不同算法策略的差异;对于研究者,它提供了一个快速对比模型表现的平台;对于普通观众,它让抽象的AI决策变得生动有趣。
从目前Hacker News上的早期反馈(9个赞、1条评论)来看,这是一个处于起步阶段的小众项目,社区讨论尚不活跃。但其切入角度——将AI决策与经典游戏结合——仍然体现了开发者社区一贯的创意精神。
AI决策过程的"黑盒"问题在学术界对应一个专门的研究方向:可解释人工智能(Explainable AI,XAI)。现代深度学习模型由数亿甚至数千亿参数构成,其内部推理过程难以直接追踪,这在医疗、金融、司法等高风险领域造成了信任与监管难题。游戏化可视化是XAI领域一种直观的"外部可解释性"手段——它不试图解释模型内部的权重计算,而是通过观察模型在结构化环境中的行为模式,归纳其决策偏好与策略特征。这与"行为主义"评估范式相符:我们无法看进黑盒,但可以通过足够多样的刺激-反应对来描绘模型的能力边界。吃豆人的迷宫结构天然提供了路径选择、风险容忍度、目标优先级等多维度的可观测行为,使其成为一个相对丰富的行为分析载体。
这类项目的局限与潜力
需要客观看待的是,吃豆人作为测试环境虽然经典,但相对简单,难以全面反映现代AI模型在复杂任务中的真实能力。单一游戏的表现并不能等同于通用决策能力的强弱。
不过,这类轻量级的演示项目有其独特价值。它降低了理解AI决策的门槛,为更广泛的受众提供了接触AI行为的直观途径。如果Jevman能够支持更多模型的接入和对比,并提供更详细的决策数据分析,它有潜力成为一个有趣的教育和研究工具。
对于关注AI决策能力评估的开发者而言,这类项目也提供了一种思路:用熟悉的游戏场景作为模型能力的"试金石",既降低了实验成本,又提升了结果的可解释性。
小结
Jevman代表了一类将AI能力游戏化、可视化的探索尝试。虽然目前项目信息有限、社区关注度不高,但它用吃豆人这一经典载体来呈现AI决策过程的思路值得肯定。随着AI模型评估需求的增长,这种直观、可对比的演示工具或许会在教育与研究领域找到更多应用空间。
相关推荐

iPhone Duo续航实测:一天一充跑不掉,大屏是耗电元凶
iPhone Duo续航实测:重度使用一天需至少充电一次,6.5小时亮屏约剩30%电量。大屏展开频率是耗电关键,MagSafe电池背夹可救场,长期衰减同样值得关注。

Kimi K3.1 Pro开源发布:2.8万亿参数逼近Opus
Moonshot发布开源MoE模型Kimi K3.1 Pro,2.8万亿总参数、1040亿激活参数,Terminal Bench 4.0仅落后Opus 5.5不到1分,单任务成本约三分之一,API价格减半,开源权重11月4日开放。

Costco科技产品价格竞猜:显示器、键鼠、Bose音响值不值?
YouTube博主在Costco竞猜科技产品价格:2K 180Hz显示器、罗技键鼠、Bose音响和CyberPower UPS实测估价,揭示仓储会员店的选品定价逻辑与品牌溢价真相。