Jev模型爆火:专为Agent设计的极速判断引擎
Jev是专为Agent设计的高速判断小模型,用极低成本替代流程中的大模型if判断。
Jev是一个只做判断、不做生成的专用小模型,能以70毫秒、低数百倍的成本完成"三选一/打分/是否"三类决策,并输出可靠的置信度。与GPT类通用模型和DeepSeek-R1类推理模型不同,Jev的核心竞争力在于置信度校准可信——它说七成准就真的是七成,因此可直接驱动"高于九成自动执行、六到九成转人工、低于六成不执行"的分层决策逻辑。对于正在做Agent落地的开发者,尤其是网页自动化测试等高频调用场景,Jev提供的思路是将"决策"与"生成"解耦,让大模型只在真正需要理解与创作时出手,其余判断交由专用小模型承担,从而同时压低延迟和token成本。
Jev为什么突然在国内刷屏
Jev模型近期在国内AI圈引发广泛讨论,搜索热度全球第一——中国排名第一,韩国第二,日本第七,而它的"老家"美国却排在第29位,形成一个有趣的反差。这种关注度的背后,是国内大量开发者正在拼命做Agent落地,而Jev恰好击中了他们最痛的成本与效率问题。
对做Agent的人来说,Jev的价值直接而具体:它能极大减少Agent的执行时间与成本。当你的智能体流程中充斥着大量"判断"步骤时,每一步都调用大模型意味着高延迟、高费用。Jev提供了另一条路。
Jev到底是什么
Jev不生成文字,它只做三种判断:从选项中选一个、给一个打分、或者输出"是/否"。而且每个判断都附带一个置信度。
说白了,就是把Agent里那个原本要跑一次大模型才能确定的if判断,换成了一个专用小模型。官方给出的数字相当惊人:70毫秒出结果,成本便宜几百倍,输出token不收费。
把它放进典型的Agent流程里,就是把决策与生成解耦——让专门的"裁判"来做判断,而不是让"作家"兼职判案。
Jev所属的技术类别通常被称为判别式小模型或路由模型(Router Model),与生成式大模型有本质区别。生成式模型(如GPT系列)的训练目标是预测下一个token,因此天然擅长"写";而判别式模型的训练目标是在有限选项中做出最优分类,参数规模可以极小(通常在几百M到几B级别),推理时计算量也远低于生成式模型。这也是Jev能将延迟压到70毫秒的结构性原因——它根本不需要逐token生成一段文字,只需要在输出层输出一个概率分布并取最高置信度的类别。这种架构在传统NLP时代(如BERT、RoBERTa)已被广泛使用,Jev的创新在于将其重新包装为面向Agent流程的"判断即服务"接口,并着重优化了置信度校准问题。
凭什么这么快:三种训练路子的差异
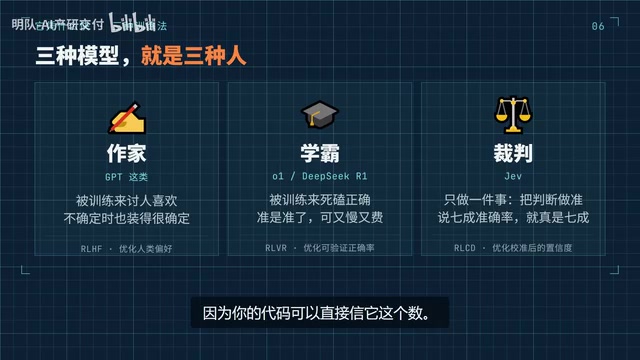
据这位B站UP主的分析,Jev快的根源在于训练方式的不同。他用了一个形象的比喻,把三类模型比作三种人:
第一种:GPT类——被训练来"讨人喜欢"
这类通用大模型能聊能写,但缺点是它在不确定的时候也会硬装确定,给你标注九成信心,实际可能只有七成。置信度不可靠,你无法直接采信。
第二种:DeepSeek-R1类推理模型——被训练来"死磕正确"
这类模型一道题反复推理,准是准了,但又慢又费算力。适合高价值、低频次的复杂任务,不适合高频判断。
第三种:Jev——只被训练做一件事:把判断做准
Jev最关键的特性是"说准就是真的准"。它说七成准确率,就真的接近七成。这个置信度校准的可靠性,意味着代码可以直接信任它的输出。
用一句话概括:大模型是作家,推理模型是学霸,而Jev是那个只管吹哨的裁判——不写文章,只做判断,还判得又快又准。
置信度校准(Calibration)是统计学和机器学习中的一个重要概念,衡量的是模型输出的概率与实际准确率之间的吻合程度。一个"校准良好"的模型,在它说"我有80%把握"的所有预测中,真实正确率应当接近80%。通用大模型在校准方面普遍存在**过度自信(overconfidence)**问题——它们倾向于给出接近100%的置信度,即使实际准确率远低于此。这是因为RLHF(基于人类反馈的强化学习)训练流程会鼓励模型给出听起来肯定的回答。Jev则通过针对性的训练(可能包括温度缩放、Platt缩放或专项校准损失函数等技术)来修正这一偏差,使置信度数字真正具有统计意义,从而可以被工程代码直接作为阈值决策的依据。
置信度分层:让判断真正可用
Jev真正的工程价值在于它的置信度可以直接驱动分层决策逻辑:
- 高于九成:自动执行
- 六成到九成:转人工看一眼
- 低于六成:直接不干
这种分层策略之所以成立,前提就是置信度可信。UP主举了一个海外订机票的真实案例:整个流程从头到尾只需要7秒,浏览器底层调用从一千多次砍到一百次。快在每一步该点哪、该填什么都不用再等大模型响应,而是由Jev即时判断。
对做Agent的人来说,这样的速度和成本控制堪称福音。
四个最值得用Jev改造的方向
UP主结合自己此前开源的QA Agent,提炼了几个最值得用Jev改造的具体场景。他的Agent里,网页自动化部分最费token——打开页面、登录、点元素、页面快照,每一步都要让大模型把整页读一遍再判断,一条用例来回几十次。
一、E2E测试的元素选择
点按钮后页面弹窗,要不要关?该点哪个元素?这种"三选一"的活正好交给Jev,70毫秒给出一个带置信度的选择。
二、失败分类
一条用例没通过,是脚本的错、产品的bug、还是环境问题?把这些放在一起做"五选一"判断,Jev可以快速归类。
三、门禁判定
这条用例到底算过还是没过?让Jev先给一个带置信度的"是/否",拿不准的再丢给大模型复核。
四、回归重跑(最狠的一处)
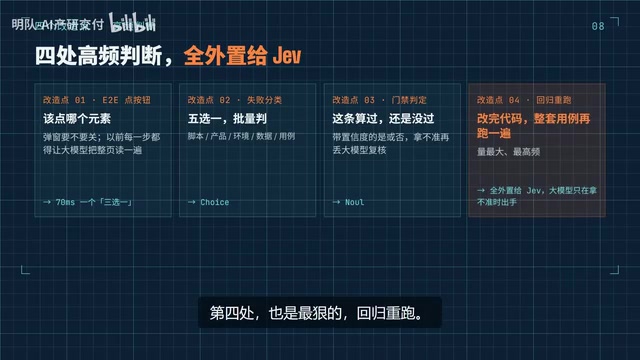
同一套脚本反复跑,量最大、频率最高,是典型的"成本黑洞"。把这部分判断全部外置给Jev,大模型只在Jev拿不准时才出手。这是收益最大的改造点。
文中提到的QA Agent属于**网页自动化测试(Web E2E Testing)**领域的智能体,其核心工作流是让Agent像真实用户一样操作浏览器:打开页面、定位元素、触发交互、截图对比。这类Agent对大模型的调用密度极高,因为每一步"看哪里、点什么"都需要理解页面DOM结构或截图内容。传统方案(如Playwright+LLM)中,一条完整测试用例往往需要调用大模型数十次,token消耗和延迟是主要瓶颈。将其中纯判断性的步骤(如"这个弹窗需要关闭吗?")替换为Jev,相当于在Agent的决策链路中插入了一个高速缓存层——只有Jev无法处理的复杂推理才会上升到大模型,大幅降低了整体调用成本,这也是文中"一千多次砍到一百次"这一数字的来源逻辑。
Jev不是替代,而是分工
Jev的定位不是取代大模型,而是与它分工协作:大模型负责"写"和"响应",Jev负责"判",代码负责"做动作"。三者各司其职,才能把Agent的成本和延迟同时压下来。
当然,Jev也有明确的短板:它给你判断,但不能解释为什么这么判;而且目前还不支持图片输入。这意味着在需要可解释性或涉及视觉理解的场景,仍然需要大模型兜底。
写在最后
如果你也在做Agent,同样被高频判断的成本卡住脖子,这个方向值得亲自尝试改造一遍。UP主表示准备把Jev迭代进自己的QA Agent,做好后会继续开源同步。对于正在为Agent执行效率和token成本发愁的开发者,Jev提供的"专用判断层"思路,或许是一个值得认真评估的架构选择。
相关推荐
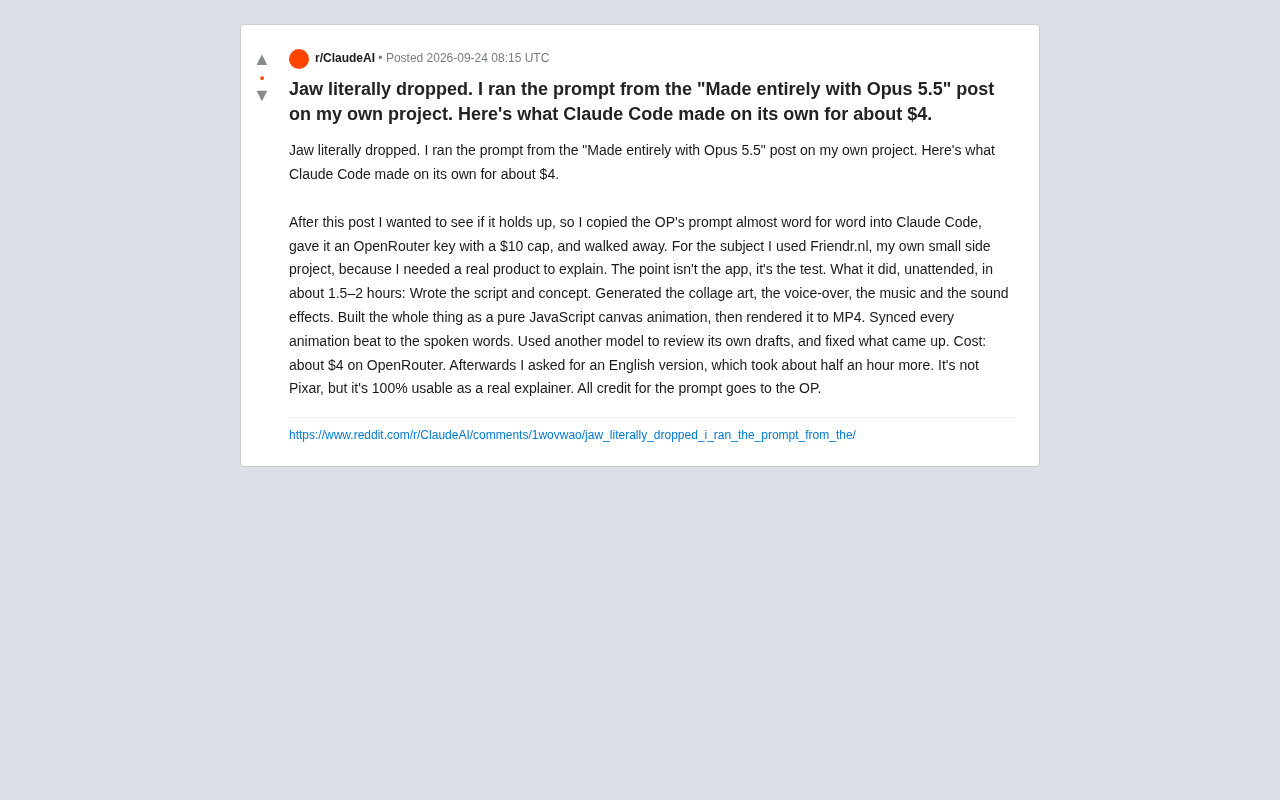
用4美元让Claude Code自主造出解说视频:一次无人值守实测
一位Reddit用户实测Claude Code:仅花约4美元、无人值守1.5-2小时,AI就自主完成了从脚本、美术、配音到动画同步渲染的完整解说视频。本文解析这场实验背后的Agent多模态编排能力与成本变革。
Agentic SOAR vs 传统SOAR加聊天机器人:安全响应的真实差异
Agentic SOAR 与传统 SOAR 外挂 LLM 聊天机器人有何本质区别?本文剖析智能体是否真正改变了安全事件响应中剧本的执行逻辑,并给出辨别厂商话术的实用方法。
28%的企业招聘岗位挂满90天:幽灵职位为何泛滥
一份最新报告显示,企业官网上28%的招聘岗位已开放超90天,揭示"幽灵职位"泛滥现象。本文分析其成因、对求职者的影响及识别规避方法。