基线模型检查点选择该统一吗?公平比较的关键争议
统一基线检查点选择规则可提升比较公平性,但需权衡基线调优状态,透明报告与消融实验是关键。
文章探讨了机器学习论文中基线模型检查点选择策略不一致对公平比较的影响。不同基线官方实现采用验证损失、准确率、早停耐心值或最后检查点等不同策略,这些策略会混入性能差异,引发审稿人对公平性的质疑。统一规则符合控制变量原则,但可能削弱针对特定策略调优的基线表现。折中方案是在主实验统一规则,附录保留原始策略结果,并透明报告每个基线的选择策略。面对质疑,补充统一规则的消融实验比文字辩护更有说服力。社区共识认为统一更严谨,但需权衡领域惯例,关键在于实验透明度和论证一致性。
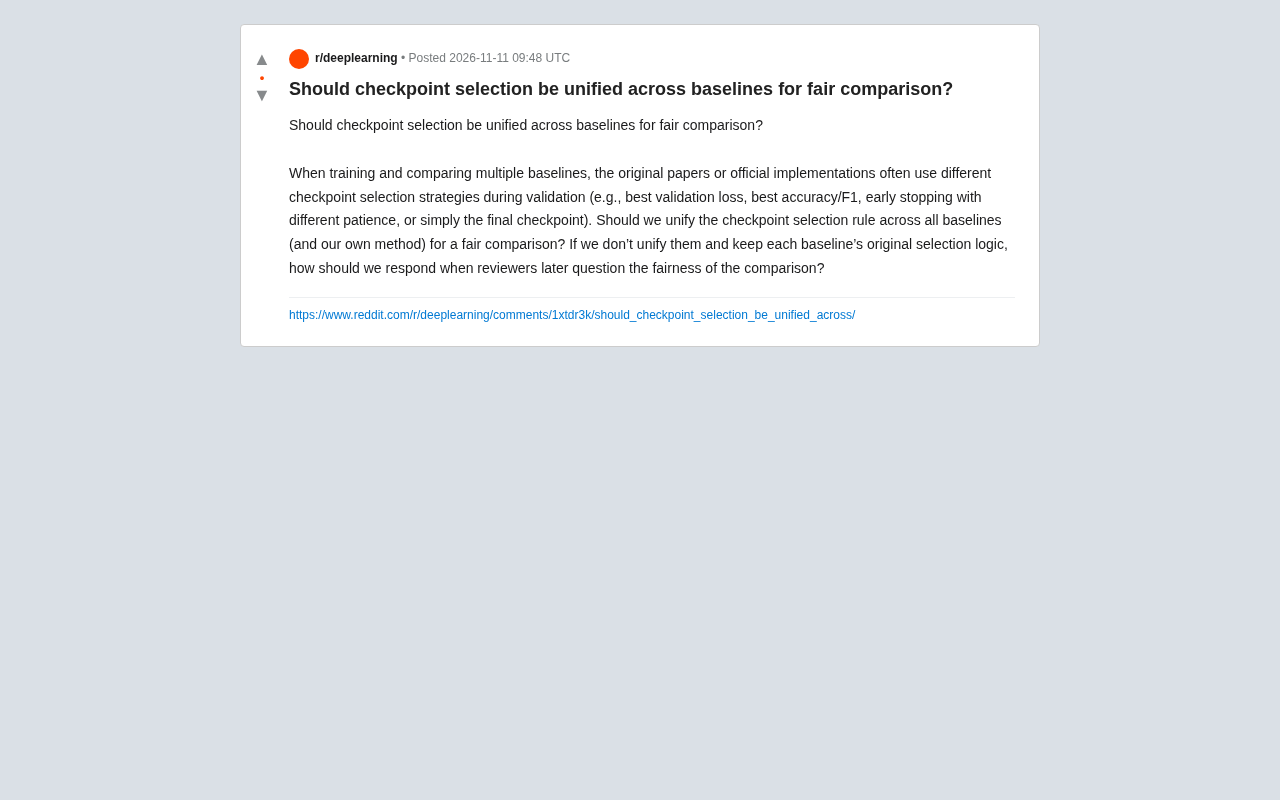
在机器学习论文的复现与对比实验中,有一个细节常常被忽略却直接影响结论的可信度:不同基线模型在验证阶段使用的检查点选择策略往往各不相同。最近Reddit上的一则讨论就抛出了这个尖锐问题——为了公平比较,我们是否应该统一所有基线(以及自己的方法)的检查点选择规则?如果不统一,又该如何回应审稿人对公平性的质疑?
问题的根源:基线自带的“选择性偏差”
官方实现中的策略差异
原始论文或官方代码在验证时采用的检查点选择方式五花八门:有的取验证损失最低的检查点,有的取验证准确率或F1最高的检查点,有的使用不同耐心值的早停,还有的干脆直接报告最后一个检查点。这些策略本身并无对错,但它们对最终性能的影响并不相同。
早停(Early Stopping) 是一种防止过拟合的常用技术:在训练过程中持续监控验证集上的某个指标(如验证损失),当该指标在连续若干轮(即“耐心值”,patience)内不再改善时,就提前终止训练并回滚到监控指标最优的检查点。耐心值的大小直接决定了模型在训练曲线上停下的位置——耐心值越大,模型越有可能在验证指标不再明显改善后继续训练,从而捕捉到后期可能出现的微小提升,但也增加了过拟合风险;耐心值越小,训练越早停止,可能错过最佳检查点。因此,即使两个模型架构相同,仅因早停耐心值不同,最终选出的检查点也可能对应不同的泛化性能。在基线比较中,若各基线使用不同的耐心值,性能差异就可能部分源于这一超参数的设置,而非模型本身的优劣。
为什么这会影响比较结论
验证损失和验证准确率并不总是同步变化,早停耐心值的差异会让模型在训练曲线上停在不同位置。当你在同一张表里比较多个基线时,如果每个基线都沿用其原始的选择逻辑,那么性能差异中可能混入了“选择策略”带来的增益或损失,而非模型本身的能力差异。这种混杂因素正是审稿人质疑公平性的常见切入点。
验证损失与验证准确率的不同步 是理解该问题的关键。验证损失(如交叉熵)衡量的是模型预测概率分布与真实标签之间的差异,而验证准确率(或F1)衡量的是硬分类决策的正确性。两者并不总是单调同步:模型可能在验证损失继续缓慢下降的同时,准确率已经趋于平缓甚至轻微下降,因为损失对预测置信度的变化更敏感。例如,模型可能对某些样本的预测概率变得更加极端(损失降低),但分类边界并未改变(准确率不变);反之,模型也可能在损失上升时准确率暂时提升。这种不同步意味着,以损失最低为准则选出的检查点,与以准确率最高为准则选出的检查点,可能是训练过程中不同阶段的模型,其测试性能自然可能存在差异。因此,在比较多个基线时,若它们分别采用不同的监控指标,性能差异中就混入了“选择指标”这一因素。
统一检查点选择:理想与现实的张力
统一规则的优势
从实验设计的角度看,统一检查点选择规则(例如全部采用验证损失最低的检查点,或全部使用相同的早停耐心值)能最大程度地隔离变量,让比较聚焦于模型架构或训练方法本身。这符合控制变量法的基本原则,也更容易在论文中清晰陈述。
统一规则的代价
但统一规则并非没有代价。某些基线模型的官方实现可能针对其特定的选择策略做过调优,强行统一可能让基线表现低于其声称的水平,从而引发“你削弱了基线”的反驳。另一方面,不同任务对检查点选择指标的敏感性不同,一刀切的做法未必适用于所有场景。
基线调优(baseline tuning) 指的是原论文作者针对其自身方法或基线模型进行的一系列超参数调整,包括学习率、批大小、正则化系数以及检查点选择策略等。这些调优往往是在特定数据集和任务上通过大量实验确定的,目的是让基线达到其报告的最佳性能。当复现者为了公平比较而强行统一检查点选择规则时,实际上改变了基线原本经过调优的配置,可能导致基线性能下降。例如,某个基线可能原本使用较大的早停耐心值并配合学习率衰减,从而在训练后期获得更优的验证准确率;若统一改为“验证损失最低”且耐心值较小,该基线可能过早停止,无法达到其宣称的水平。这种“削弱基线”的风险是统一规则的主要代价,也是审稿人可能提出质疑的地方。因此,在决定是否统一时,需要权衡控制变量与尊重基线原始调优状态之间的张力。
面对审稿质疑的回应策略
主实验统一,附录保留原始结果
一种折中方案是在主实验中统一检查点选择规则,同时在附录中报告各基线使用原始选择策略时的结果。这样既展示了受控比较,又保留了与原始论文的可比性。审稿人若质疑公平性,可以指出主实验已控制该变量,附录则提供了更全面的视角。
消融实验(Ablation Study) 在机器学习论文中用于验证某个组件或策略对最终性能的贡献。具体到检查点选择问题,消融实验可以设计为:在固定模型架构和训练超参数的前提下,仅改变检查点选择规则(如分别采用验证损失最低、验证准确率最高、固定耐心值早停、最后检查点等),观察各基线及自身方法在这些规则下的性能变化。通过这种消融,研究者能够量化“选择策略”这一因素对比较结果的影响程度:如果不同规则下各模型的相对排名保持稳定,则说明结论对该因素不敏感,公平性质疑可以被有效回应;如果排名发生显著变化,则需进一步分析原因并在论文中讨论。消融实验比单纯的文字辩护更有说服力,因为它提供了实证数据,让审稿人能够自行判断结论的稳健性。
透明报告选择策略
无论是否统一,都应在论文中明确列出每个基线所使用的检查点选择策略。透明度本身就是对公平性质疑的一种回应——当读者清楚知道差异来源时,他们可以自行判断结论的稳健性。
多源视角下的共识与分歧
据Reddit讨论中的多位研究者观点,统一检查点选择在原则上是更严谨的做法,但实际操作中需要权衡基线的原始调优状态。有观点认为,如果审稿人质疑公平性,最有力的回应是补充一组统一选择规则的消融实验,而非仅靠文字辩护。也有研究者指出,在部分领域,社区已默认接受“各基线沿用原始策略”的做法,此时强行统一反而可能偏离惯例。这些分歧说明,该问题尚无放之四海而皆准的答案,关键在于实验设计的透明度和论证的一致性。
实践建议
对于准备投稿或复现实验的研究者,可以遵循以下思路:优先在主实验中统一检查点选择规则,并在实验设置部分明确说明;对于官方实现调优较强的基线,考虑在附录中补充原始策略下的结果;面对审稿质疑时,用额外的消融实验而非单纯辩解来回应。检查点选择看似是实验细节,却直接关系到比较结论的可信度,值得在论文中给予足够重视。
相关推荐

美国新车均价突破5.1万美元:AI与软件定义汽车如何推高成本
美国新车平均价格突破5.1万美元创历史新高。本文从软件定义汽车、中央计算架构、辅助驾驶传感器预埋与车端AI推理成本角度,分析AI与软件如何推高整车售价,以及这一趋势对消费者和厂商的影响。
Anthropic无预警移除Claude Code功能,开发者社区不满
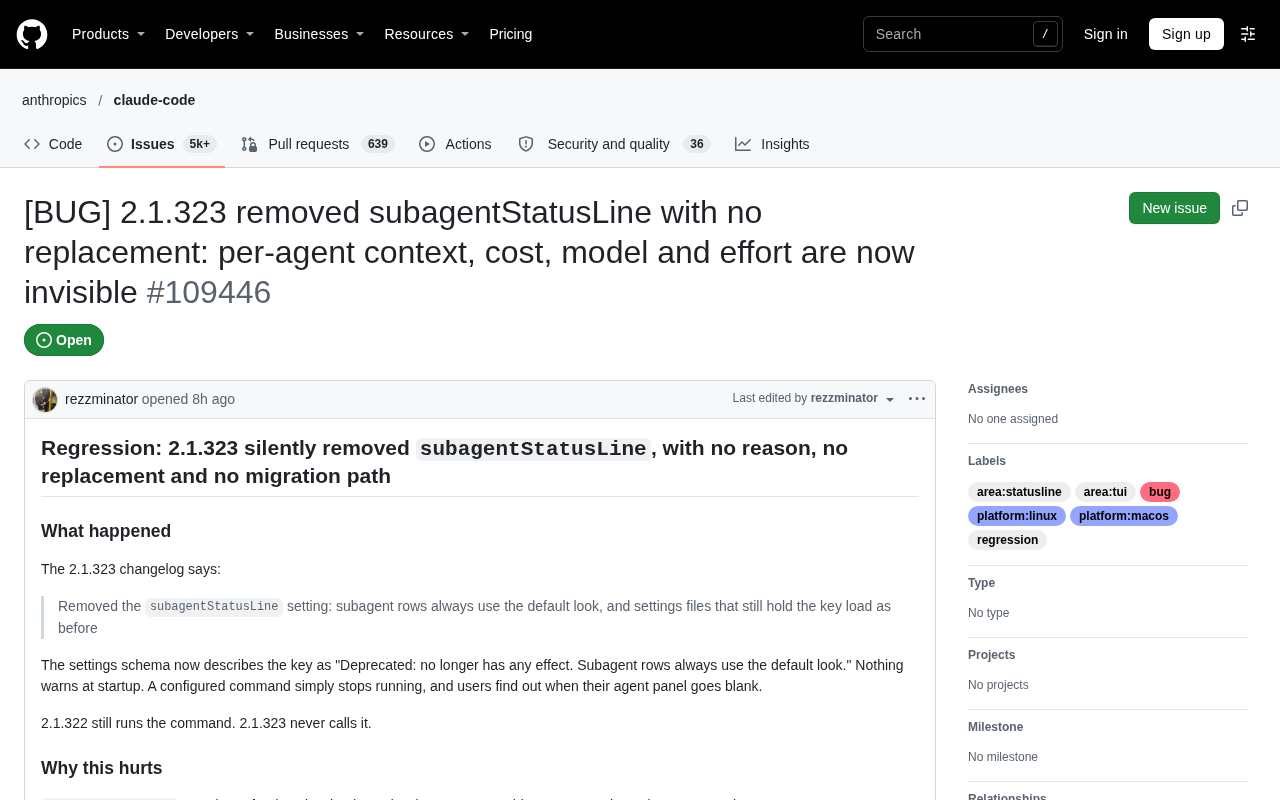
Anthropic无预警移除Claude Code功能引发开发者不满。本文分析事件经过、开发者敏感原因及对AI编程工具生态的启示,探讨厂商如何平衡迭代与用户信任。
MAFM:流匹配生成中的物理约束新解法
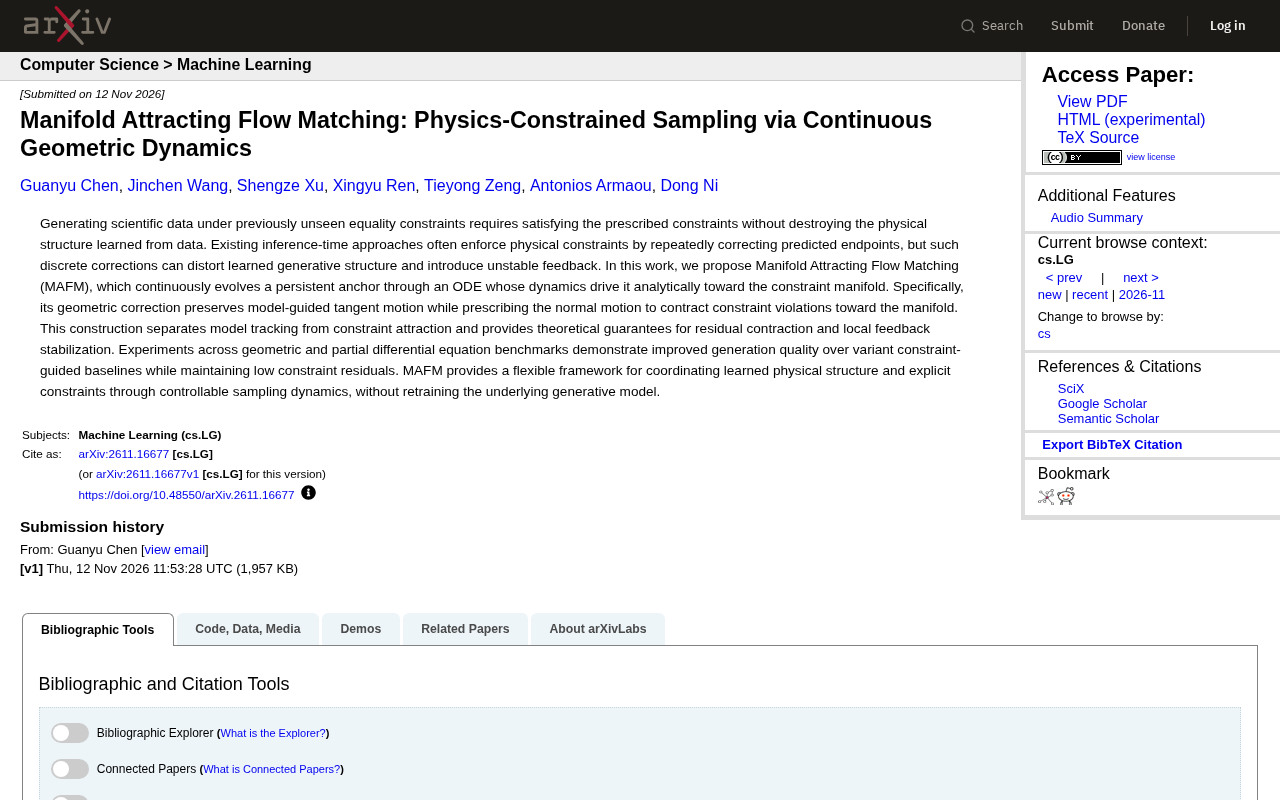
MAFM提出用连续几何动力学替代离散校正,在流匹配生成中实现物理约束满足。本文解析其切向/法向运动解耦机制、理论保证与实验表现,并讨论局限与展望。