机制可解释性如何为AI安全兜底:一篇综述的深度拆解

综述系统梳理机制可解释性如何为AI安全提供因果证据,并评估其局限。
这篇综述围绕“理解模型内部机制能否真正提升AI安全”展开,系统梳理了机制可解释性的研究版图。文章首先对比机制证据与行为评估:后者依赖输入输出测试,难以覆盖训练分布外的新情境,而前者试图提供行为背后的因果解释。随后介绍特征、多义性、Transformer计算与电路等基础概念,并覆盖特征提取、电路发现、因果验证、自然语言解释、学习动力学与训练数据归因等方法链条。综述提出统一框架评估可解释性主张的可靠性,并按目标、假设与权衡划分六种研究取向。最后讨论知识编辑、引导与监控三类安全应用,坦率评估其局限与失效模式,并附带可复现的代码笔记本仓库。
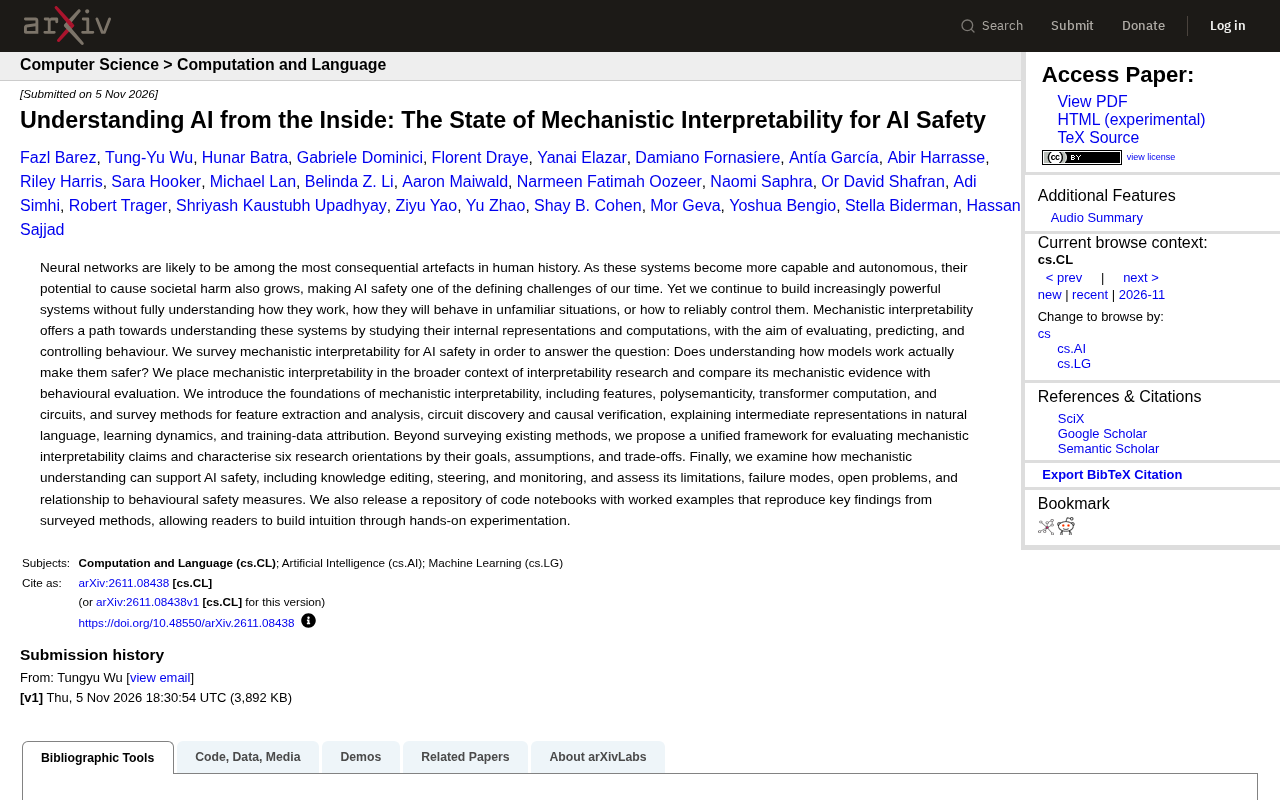
神经网络可能是人类历史上最具影响力的造物之一。随着系统能力与自主性提升,潜在的社会危害同步放大,AI安全成为这个时代的关键命题。但现实是,我们仍在缺乏完整理解的前提下构建越来越强大的系统——不清楚它们内部如何运作、在陌生情境中会如何表现、又该如何可靠控制。一篇聚焦AI安全的机制可解释性(Mechanistic Interpretability)综述试图回答一个直白却沉重的问题:理解模型如何工作,真的能让它更安全吗?
可解释性的两条路线:机制证据 vs 行为评估
综述首先把机制可解释性放回可解释性研究的大版图中,并与其对照物——行为评估——做了系统比较。行为评估通过输入输出层面的测试来判断模型是否安全,优点是直观、可规模化,缺点是无法覆盖训练分布之外的新情境:模型可能在某些测试中表现良好,却在未见过的情况下做出危险行为,而行为测试对此几乎无能为力。
机制可解释性走的是另一条路:拆开模型内部,研究其表征与计算过程,用机制层面的证据去评估、预测并控制行为。这种证据的价值在于它不依赖"碰巧测到",而是试图给出行为背后的因果解释。综述的核心贡献之一,就是提出一个统一框架来评估机制可解释性主张的可靠性——毕竟,一个可解释性结论如果本身无法验证,它对安全的价值就无从谈起。
基础概念:特征、多义性与电路
要理解机制可解释性,需要先掌握几个基础构件。综述系统介绍了特征(features)、多义性(polysemanticity)、Transformer计算过程以及电路(circuits)等概念。
特征可以理解为模型内部表征的语义单元;多义性则指单个神经元或方向往往同时编码多个不相关的概念,这给"读出"模型内部含义带来根本困难;电路则是特征之间协同完成特定计算任务的连接结构。这几个概念共同构成了机制可解释性的分析语言——从微观的语义单元到宏观的计算回路,研究者试图在不同粒度上还原模型的行为机制。
机制可解释性(Mechanistic Interpretability) 是可解释性研究的一个分支,其目标是将神经网络的内部计算逆向工程为人类可理解的算法或电路。与传统的事后可解释性方法(如显著性图、LIME)不同,它不满足于找出“哪些输入影响了输出”,而是试图精确描述模型内部每一层、每一个组件执行的具体运算,以及这些运算如何组合成完整的行为。这一领域常借用神经科学的隐喻:正如研究者通过探针记录神经元活动来理解大脑,机制可解释性通过激活值、注意力模式和权重分析来“读取”网络。其核心信念是,只有理解模型内部的因果结构,才能可靠地预测模型在新情境下的行为,并实施精准干预。
方法全景:从特征提取到训练数据归因
综述覆盖的方法链条相当完整。特征提取与分析解决"模型内部有什么"的问题;电路发现与因果验证解决"哪些结构真正导致了行为"的问题,其中因果验证尤为关键,它把相关性观察与因果机制区分开来。
在此之上,还有几条延伸路径:用自然语言解释中间表征,让人类可读地理解模型内部状态;研究学习动力学,追踪训练过程中机制如何形成;以及训练数据归因,把模型行为回溯到具体训练数据。这些方法共同回答的不只是"模型内部长什么样",更是"这种内部结构从哪里来、又会导向什么行为"。
综述还提出了六种研究取向的分类,按各自的目标、假设与权衡进行刻画。这一分类的意义在于:不同取向对"什么是好的解释"有不同标准,混用标准会导致结论无法互相验证。
因果验证(Causal Verification) 在机制可解释性中特指用干预实验来检验所发现的内部结构是否真的对行为负责,而非仅仅与行为相关。常用手段包括消融(ablation,移除某组件或方向并观察输出变化)、激活修补(activation patching,将一个输入的内部激活替换到另一个输入中)和路径修补(path patching)。这些方法借鉴了因果推断中的干预思想:如果改变内部状态能可预测地改变输出,则说明该状态具有因果作用。综述强调因果验证是区分“看似合理的解释”与“经过检验的机制”的关键步骤,也是评估可解释性主张可靠性的核心环节。
从理解到干预:机制知识如何服务安全
综述最后把机制理解与安全实践连接起来,讨论了三类应用:知识编辑、引导(steering)与监控。知识编辑试图在机制层面修正模型中的特定知识;引导通过干预内部表征来改变模型行为方向;监控则利用对内部状态的理解来发现异常或危险信号。
这些应用展示了机制可解释性的实际安全价值——它不只是"看懂",还能"动手"。但综述同样坦率地评估了其局限、失效模式与开放问题,并讨论了机制方法与行为安全措施之间的关系。机制理解并不能替代行为评估,二者更像是互补:机制证据提供因果解释与预测能力,行为证据提供现实校验。
引导(Steering) 是一类通过直接干预模型内部表征来改变其行为的技术。典型做法是在前向传播过程中,向特定层的激活向量加上一个“引导向量”(steering vector),该向量通常由对比正反例的激活差异计算得到,例如“诚实”与“不诚实”回答的平均激活之差。引导的吸引力在于无需重新训练即可调整模型倾向,且比提示词更直接地作用于内部状态;其风险在于干预可能产生非预期的副作用,例如同时改变不相关的行为维度。综述将引导与知识编辑、监控并列为机制理解的安全应用,但也指出其效果依赖于对内部表征语义的准确把握。
一个值得注意的工程细节
综述附带发布了一个代码笔记本仓库,用可运行的示例复现所调查方法的关键发现。对想建立直觉的读者来说,这比单纯阅读论文更有效——机制可解释性的很多概念(多义性、电路、因果验证)只有在动手实验后才真正落地。这也呼应了综述的立场:可解释性主张需要可复现、可验证,而代码是验证的一部分。
相关推荐

Ollama选模型完全指南:从配置到量化避坑
Ollama选模型完全指南:从查看电脑配置到逛官方模型库,详解Tools、Thinking、Vision、Decision等标签含义,以及参数规模、量化精度与上下文缓存的取舍策略,助你避开卡死闪退的坑。

Ollama默认安全吗?显卡被白嫖的真相与自查指南
Ollama 默认只绑回环地址,但改一句环境变量或照抄 Docker 命令就可能让显卡暴露。本文解析显卡被白嫖的原理、扫描规模与 DNS 重绑定路径,并给出自查与修复的三层方案。

Cherry Studio+MCP实战:搭建自动化AI智能体与本地知识库
基于B站Cherry Studio教程,详解如何配置MCP环境、搭建网页抓取与报告生成等自动化AI智能体,并用Ollama+千问3搭建本地知识库,附实际操作中的踩坑经验。