加密托管运行LLM:数据零泄露的安全模型访问方案
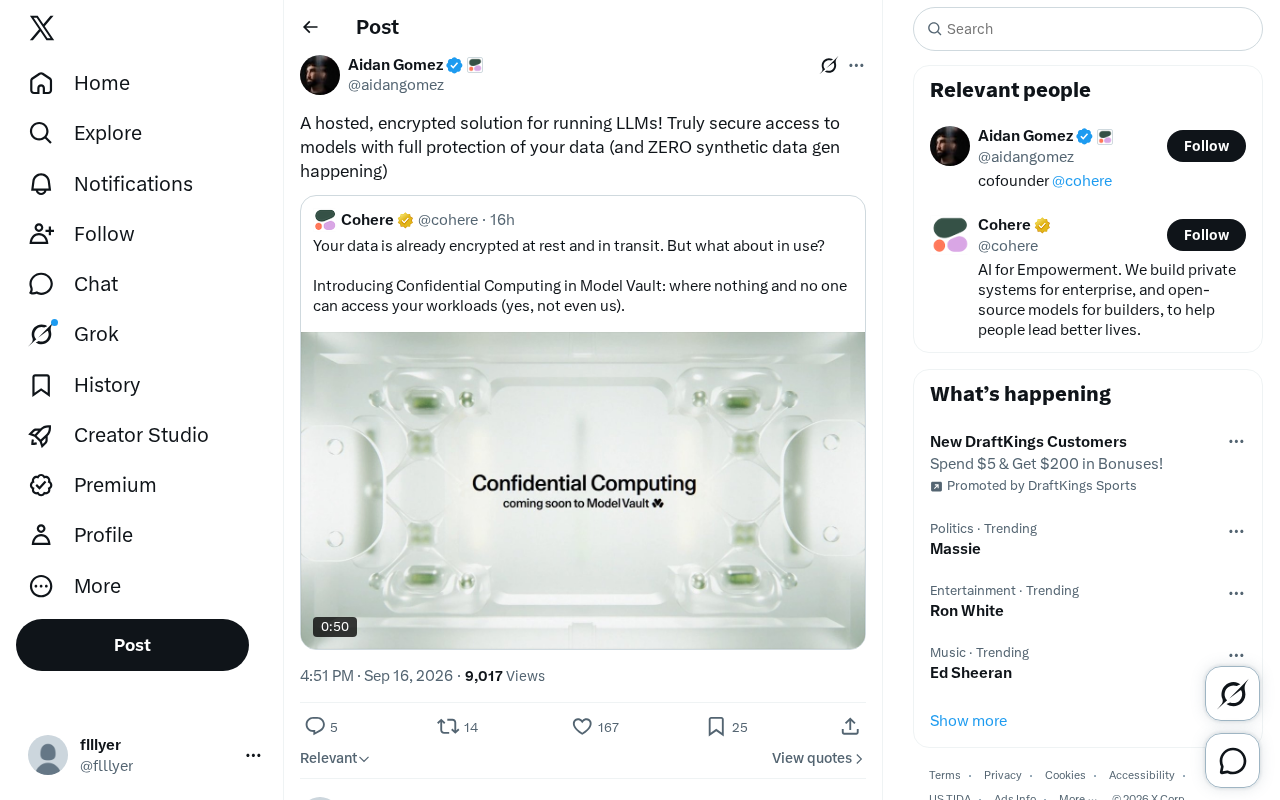
加密托管LLM方案通过技术手段将数据隐私从口头承诺转变为可强制执行的架构约束。
随着大语言模型深度嵌入企业工作流,数据安全从「服务商承诺」升级为「技术强制」的需求日益迫切。本文围绕一种托管式加密LLM方案展开分析:其核心价值在于借助机密计算、端到端加密等技术,使服务商在运营层面也无法读取用户原始数据;同时通过「零合成数据生成」承诺,切断用户输入进入模型训练循环的路径。文章进一步指出,评估此类方案需追问四个关键维度:加密的具体形式(TLS、TEE还是同态加密)、承诺的可验证性(第三方审计、远程证明)、性能与安全的平衡,以及所支持的模型范围。文章最终判断:隐私优先正从AI服务的加分项演变为必选项,能在「强大能力」与「可验证隐私」之间取得平衡的服务将具备更强市场竞争力。
隐私困境:使用大模型时你的数据去了哪里
当越来越多的企业和个人依赖大语言模型(LLM)处理日常工作时,一个被反复提及却难以彻底解决的问题浮出水面:你输入模型的数据究竟安全吗?无论是财务报表、客户信息还是内部代码,一旦提交给云端模型服务,用户往往失去了对数据流向的控制权。
这条来自 Twitter 的分享,指向了一种新的解决思路——托管式加密方案(hosted, encrypted solution),声称能够在运行 LLM 的同时,实现对用户数据的完整保护,并且承诺「零合成数据生成」(ZERO synthetic data generation)。这看似简短的描述,实际上触及了当前 AI 服务中最敏感的信任问题。
加密托管方案解决了什么
传统的云端 LLM 服务模式下,用户数据以明文形式传输到服务商的服务器进行推理计算。即便服务商声明不会存储数据,用户也只能选择信任,缺乏技术层面的强制保障。
所谓「加密托管」的核心价值,在于把安全性从「政策承诺」转变为「技术约束」。通过加密手段处理数据,理论上即使是托管服务的运营方,也无法直接读取用户输入的原始内容。这类方案通常涉及传输加密、存储加密,乃至更前沿的机密计算(confidential computing)或加密推理技术,让数据在整个生命周期内保持受保护状态。
对于金融、医疗、法律等对合规要求极高的行业而言,这种「服务商也看不到数据」的架构,往往是能否合法使用 AI 工具的关键前提。
机密计算(Confidential Computing)是其中最具技术含量的一环,值得单独说明。它依赖CPU厂商(如Intel SGX、AMD SEV)提供的可信执行环境(TEE,Trusted Execution Environment):数据在一个硬件隔离的「飞地(enclave)」内完成解密与计算,即便是云服务商的运维人员、虚拟机管理层(hypervisor)乃至操作系统内核,也无法访问飞地内部的明文数据。与之形成对比的是同态加密(Homomorphic Encryption),它允许在完全不解密的状态下对密文直接执行计算,理论上安全性更高,但目前计算开销仍比明文推理高出数个数量级,尚难用于生产级LLM推理。大多数实际落地的「加密托管」方案,目前主要依赖TEE而非同态加密。理解这一区别,有助于判断服务商的技术路径是否成熟可行。
「零合成数据生成」意味着什么
原文中特别强调的 ZERO synthetic data generation,是一个值得展开的承诺。
在许多 AI 服务的商业模式中,用户交互数据会被用于生成合成训练数据,进而反哺模型优化。这一过程虽然有助于模型迭代,却也意味着用户的输入内容可能被间接「学习」和留存。对隐私敏感的用户来说,这是一个潜在的风险点——你今天输入的商业机密,可能以某种衍生形式进入了模型的训练循环。
明确承诺「零合成数据生成」,等于向用户保证:你的数据仅用于当次推理,不会被转化、留存或用于任何形式的模型训练。这在数据主权日益受重视的当下,是一个有分量的差异化卖点。
**合成数据(Synthetic Data)**在AI训练中的具体生成方式值得了解。常见做法是让模型基于真实用户对话进行改写、扩充或角色转换,产出大量「形式上虚构、语义上保留原始信息」的训练样本。这类数据在技术上已与原始输入脱钩,因此服务商往往认为无需征得用户同意。然而对于企业用户而言,即便是经过改写的衍生数据,依然可能泄露竞争敏感的业务逻辑、客户偏好或内部术语。部分监管框架(如欧盟GDPR)已开始讨论合成数据是否属于个人数据的衍生物,相关法律边界仍在演进中。因此「零合成数据」的承诺,在法律合规层面与技术安全层面都具有独立意义。
技术承诺背后需要验证的问题
提一嘴,这条推文本身信息量有限,更多是一种产品理念的宣示,而非详尽的技术白皮书。围绕这类方案,用户在实际选型时应当追问几个关键问题:
- 加密的具体形式:是仅传输层加密(TLS),还是端到端加密,抑或是能在密文上直接计算的同态加密?不同技术的安全强度差异巨大。
- 可验证性:服务商的「零访问」承诺是否可通过第三方审计、开源代码或可信执行环境(TEE)等方式验证,而非单纯的口头保证。
- 性能代价:加密计算通常会带来延迟和成本上升,托管方案如何在安全与体验之间取得平衡。
- 模型选择范围:加密托管支持哪些模型,是否覆盖主流开源与商用模型。
关于第三方审计与可验证性,目前业界有几种主流路径。SOC 2 Type II认证是云服务中最常见的合规报告,验证服务商的安全控制流程,但并不直接证明「数据不可读」。更强的验证方式包括:开放TEE代码供独立安全研究者审查、提供远程证明(Remote Attestation)机制——让用户在每次会话前密码学验证飞地代码未被篡改,以及通过漏洞赏金计划持续接受外部挑战。对于高敏感度场景,仅凭一份SOC 2报告往往不足够,用户应主动询问服务商是否支持远程证明,这是目前TEE方案中最具技术说服力的可验证手段。
隐私优先的 AI 服务正在成为趋势
这条分享虽短,却折射出一个明确的行业方向:随着 LLM 深度嵌入生产流程,数据隐私与安全正从「加分项」变为「必选项」。用户不再满足于「我们承诺不看你的数据」,而是要求「从技术上你根本看不到」。
无论是加密托管、本地部署,还是机密计算方案,本质上都在回应同一个诉求——让用户在享受大模型能力的同时,重新掌握对自身数据的控制权。可以预见,未来能在「强大能力」与「可验证的隐私保护」之间取得平衡的服务,将获得更强的市场竞争力。
对于正在评估 AI 工具的团队而言,与其被营销话术吸引,不如以本文提到的几个技术维度作为清单,逐项验证服务商的真实能力。安全承诺的价值,最终取决于它能否被证明。
相关推荐
Cursor是什么?AI编程工具与传统IDE的核心区别
Cursor是什么?本文详解这款内置AI助手的编程工具,对比它与VS Code等传统IDE在代码补全、生成、重构、错误处理上的核心区别,并分析Cursor集成Claude、DeepSeek等大模型的特性及适用人群。
Coze扣子3.0入门指南:智能体与AI应用全景解析
Coze扣子3.0入门教程:解析字节跳动AI开发平台的智能体、AI应用、工作流与插件体系,涵盖单Agent与多Agent协作,并对比Coze与Dify的差异,帮助零基础用户快速搭建AI智能体。
DeepSeek Harness 环境搭建:Node.js 安装与配置全流程
零基础搭建 DeepSeek Harness 运行环境的完整教程,涵盖 Node.js 安装、Add to PATH 勾选、npm 全局目录与缓存目录迁移,以及系统环境变量配置全流程,附常见踩坑提示。