简单循环登顶自动定理证明:苦涩教训再验证

极简测试时扩展循环 H1 在同等模型与预算下媲美甚至超越复杂定制定理证明系统,印证苦涩教训。
论文《A Taste of the Bitter Lesson in Automated Theorem Proving》对比了自动定理证明的两条路线:为大模型设计复杂人类定制工作流,与仅依赖模型自身推理和测试时扩展。作者提出极简 Harness H1——只提供高效 Lean 工具接口,模型在 ReAct 循环中推理、调用工具、提交验证,失败后由反思模型压缩反馈并继续迭代,不预设任何证明结构。在匹配模型与可比推理成本下,H1 经常帕累托优于定制系统,在 Putnam、IMO2026 等基准取得 SOTA 并解决 8 个公开猜想;顺序扩展中延长单次尝试比重复多次更省成本;同为简单循环,接口质量与反思设计仍造成巨大差距。
自动定理证明领域长期存在两条路线之争:一条是围绕大模型设计复杂的人类定制工作流,另一条是让模型依赖自身的推理与测试时扩展能力。最近一篇名为《A Taste of the Bitter Lesson in Automated Theorem Proving》的论文给出了一个颠覆性的结论:一个极简的测试时扩展循环,在匹配模型和可比预算下,经常能匹配甚至超越那些精心设计的定制系统。这为 Sutton 提出的「苦涩教训」假说在形式化数学领域提供了有力佐证。
两条路线与一个核心问题
据 B 站播客节目介绍,当前自动定理证明的进展主要沿着两个方向推进。一是利用大模型本身的思维链和推理能力进行扩展;二是围绕大模型设计包含规划、分解、证明、细化等步骤的复杂工作流。主流形式化证明工具如 Lean 本身支持结构化的证明搜索,许多研究便利用这一特性构建了复杂的 Harness 框架,相当于给模型框定了一套固定的解题步骤。
矛盾在于,前沿大模型已经具备很强的推理和测试时扩展能力。如果抛开复杂的定制工作流,仅用一个简单的测试时扩展循环,能否达到复杂系统相当甚至更好的效果?这就是论文要回答的核心问题。
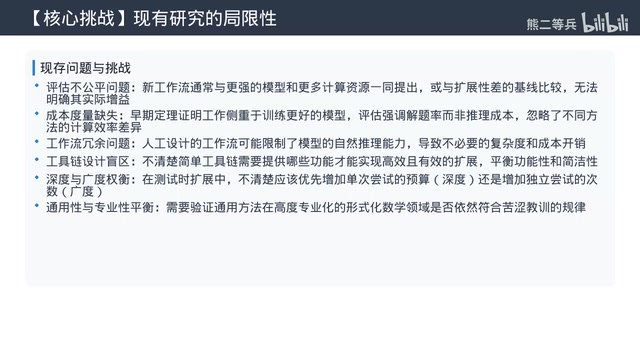
该问题的现实意义不容小觑。前沿大模型已能生成不少研究级别的数学成果,但这些成果的非形式化论证难以人工验证,自动定理证明的可机械校验特性因此成为自动化发现的必要组件。此前许多研究在对比不同系统时,常常将更强的模型、更多的计算资源和新的工作流混在一起推出,或者与扩展能力很差的基线对比,导致无法厘清性能提升究竟来自工作流设计还是来自测试时计算投入。
Lean 与 Mathlib:Lean 是一种依赖类型论的交互式定理证明器,其证明项会被内核逐行机械校验,只要类型检查通过,命题即为真——这正是自动定理证明区别于非形式化数学的关键。Mathlib 是 Lean 社区共建的巨型数学库,收录了从基础代数、拓扑到分析的大量已形式化定理与引理,构成了模型可检索、可复用的「结构化资源环境」。论文中 H1 依赖的 Lean Explorer、Lean REPL 与语言服务器,本质上都是在 Mathlib 之上提供搜索、片段测试与目标状态查询的接口,因此模型能否高效调用这些工具,直接决定了它在单次预算内能探索多大的证明空间。
H1:极简循环的设计哲学
为剥离工作流设计的影响,论文作者设计了一个名为 H1 的极简 Harness。它只提供一个高效的 Linux 接口,完全不预设任何分解或搜索结构。模型不断迭代推理、调用工具、提交验证,失败后将反馈整理成新的上下文继续尝试,直到成功或达到成本上限。每次迭代相当于给模型的思考过程追加了一段「等一下我再想想」的时间,完全依靠扩展测试时计算量来提升性能。
H1 的每一轮迭代中,大模型用 ReAct 循环进行推理和工具调用。若验证失败,一个专门的反思模型会将整个对话历史和反馈压缩成结构化的摘要,包含已验证的进展、失败尝试的教训、有用的引理名称,并提示模型不要轻易放弃。模型随后带着摘要从当前文件继续工作。整个过程不预设任何证明结构,完全由模型自主决定推进方式。
H1 提供的工具均来自 Lean 生态:用于搜索 Mathlib 的 Lean Explorer、测试证明片段的 Lean REPL、报告目标和定义的语言服务器,以及最终验证用的 Safe Verify。模型可以自行决定何时使用何种工具,无需人类规定调用顺序和使用场景。
三大核心结论与实验证据
论文的核心结论可归纳为三点,每个结论都有相应的实验数据支撑。
结论一:简单测试时扩展即可达到前沿水平
在匹配相同模型和可比预算的情况下,H1 经常能匹配甚至帕累托优于定制化的专业系统,并在多个基准测试上取得 state of the art 的结果,还解决了八个公开的猜想问题。
具体来看,在 Putnam Bench 基准上,H1 与 Goedel Architect 使用相同模型时成本更低但表现更好。用 GPT 5.6 Sol 时,H1 在 FateX 上做到 90-100 的解决率,FC100 Soft 上 178%,Formal Core Bench 上 23-14%,IMO2026 的 6 道题全部做出来,Putnam Bench 的 672 道题里做对了 670 道。即使用开源模型,GPT 4.6 V4 Flash 搭配 H1 在 X 线上做到 43% 的解决率,超过专门优化过的 LeanStraw 1.5 的 34%。
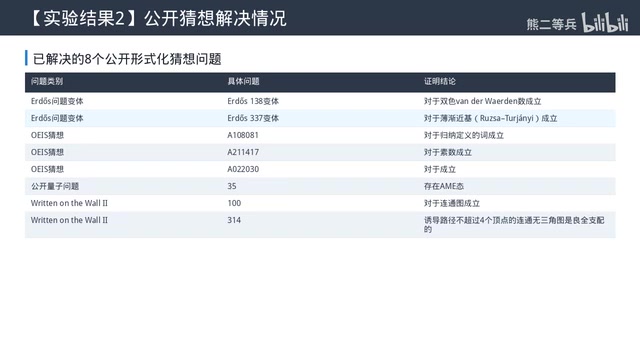
在公开猜想方面,论文测试了 236 个来自 Formal Conjectures 的问题,H1 用 GPT 5.6 Sol 解决了其中 8 个,包括 Erdos 138 和 337 的变体、3 个 OEIS 猜想、开放量子问题 35 里的 AME910 太存在性证明,以及两个 Written on the Wall 2 的猜想。H1 甚至发现了 Formal Conjectures 里的几个形式化错误——写出的形式化命题与原本想表达的猜想不一致,例如庞加莱猜想的形式化漏了一个假设,H1 直接给出了该错误形式化命题的反证。这些错误已被上游修复。
结论二:延长单次尝试比重复多次更高效
这一结论反直觉。通常认为多跑几次独立尝试、用 pass@k 的方式总能提高成功率,但论文发现在顺序测试时扩展的情况下,pass@1 的曲线随预算增加甚至能帕累托优于 pass@k。
在五个公开的 Erdos 问题上,用相同的 Gemini 3.1 Pro 模型,给 H1 单次尝试更高的预算,最后在 121 美元时解决率达到 82.5%,而 APN Basic 要跑三次才能到 75.4%,成本是 191 美元;完整的 AlphaProof Nexus 要到 76% 的解决率需要花 317 美元。即便把失败尝试的成本都算进去,H1 单次尝试达到 82.5% 的解决率平均每个问题花 138 美元,而跑三次重复要花 202 美元才能达到同样的解决率。
论文同时指出,这一平衡并非绝对:预算特别高时,重复尝试的解决率会更高。深度与广度的最优平衡取决于预算、解决率和问题类型,论文建议把这个选择交给模型自己,而不是人类提前设定固定的预算或尝试次数。
pass@k 与 pass@1 的预算含义:pass@k 指独立采样 k 次、只要有一次成功即算解决,是代码生成与定理证明中常用的评估口径;pass@1 则是单次尝试的成功率。问题在于,两者在「同等计算预算」下并不可比:k 次独立尝试每次都从空白上下文重新开始,失败尝试的经验被完全丢弃;而顺序测试时扩展把预算集中到一条轨迹上,失败后的反思摘要会被带入下一轮,形成可累积的上下文。论文提出的帕累托比较正是把横轴统一为 API 等价成本,再比较各预算点上的解决率,从而暴露出「深度优先」在中等预算区间的成本优势,以及预算极高时「广度优先」反超的边界。
结论三:简单不等于随便设计
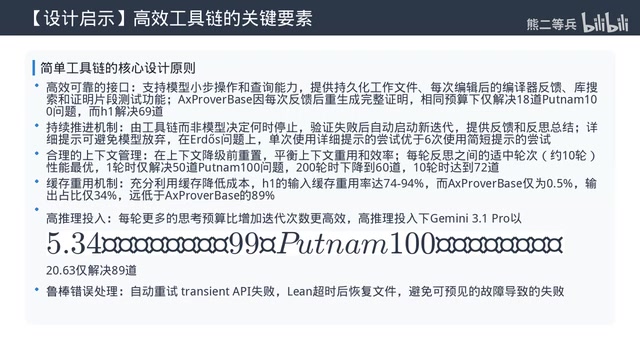
同样都是简单循环,不同 Harness 设计在解决率和成本上差异巨大。H1 和 AX Prover Base 用相同的 Gemini 3 Flash 模型、20 美元预算下,H1 在 Putnam 100 上能解决 69 道题,AX Prover Base 只能解决 18 道。核心差异在于 H1 支持渐进式编辑文件,每次编辑都能得到即时反馈,而 AX Prover Base 每次都要重新生成完整证明,大量时间浪费在无效的导入错误上。
论文通过对照实验发现,高效可靠的 Lean 接口、支持修复和反思的循环、高效的推理和缓存复用,这些设计点对性能影响极大。此外,详细的提示词能大幅提升表现:在 6 个 Erdos 问题上,用详细证明和反思提示词的单次尝试比用简略提示词跑 6 次的效果还好。两次反思之间的轮数也有最优区间,太多或太少都会降低效率。
渐进式编辑与全量重写:在 Lean 中,一个文件顶部的 import 或定义一旦出错,后续所有内容都无法通过检查。渐进式编辑允许模型只改动局部片段并立即在 Lean REPL 中得到反馈,错误定位精确到行,修复成本低;而全量重写要求模型每轮重新输出完整证明,任何一处导入或语法错误都会让整份文件作废,token 大量消耗在重复生成上。这正是 H1 与 AX Prover Base 在相同模型、相同预算下解决率相差近四倍的主要来源,也说明「极简」指的是不预设证明结构,而非省略高质量的工程接口。
公平对比的方法论
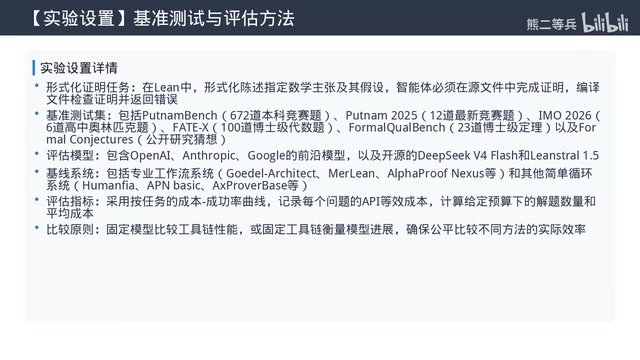
论文在实验设计上特别强调了按推理成本对比的重要性。不同系统的单次尝试计算量差异极大,例如 Goedel Architect 一次尝试允许最多 16 次证明计划修订,XProver Base 的一次尝试允许 50 次智能体迭代,同样叫 pass@1,计算成本差了好几个量级。
因此论文固定模型时比较不同 Harness 的效率,固定 Harness 时比较不同模型的进步,所有成本按实际 Token 用量换算成 API 等价成本,每个问题的成本上限设为 B,统计预算内得到验证证明的问题数量,平均成本包含所有成功和失败的尝试。测试环境用 Lean4 和 Mathlib 库,验证工具用 Safe Verify 确保最终证明完全符合原始命题,不会出现遗漏假设或用未完成步骤占位的情况。基准集覆盖本科水平的 Putnam、高中奥林匹克级别的 IMO2026、博士资格考试难度的 FateX 和 Formal Core Bench,以及没有已知解的公开形式化猜想。
对智能体设计的启示
这项研究的意义不止于自动定理证明。据播客总结,任何需要与验证器交互、在丰富结构化资源环境中工作的智能体——软件验证、大型代码库编程等场景——都可以借鉴这一思路:不需要给模型设计复杂的工作流,只要提供高效可靠的环境接口和持续的反馈机制,让它自主推进任务,效果反而可能更好。
论文中还有一个值得关注的案例:2025 年 Putnam 竞赛的 A5 题,之前的 Numina 系统为解这道题专门设计了子代理工作流,用协调器分配蓝图、分解、草稿、证明等任务给不同子代理,还要用 GPT5.2 提供提示,预算是 1000 美元;而 GPT5.2 在 H1 里单轮尝试就解决了这道题,只花了 81.52 美元。若单次 H1 跑不出来,简单重复跑几次大部分差距就能补上,无需任何工作流调整,只是从空白上下文重新跑。2025 年 Putnam 的 12 道题,H1 用 Opus4.7 单次跑出 11 道,重试剩下的一道 6 次就全部解决,比专门的定制系统成本还低。
即便遇到重复也补不上的差距,只要更新到下一代模型就能追上。Formal Core Bench 上 Merlin 用 Opus4.7 做到 23 分之 10,H1 用 Opus4.7 最多到 23 分之 9;但换成 Opus4.8 之后,H1 直接做到 23 分之 13,成本还比 Merlin 低一半多。这是苦涩教训的典型表现:模型本身的能力提升会直接惠及通用的简单框架。
在形式化数学领域,可扩展的通用简单框架最终会超过定制化的复杂工作流。这一结论再次验证了 Sutton 的苦涩教训假说,也为未来智能体设计提供了有价值的参考方向。
相关推荐

黄仁勋卸任后,微软CEO纳德拉为何依然力挺英伟达?
微软CEO纳德拉公开表示对英伟达临时CEO科莱特·克雷斯充满信心。本文分析黄仁勋卸任后英伟达的权力交接、微软的算力依赖以及AI供应链的信任逻辑。

纳德拉:关键基础设施“无法修补”,AI网络安全攻防升级
微软CEO纳德拉回应AI网络攻击担忧,指出大量关键基础设施处于无法修补状态,同时淡化Outlook中断事件,并分析AI在网络安全中的攻防双重角色。

马斯克力挺黄仁勋:解雇他如同踢走乔丹
马斯克公开表示黄仁勋对美国忠诚,并用“踢走乔丹”比喻解雇黄仁勋的荒谬性,折射AI芯片行业政治化焦虑与科技界对人才价值的捍卫。