检索片段训练法:406M小模型在会议摘要上媲美1.2B系统
统一评测框架揭示:针对检索片段微调的406M小模型,效果可媲美参数量三倍的1.2B系统
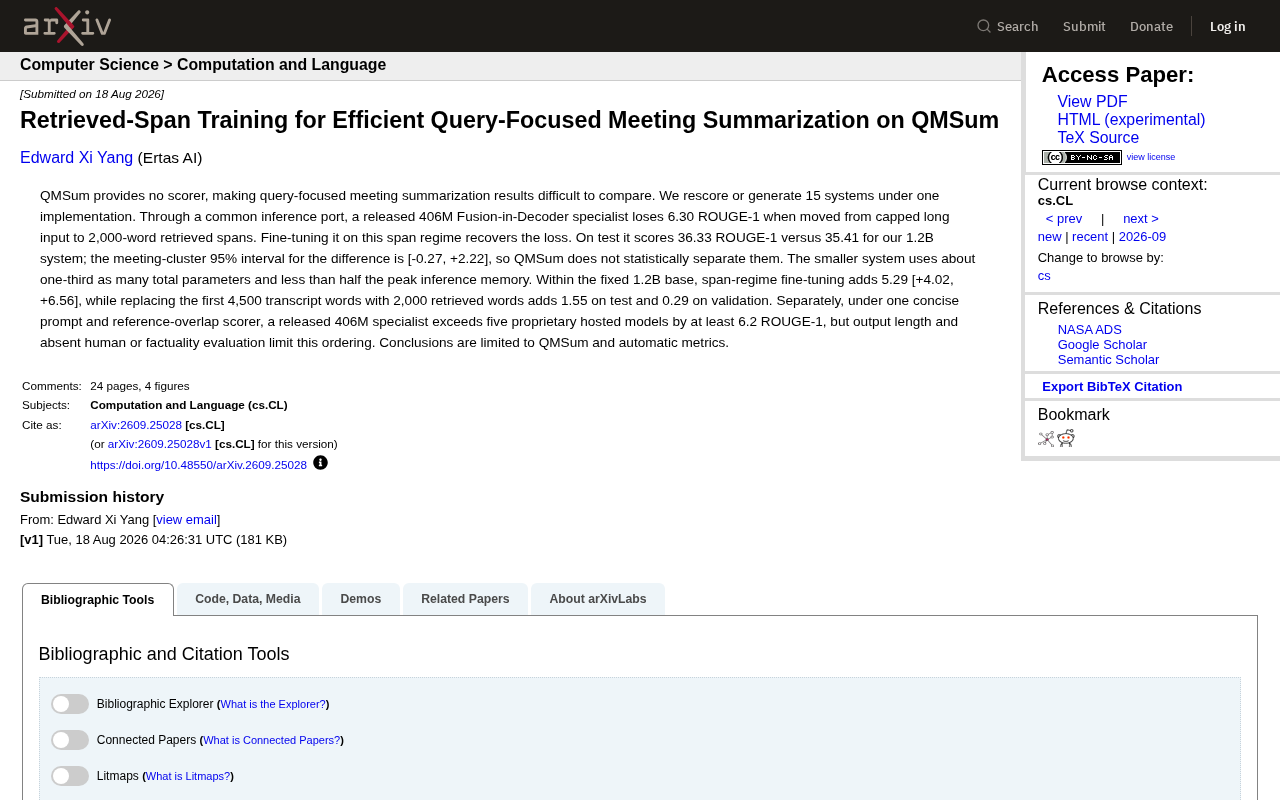
这篇论文以QMSum评测基准长期缺乏统一评分器为切入点,指出跨论文的分数对比普遍存在方法论缺陷。研究者在同一实现框架下重新评测了15个系统,发现输入格式差异可导致ROUGE-1单项浮动超过6分。核心贡献是"检索片段训练"(Retrieved-Span Training):将406M参数的FiD专用模型针对2000词检索片段格式进行微调后,其测试集ROUGE-1(36.33)与作者自建的1.2B系统(35.41)在统计意义上无法区分,而前者参数量仅为后者三分之一、峰值推理显存不到一半。消融实验进一步显示,片段范式微调贡献约5.29分增益,远超单纯替换输入的1.55分,说明让模型"学会消费检索结果"才是性能跃升的关键。论文同时对小模型领先商用大模型的结论保持克制,指出ROUGE的长度偏差与缺乏人工评估是重要局限。
一个被忽视的评测难题
查询聚焦的会议摘要(Query-Focused Meeting Summarization)一直是自然语言处理中的硬骨头。用户提出一个问题,系统需要从冗长的会议记录中定位相关内容,并生成针对性的摘要。QMSum 是这一任务的主流基准数据集,但它有一个长期存在的痛点:没有提供统一的评分器(scorer)。
这意味着不同研究团队报告的结果往往难以横向比较——大家用的评测实现、输入处理方式、推理配置各不相同,导致所谓的"最优系统"排名充满水分。这篇 arXiv 新论文正是从这个方法论问题切入,试图为该领域建立一个可靠的对比基线。
QMSum(Query-based Meeting Summarization)数据集由 Zhong 等人于 2021 年发布,包含来自学术会议、产品会议和议会辩论三类场景的约 230 段会议记录,每段均配有人工标注的查询-摘要对。与通用摘要不同,其核心挑战在于查询可以指向会议中的任意子话题,系统必须先完成"定位"再完成"生成",本质上是检索与生成的联合任务。ROUGE(Recall-Oriented Understudy for Gisting Evaluation)是评测中最常用的自动指标,通过计算候选摘要与参考摘要之间的 n-gram 重叠率来量化相似度,其中 ROUGE-1 衡量单字重叠,ROUGE-2 衡量双字重叠,ROUGE-L 则基于最长公共子序列。这类指标计算简单且可复现,但对评测流程中的文本预处理(分词、小写化、标点处理)高度敏感——即便是同一模型,不同的预处理实现也可能产生 1-2 分的差异,这正是"缺乏统一评分器"所带来的实际危害。
统一实现下的重新评测
研究者做了一件基础但极具价值的工作:在同一套实现框架下,对 15 个系统进行了重新评分或重新生成。通过一个共同的推理接口(common inference port),他们得以在完全一致的条件下观察各系统的真实表现。
结果揭示了一个关键现象:一个已发布的 406M 参数 Fusion-in-Decoder(FiD)专用模型,当输入从"截断的长文本"切换到"2000 词检索片段"时,ROUGE-1 分数骤降 6.30 分。这说明模型对输入格式高度敏感,之前的评测差异很可能有相当一部分来自这类实现细节,而非模型能力本身。
检索片段微调:小模型的翻身仗
论文的核心贡献在于检索片段训练(Retrieved-Span Training)。当研究者针对这种"2000 词检索片段"的输入格式对 406M 模型进行专门微调后,之前损失的 6.30 分被完全找回。
更有意思的是最终对比结果:
- 微调后的 406M 模型在测试集上取得 36.33 ROUGE-1
- 作者自建的 1.2B 系统仅为 35.41 ROUGE-1
考虑到会议聚类(meeting-cluster)的 95% 置信区间为 [-0.27, +2.22],这意味着在 QMSum 上,两个系统在统计意义上无法被区分。换句话说,那个只有约三分之一参数量、峰值推理显存不到一半的小模型,在实际效果上与三倍大的系统旗鼓相当。
这对追求部署效率的团队是个有力的信号:盲目堆参数未必换来可衡量的收益。
Fusion-in-Decoder(FiD)是由 Izacard 和 Grave 于 2021 年提出的开放域问答架构,其核心思路是:将多个检索到的文本片段分别与问题拼接后独立编码(Encoder 阶段),再将所有片段的编码表示拼接后送入统一的 Decoder 生成答案。这种设计让模型能够并行处理大量上下文,同时避免直接拼接所有片段导致编码器注意力被稀释的问题。在会议摘要场景中,FiD 被用来处理通常超过数万词的会议转录——模型先检索出与查询最相关的若干片段,再通过 FiD 架构融合这些片段生成摘要。406M 参数规模对应的是基于 T5-Large 的骨干网络,其参数量远小于当前主流的十亿级大语言模型,但专为结构化检索-生成流程设计的架构优势,使其在特定任务上具备超越参数量所预期的竞争力。
拆解性能来源:微调 vs 检索
为了厘清性能提升到底来自哪里,研究者在固定的 1.2B 基座上做了消融分析,结果颇具启发:
| 干预方式 | 测试集提升 | 验证集提升 |
|---|---|---|
| 片段范式微调 | +5.29 [+4.02, +6.56] | — |
| 用 2000 检索词替换前 4500 转录词 | +1.55 | +0.29 |
可以看到,片段范式微调贡献了绝大部分增益(约 5.29 分),而单纯替换输入(用检索片段代替原始转录开头)带来的提升相对有限。这个拆解很重要:它提示我们,检索本身固然有用,但让模型"学会"如何消费检索结果,才是效果跃升的关键。
一个需要谨慎解读的对比
论文还报告了一个抓人眼球的结果:在同一套简洁提示词(concise prompt)和参考重叠评分器下,已发布的 406M 专用模型在 ROUGE-1 上至少领先五个商用托管大模型 6.2 分。
不过作者本人对此保持了克制,明确指出了这一结论的局限:
- 输出长度差异可能影响 ROUGE 分数
- 缺乏人工评估与事实性(factuality)评估
- 排名仅基于自动指标
这种自我限定值得肯定。ROUGE 这类基于 n-gram 重叠的指标,本就难以完整衡量摘要质量,尤其在与生成风格迥异的商用模型对比时。领先 6.2 分不等于"更好",只能说明在这个特定评测协议下的表现差异。
ROUGE 指标对输出长度存在系统性偏差:生成较短摘要的模型往往在 Precision(精确率)上占优,而生成较长摘要的模型在 Recall(召回率)上更具优势,F1 值则在两者之间取得平衡。商用大语言模型(如 GPT-4、Claude 等)在无明确长度约束时倾向于生成更流畅、结构更完整但篇幅更长的摘要,而专用小模型经过微调后更贴近训练集中参考摘要的长度分布。这种系统性的长度差异,会使基于 n-gram 重叠的 ROUGE 分数产生难以消除的偏差,导致对两类模型的对比本质上并不对等。此外,ROUGE 不能衡量事实一致性(factual consistency)——模型可能生成与参考文本词汇高度重叠但包含幻觉(hallucination)的摘要,这在会议记录这类对准确性要求较高的场景中尤为值得警惕。
对实践者的启示
这项工作的价值不在于刷新了某个 SOTA,而在于它以严谨的方法论态度,回答了几个实际问题:
第一,评测一致性至关重要。 在缺乏统一评分器的基准上,任何跨论文的分数对比都应该打个问号。研究者通过统一实现框架重新评测 15 个系统,本身就是一份宝贵的社区贡献。
第二,专用小模型 + 针对性微调是高性价比路径。 406M 模型在合适训练下能匹敌 1.2B 系统,同时显著节省显存和推理成本,这对资源受限的部署场景意义重大。
第三,检索要与训练协同。 单纯接入检索模块收益有限,让模型适应检索片段的输入分布才能释放其潜力。
作者也诚实地划定了边界:所有结论仅限于 QMSum 数据集和自动评测指标。这种克制的表述,恰恰是这类实证研究应有的样子。
相关推荐

AI温和派的崛起:在狂热与末日论之间寻找中间地带
AI舆论正陷入加速主义与末日论的两极撕裂,但一群"AI温和派"正在崛起。本文梳理福山、"AI作为常规技术"作者及好莱坞制片人卡森伯格的最新观点,呈现在狂热与恐惧之间寻找中间地带的思潮。
我让Claude构建可漫步的物理精确O'Neill圆柱:AI生成3D模拟的边界
我让Claude构建可漫步的物理精确O'Neill圆柱:AI生成3D模拟的边界
一位开发者让Claude构建物理精确、可实时漫步的O'Neill圆柱太空栖息地模拟。本文解析其中的科里奥利力、重力梯度等物理挑战,以及AI生成交互式3D模拟的现实意义与局限。

破解数据锁定:用REGISTER与UNREGISTER API实现目录可移植性
湖仓架构下,开放表格式解决了存储可移植性,但目录锁定成为新难题。本文解析REGISTER与UNREGISTER API如何实现元数据松耦合,帮助企业避免厂商绑定、支持多目录协作并安全迁移数据。