结构自动机如何提升神经语义解析质量

结构自动机通过接受路径解码等三阶段机制系统性解决神经语义解析的结构约束问题,价值因资源与场景而异。
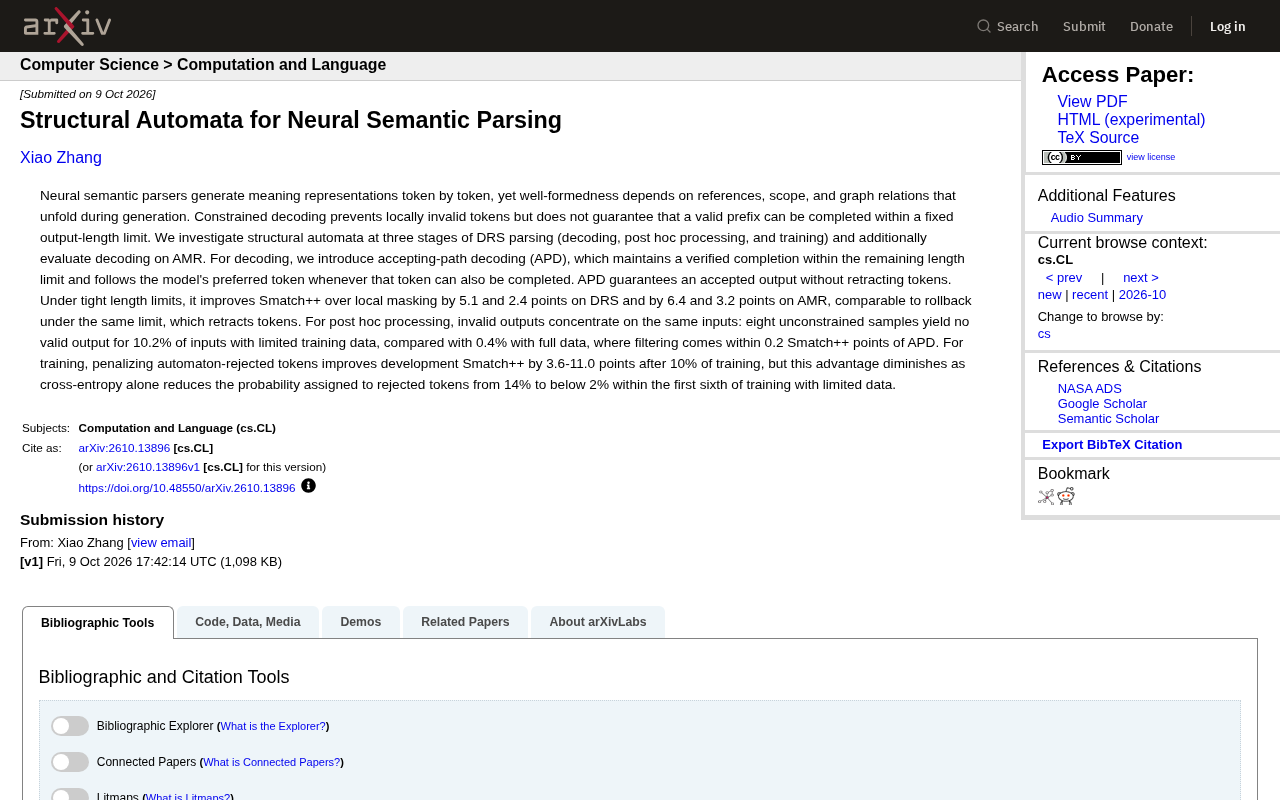
这篇研究针对神经语义解析中逐 token 生成无法保证全局结构合法性的问题,提出用结构自动机在解码、事后处理和训练三个阶段加以干预。核心贡献是接受路径解码(APD)——它在生成每一步都维护一条在剩余长度内可完成的接受路径,从而无需回退即可保证输出合法,在严格长度限制下相比局部屏蔽在 DRS 和 AMR 任务上分别提升最高 5.1 和 6.4 个 Smatch++ 分。事后过滤实验则揭示无效输出高度集中于少数输入,数据充足时简单过滤与 APD 差距仅 0.2 分。训练阶段引入结构惩罚虽可早期加速收敛,但收益随交叉熵学习推进而递减。三阶段发现共同指向一个实用结论:应按数据规模和部署约束选择结构正确性保障策略,而非一刀切地应用复杂机制。
神经语义解析的结构约束难题
神经语义解析器以逐 token 的方式生成意义表示(meaning representation),但一个输出是否“良构”(well-formed),往往取决于引用关系、作用域(scope)以及图结构关系——这些约束会在生成过程中逐步展开,而非在单个 token 层面就能判断。
传统的约束解码(constrained decoding)可以在每一步屏蔽掉局部非法的 token,但它存在一个根本缺陷:即便当前前缀合法,也无法保证这个前缀能在固定的输出长度限制内被补全为一个完整有效的结构。换句话说,模型可能一步步走进死胡同,最终生成一个无法完成的半成品。
这篇研究提出用**结构自动机(structural automata)**来系统性地解决这一问题,并在 DRS(Discourse Representation Structure)解析的三个阶段——解码、事后处理与训练——分别加以验证,同时在 AMR(Abstract Meaning Representation)任务上评估了解码效果。
DRS(Discourse Representation Structure)是一种源自话语表示理论(Discourse Representation Theory)的形式化意义表示,用于捕捉句子乃至篇章级别的语义,包括量化词作用域、指代关系和时态信息,其输出是一种嵌套的逻辑图结构。AMR(Abstract Meaning Representation)则是另一种广泛使用的图式语义表示,以有根有向无环图的形式编码"谁对谁做了什么",节点代表概念,边代表语义角色关系。两者的共同特点是:合法输出必须满足全局一致的图结构约束——例如变量必须先声明后引用、图中不能出现悬空节点——而这类约束在逐 token 生成时难以用纯局部规则捕捉,正是本文要解决的核心矛盾。
Smatch++(Smatch 的增强版)是评估这类图式语义解析结果的主要指标,通过计算预测图与参考图之间节点与边的最优对齐 F1 值来衡量解析质量,数值越高代表与标注越接近。
接受路径解码:保证输出可完成
研究的核心贡献是在解码阶段引入了接受路径解码(Accepting-Path Decoding, APD)。它的设计思路很直接:在剩余长度限制内始终维护一条已验证可完成的路径,并在模型偏好的 token 同样能够被补全时,优先遵循模型的选择。
这一机制带来的关键保证是——APD 能确保最终输出被自动机接受,且不需要回退(retract)任何已生成的 token。这与依赖“回滚”(rollback)的方法形成鲜明对比,后者在走进死路后必须撤销已有 token 重新生成。
从实验数据看,在严格的长度限制下,APD 相比局部屏蔽(local masking)在 Smatch++ 指标上:
- DRS 任务提升 5.1 和 2.4 分
- AMR 任务提升 6.4 和 3.2 分
更值得关注的是,APD 在相同长度限制下的表现与需要回退 token 的 rollback 方法相当,却避免了回退带来的额外开销与复杂性。这意味着在不牺牲质量的前提下,获得了更干净的生成保证。
结构自动机(structural automata)在此处指的是一类有限状态机或其扩展(如下推自动机),其状态转移规则编码了目标意义表示的合法结构约束。在解码过程中,自动机与语言模型并行运行:每生成一个 token,自动机同步进行状态转移,从而实时追踪当前前缀所处的结构状态。接受路径解码(APD)的关键创新在于,它不仅查询"当前 token 是否合法",还会预查询"从当前状态出发,在剩余步数内是否存在至少一条通向接受状态的路径"——只有满足这一前瞻条件的 token 才会被保留在候选集中。这种前瞻性检查正是它相比传统局部屏蔽的本质区别:后者只能排除当下非法的 token,无法防止模型走入结构上的"死胡同"。
事后处理:无效输出高度集中
研究还考察了无约束采样后进行事后过滤(post hoc processing)的策略,并得到一个有价值的观察:无效输出高度集中在相同的输入上。
具体而言,当从模型中无约束地采样八个候选时:
- 在训练数据有限的情况下,有 10.2% 的输入无法产生任何有效输出;
- 在使用全量训练数据时,这一比例骤降至 0.4%。
在数据充足的场景下,简单的过滤策略已经相当接近 APD——Smatch++ 差距仅在 0.2 分以内。这提示我们:当模型本身训练充分时,复杂的结构约束解码收益会被压缩;而在低资源场景下,APD 这类结构保证机制的价值才会充分凸显。
训练阶段:结构惩罚的收益会递减
第三个发现来自训练阶段。研究尝试在训练中惩罚被自动机拒绝的 token,结果显示:在完成 10% 的训练后,开发集 Smatch++ 可提升 3.6 至 11.0 分,效果显著。
但这一优势会随着训练推进而逐渐消失。原因在于,交叉熵损失本身就会压低被拒绝 token 的概率——在数据有限的情况下,这些 token 被赋予的概率在训练前六分之一的阶段内就从 14% 降到了 2% 以下。
这个结论颇具启发性:结构约束带来的训练信号,在很大程度上与标准交叉熵的学习目标是重叠的。模型在学习正确结构的同时,自然会学会避开非法 token。因此,训练阶段显式引入结构惩罚更像是一种“加速器”,能在早期带来提升,但并不提供交叉熵最终无法达到的能力。
三阶段结论的整体启示
把三个阶段的发现放在一起看,可以得到一个连贯的判断:结构自动机的价值高度依赖于资源与约束条件。
- 在解码阶段且长度限制紧张时,APD 提供了确定性的完成保证,收益最明显;
- 在事后处理中,无效输出的集中性意味着过滤在数据充足时足够有效;
- 在训练阶段,结构惩罚的收益会被交叉熵逐渐吸收。
对于构建语义解析系统的工程实践者而言,这意味着应当根据数据规模和部署约束来选择策略:低资源、严格长度限制的场景优先考虑 APD;数据充足时,轻量的事后过滤可能已经足够。这种把“结构正确性”作为可配置模块、而非一刀切约束的思路,为神经结构化生成提供了实用的工程指引。
相关推荐

农业革命另一面:疾病如何帮农民击败狩猎采集者
历史学者Kyle Harper解读农业社会如何击败狩猎采集者:不仅靠单位土地能量提取效率带来的人口增长优势,还依靠定居生活催生的病原体在扩张中造成额外死亡率,形成双重替代机制。

渐进式披露让Agent提速2.3倍:上下文工程新思路
Hacker News讨论提出用渐进式披露优化AI Agent上下文,实现2.3倍提速。本文解析上下文膨胀的三大性能损耗,介绍分层工具目录、按需检索、历史压缩等实践路径及落地注意事项。
Perplexity Computer 登陆 Mac:本地运行模型与智能体
Perplexity Computer 登陆 Mac:本地运行模型与智能体
Perplexity Computer 现可在 Mac 上完全本地运行,模型与智能体均在设备端执行,支持原生 Mac 应用和本地文件,敏感数据无需上传云端,已在 Perplexity Mac 应用上线。