仅哈希发送器能否超越经典压缩?预注册实验揭示边界
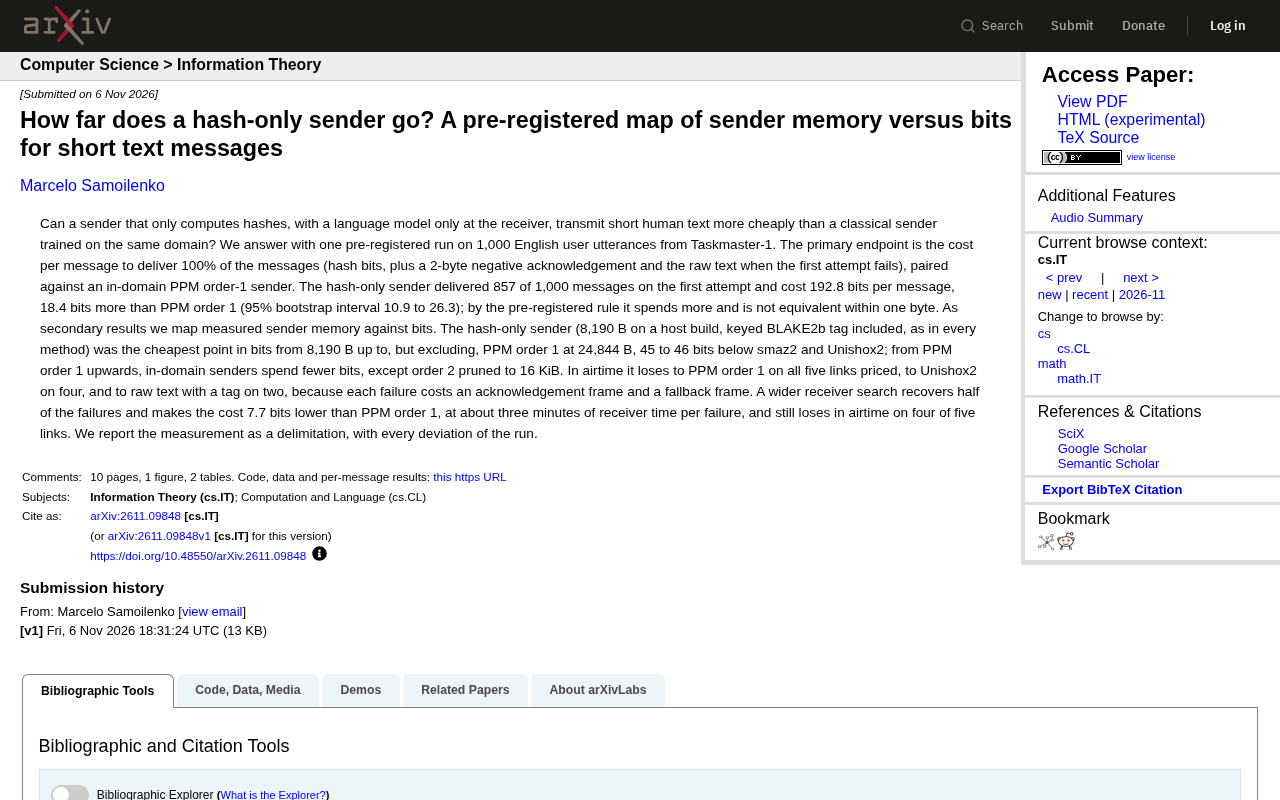
预注册研究显示仅哈希发送器在短文本传输中比特成本高于PPM一阶18.4比特,未通过等价性检验。
一项预注册研究使用Taskmaster-1的1000条英语话语,严格对比仅哈希发送器与领域内PPM一阶压缩器的传输成本。主要终点要求100%送达,成本含哈希比特、NACK与失败回退。结果显示哈希发送器首次成功857条,平均192.8比特,比PPM高18.4比特,未通过一个字节的等价性检验。次要结果发现哈希方案仅在8,190至24,844字节内存区间内比特最低,比smaz2和Unishox2低45至46比特;空中时间则全面落后,因失败重传需额外确认与回退帧。更宽接收端搜索可恢复一半失败并将成本降至比PPM低7.7比特,但每次失败约需三分钟接收端时间。
实验背景:哈希发送器的成本之问
在通信系统中,发送端通常需要复杂的编码或压缩模型来降低传输成本。一个自然的问题是:如果发送端只计算哈希,而接收端使用大型语言模型进行解码,能否以更低的比特数传输短文本?近期一项预注册研究(pre-registered study)对此进行了严格测试,使用 Taskmaster-1 数据集的 1,000 条英语用户话语,对比了仅哈希发送器与领域内 PPM 压缩器的表现。
研究的主要终点是“每条消息的传输成本”,要求 100% 消息送达,成本包括哈希比特、2 字节否定确认(NACK)以及首次尝试失败时的原始文本回退。对照组为领域内 PPM 一阶模型。这种设计将“发送端记忆”与“比特数”的权衡置于可测量的框架下。
PPM(Prediction by Partial Matching) 是一种经典的无损压缩算法,核心思想是基于上下文的历史出现频率预测下一个符号,并对预测偏差进行编码。所谓“一阶”PPM(order-1)意指仅使用前一个符号作为上下文,模型复杂度低、发送端内存占用小,因而常被用作领域内压缩的基线。PPM 在文本压缩中表现稳健,尤其适合短文本场景:它无需大规模预训练,仅凭少量统计即可逼近该领域的经验熵。在本研究中,PPM 一阶模型代表的正是“发送端持有领域知识”这一对照条件,其 24,844 字节的内存占用也成为哈希发送器与经典压缩器成本分界的参照点。
主要结果:哈希发送器并未胜出
在预注册规则下,仅哈希发送器在首次尝试中成功送达了 857/1000 条消息,平均每条消息成本为 192.8 比特。相比之下,PPM 一阶模型成本低 18.4 比特(95% bootstrap 区间 10.9 至 26.3 比特)。按照预注册的等价性规则(一个字节以内),哈希发送器花费更多,且不等价于 PPM。
这一结果直接回答了标题中的问题:在短文本消息场景下,仅哈希发送器并未比经典领域内发送器更便宜。失败重传机制带来的额外开销抵消了哈希表示的潜在优势。
预注册研究(pre-registered study) 指在研究开始前公开登记假设、主要终点、样本量和分析方案,之后严格按登记方案执行并报告所有结果。其目的在于防止事后挑选有利结果(如 p-hacking 或 HARKing),从而提升结论的可信度。本研究将“每条消息的传输成本”设为主要终点,并事先规定等价性边界为一个字节(8 比特)以内;这意味着即便哈希发送器仅略贵于 PPM,也会被判定为不等价。预注册规则同时约束了失败重传的处理方式,使不同方案之间的比较在统一口径下进行,避免了事后调整指标带来的偏倚。
发送端记忆与比特的映射
作为次要结果,研究绘制了发送端内存占用与传输比特的关系图。仅哈希发送器(主机构建下 8,190 字节,包含带密钥的 BLAKE2b 标签)在 8,190 字节至 24,844 字节(不含)区间内是比特成本最低的点,比 smaz2 和 Unishox2 低 45 至 46 比特。然而,从 PPM 一阶模型(24,844 字节)往上,领域内发送器花费的比特更少,例外是剪枝到 16 KiB 的二阶模型。
这意味着哈希发送器的优势仅限于特定的内存区间,并非普遍适用。对于内存极度受限的场景,哈希方案可能有一定吸引力,但一旦允许更大的发送端模型,经典压缩方法反而更高效。
BLAKE2b 是一种密码学哈希函数,属于 BLAKE2 家族,输出长度可配置(最高 64 字节),以高速度和强抗碰撞性著称,常用于完整性校验与消息认证。文中“带密钥的 BLAKE2b 标签”即 HMAC 式构造:发送端用共享密钥对消息计算带密钥哈希,接收端据此在候选集合中检索匹配项。哈希发送器的内存开销(8,190 字节)主要来自该标签的存储或候选表结构,而非原始文本本身。这也解释了为何其内存占用虽小却并非零:带密钥标签在提供安全性(防止伪造匹配)的同时,构成了发送端记忆的下限。
空中时间与接收端搜索
比特成本并非唯一指标。在空中时间(airtime)方面,仅哈希发送器在五个定价链路中全部输给 PPM 一阶模型,在四个链路上输给 Unishox2,在两个链路上输给带标签的原始文本。原因在于每次失败都需要一个确认帧和一个回退帧,实际传输时间被显著拉长。
研究还尝试了更宽的接收端搜索:这能恢复一半的失败,使成本比 PPM 一阶低 7.7 比特,但每次失败约需三分钟的接收端时间,且在五个链路中仍有四个在空中时间上落后。这一权衡表明,接收端计算资源的增加可以部分弥补比特成本,但无法解决空中时间的根本劣势。
空中时间(airtime) 指数据在物理链路上实际占用信道的时间,取决于比特数、链路速率、帧开销与重传次数,是衡量无线或低功耗通信能耗与延迟的关键指标。与单纯的比特成本不同,空中时间把确认帧(ACK/NACK)、回退帧和协议头开销都计入其中。仅哈希发送器虽然平均比特数不占优,但其失败重传需要额外的否定确认与原始文本回退,每一轮失败都拉长了信道占用,因此在五个定价链路上全面落后。这一指标提醒我们:压缩方案的优劣不能只看净荷比特,还需考虑失败处理带来的协议层放大效应。
结论与启示
该研究以预注册的方式给出了明确的边界:仅哈希发送器在短文本消息传输中并未超越领域内经典压缩器。其价值在于提供了可复现的测量框架,并揭示了发送端内存、比特成本与空中时间之间的复杂权衡。对于实际系统设计,若目标是降低比特数,经典压缩器在多数内存配置下更优;若发送端计算能力极度受限,哈希方案可作为特定区间的备选,但需接受更高的失败重传开销。
研究同时报告了所有运行偏差,增强了结果的可信度。未来工作可探索更高效的接收端搜索策略,或结合哈希与轻量级压缩的混合方案。
相关推荐
Claude Code额度不够用?实测哪些技巧真省额度
实测 Claude Code 20美元套餐:换用 Sonnet 或 Haiku、降低 effort 能让同样任务额度减半以上,而 /clear、/compact、plan mode 等流传技巧在短会话中几乎不省额度甚至更贵。
Anthropic新研究:AI记忆如何避免「记错」?
Anthropic最新报告探讨AI智能体跨会话记忆的可靠性:数据库任务中记忆提升基准分数,但游戏实验显示记忆可能固化错误。报告建议保留证据、测试规则、纠正过时笔记,为助手构建者提供实践指南。
AI智能体记忆全解析:四层结构与“做梦”机制
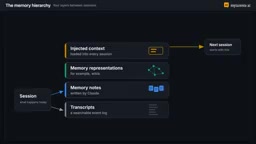
解读Anthropic智能体记忆研究:记忆的四层架构、以CLBench和宝可梦实验检验“该记什么”,以及通过“做梦”修正笔记、构建wiki、提升上下文注入质量的机制与局限。