进化策略的质心解读:一种更直观的几何视角
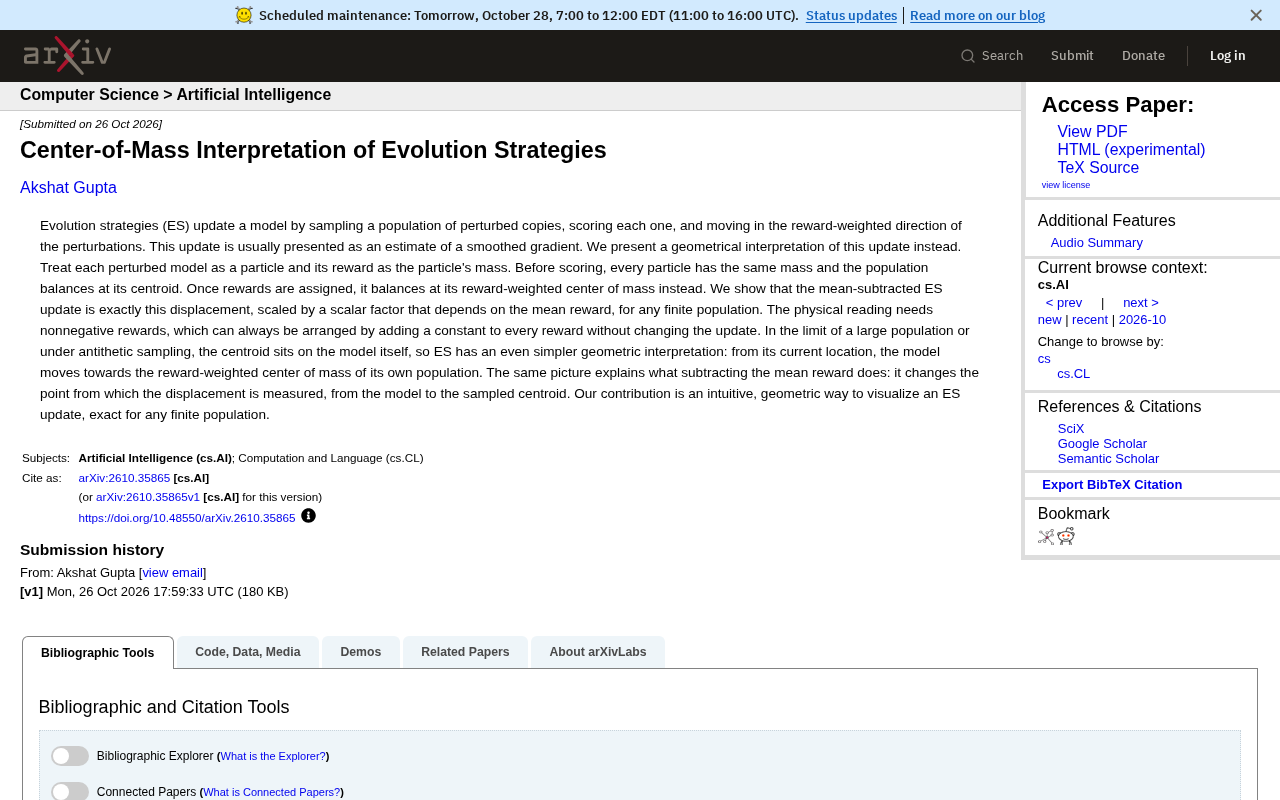
研究用质心位移精确解释进化策略更新,揭示均值减除的几何意义。
这篇来自 RSS 的研究为进化策略(ES)提出了一种直观的几何解释:将每个扰动模型视为粒子,奖励视为粒子的质量,ES 更新就等价于奖励加权质心的位移乘以一个标量因子。该结论对任意有限种群精确成立,不依赖大种群近似。文章进一步阐明,奖励非负性可通过加常数满足且不影响更新;均值减除等价于将位移测量起点从模型位置切换到采样质心;在大种群或反对称采样下,质心位于模型自身,几何解释更简洁。这种视角为 ES 提供了物理直觉,有助于教学、调试和变体分析。
进化策略(Evolution Strategies, ES)通常被理解为一种平滑梯度的估计方法:采样一组扰动后的模型副本,分别评分,然后沿奖励加权方向更新参数。但一篇来自 RSS 的研究提出了一个更直观的几何解释——把每个扰动模型看作粒子,奖励看作粒子的质量,整个更新过程就变成了一个质心位移问题。这种视角不仅让 ES 的更新机制变得可视化,还解释了均值减除(mean subtraction)的几何含义。
从梯度估计到质心位移:换一个角度看ES
传统上,ES 的更新规则被解释为对平滑梯度的蒙特卡洛估计。但这项研究指出,如果抛开梯度视角,把每个扰动模型视为一个粒子,并赋予其与奖励成正比的“质量”,那么整个种群在评分前是均匀的,质心位于种群中心;评分后,每个粒子的质量发生变化,种群的平衡点就转移到了奖励加权的质心位置。
研究证明:对于任意有限种群,均值减除后的 ES 更新恰好等于这个质心位移乘以一个取决于平均奖励的标量因子。也就是说,ES 的更新方向本质上就是种群质心的移动方向,更新幅度则与质心位移的大小成比例。这一结论不依赖于种群规模的大小,对有限种群同样精确成立。
这种几何解读的巧妙之处在于,它把抽象的梯度估计问题转化为了一个物理系统:粒子在空间中的质量分布变化导致质心移动,而模型参数正是沿着质心移动的方向更新。对于习惯物理直觉的研究者来说,这比梯度公式更容易形成心理图像。
进化策略(ES) 是一类基于种群的無梯度优化算法,其核心思想是通过采样扰动、评估适应度、加权更新参数来迭代改进模型。经典 ES(如 CMA-ES)维护一个搜索分布(通常是高斯分布),并根据适应度调整分布的均值与协方差。本文讨论的 ES 变体与 OpenAI ES 一脉相承:它不显式维护分布参数,而是对当前模型参数施加高斯扰动得到一群子代,用奖励作为权重计算加权平均方向,再沿该方向更新。这种形式在强化学习与黑盒优化中流行,因为它易于并行、不依赖反向传播,且对奖励尺度有一定鲁棒性。理解其更新规则的几何含义,有助于设计更稳定的采样策略与方差缩减技术。
奖励非负性与均值减除的几何意义
质心解释有一个前提条件:奖励必须是非负的,因为质量不能为负。研究指出,这并不构成限制——只要给所有奖励加上一个常数,更新结果完全不变。这个性质在 ES 中本就成立,但从质心视角看,它意味着我们可以自由调整粒子的“基准质量”,而不影响质心的相对位移。
更有启发性的是均值减除操作。在标准 ES 中,通常会从奖励中减去平均奖励,以降低方差。从质心角度看,减去均值实际上改变了位移的测量起点:原本位移是从模型当前位置测量到种群质心,减去均值后,测量起点变成了采样质心本身。换句话说,均值减除把参考系从“模型位置”切换到了“种群中心”,而质心位移的方向和相对大小保持不变。
这一解释让均值减除这一常见技巧有了清晰的几何对应,不再只是一个方差缩减的经验操作。
均值减除(mean subtraction) 是 ES 中一种标准的方差缩减技巧:在计算加权更新前,从每个奖励中减去当前种群的平均奖励。其统计动机是降低梯度估计的方差,因为减去均值相当于对奖励做中心化,使权重之和为零,从而消除公共漂移分量。从质心视角看,减去均值等价于将位移的参考点从“模型当前位置”平移到“采样种群的质心”,而质心位移的方向和相对大小保持不变。这解释了为什么均值减除不改变更新方向,只改变更新幅度——它调整的是参考系,而非物理位移本身。这一几何对应让均值减除从经验操作上升为有明确图像的解释。
大种群与反对称采样下的简化
当种群规模趋于无穷大,或者采用反对称采样(antithetic sampling)时,种群的质心恰好落在模型自身的位置上。此时 ES 的几何解释变得更加简洁:模型从当前位置出发,直接朝着自己种群奖励加权质心的方向移动。
反对称采样是一种常见的方差缩减技术,它通过成对采样正负扰动来保证种群中心与模型重合。从质心视角看,这种采样方式恰好消除了质心偏移,使得更新方向完全由奖励加权决定,几何图像更加干净。
这也解释了为什么反对称采样在实践中往往表现更稳定:它让种群的“平衡点”始终锚定在模型上,避免了因采样误差导致的质心漂移,从而让更新方向更纯粹地反映奖励信号。
反对称采样(antithetic sampling) 是一种常见的方差缩减技术,在 ES 中表现为成对生成正负扰动:若采样一个扰动 ε,则同时采样 -ε,并分别评估。这样一对扰动的均值为零,因此整个种群的质心恰好与当前模型参数重合。从质心视角看,反对称采样消除了因有限采样导致的质心偏移,使更新方向完全由奖励加权决定,几何图像更干净。这也解释了其稳定性优势:质心始终锚定在模型上,避免了采样误差引起的漂移。值得注意的是,反对称采样要求扰动分布关于原点对称(如高斯分布),否则成对扰动的均值不为零,质心锚定性质将不再成立。
为什么这个视角值得关注
ES 作为一种无梯度优化方法,在强化学习、黑盒优化和近年的大模型训练中都有应用。但它的更新规则往往以公式形式呈现,缺乏直观解释。质心解读的价值在于提供了一种可视化的思考工具:你可以想象一群粒子在参数空间中分布,奖励高的粒子“更重”,把种群的平衡点拉向自己,而模型则朝着这个新的平衡点移动。
这种几何直觉对于教学和调试都有实际意义。例如,当 ES 更新出现异常时,可以从质心偏移的角度分析:是采样分布不对称导致质心偏离模型?还是奖励尺度变化导致质心位移过大?这些问题在梯度视角下不那么容易定位,但在质心图像下变得直观。
研究强调,这一解释对任意有限种群都是精确的,而非仅在大种群极限下近似成立。这意味着它不仅可以作为教学工具,也可以作为分析有限种群 ES 行为的严格框架。对于希望深入理解 ES 内部机制的研究者和工程师来说,这是一个值得关注的视角转换。
论文的核心贡献不在于提出新的算法,而在于用一个精确的几何等价关系,把 ES 更新从“梯度估计”的框架中解放出来,赋予其物理直觉。这种解读方式可能会启发更多关于 ES 变体的几何分析,例如不同采样策略如何影响质心位置,或者奖励变换如何改变质心位移的尺度。
相关推荐
CodeMode:让AI代理写代码代替调用工具,token成本直降90%
探索CodeMode如何让AI代理通过编写代码在沙箱中执行,替代传统逐个调用工具的方式,从而减少token消耗高达90%,并分析其实现要点与适用场景。
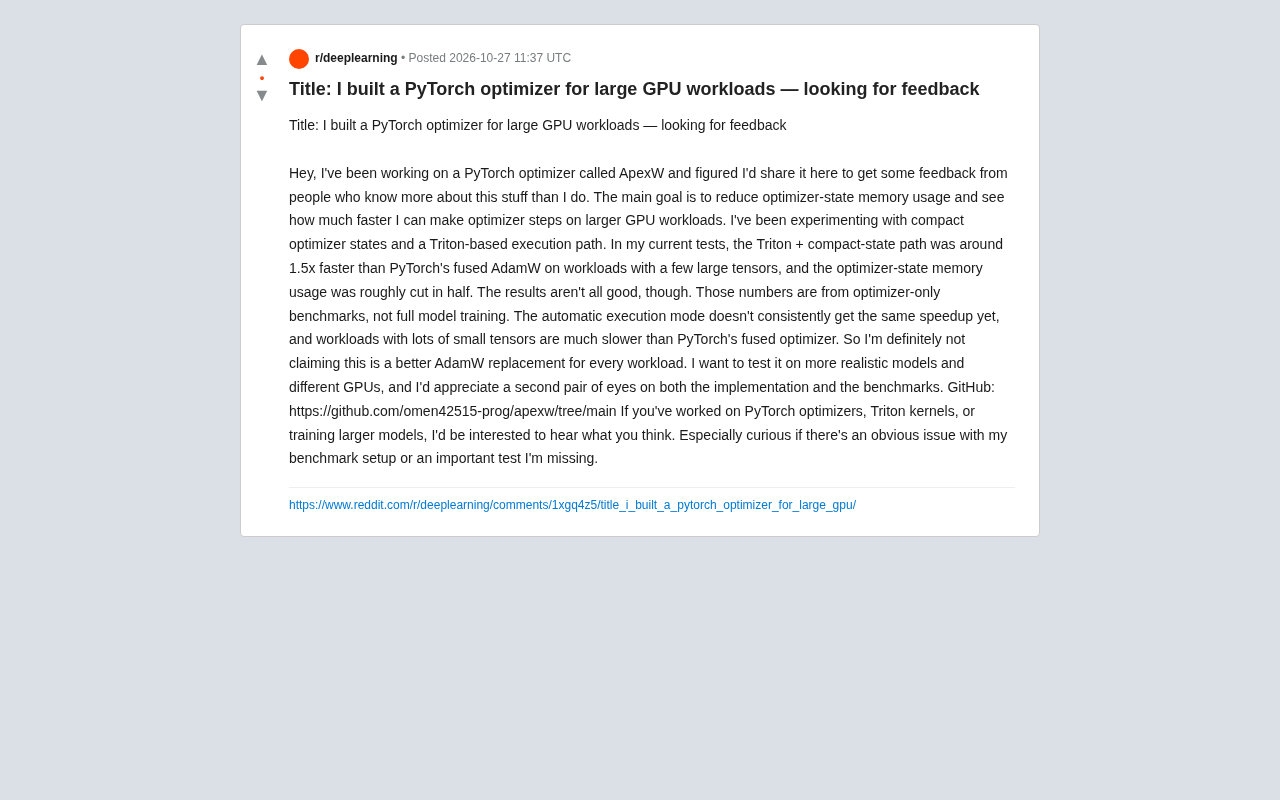
开发者自研PyTorch优化器ApexW:显存减半、提速1.5倍
开发者发布PyTorch优化器ApexW,采用紧凑优化器状态与Triton执行路径,在仅优化器基准中比fused AdamW快约1.5倍、状态显存约减半,但小张量与自动模式仍有明显短板,作者公开征集基准与实现反馈。
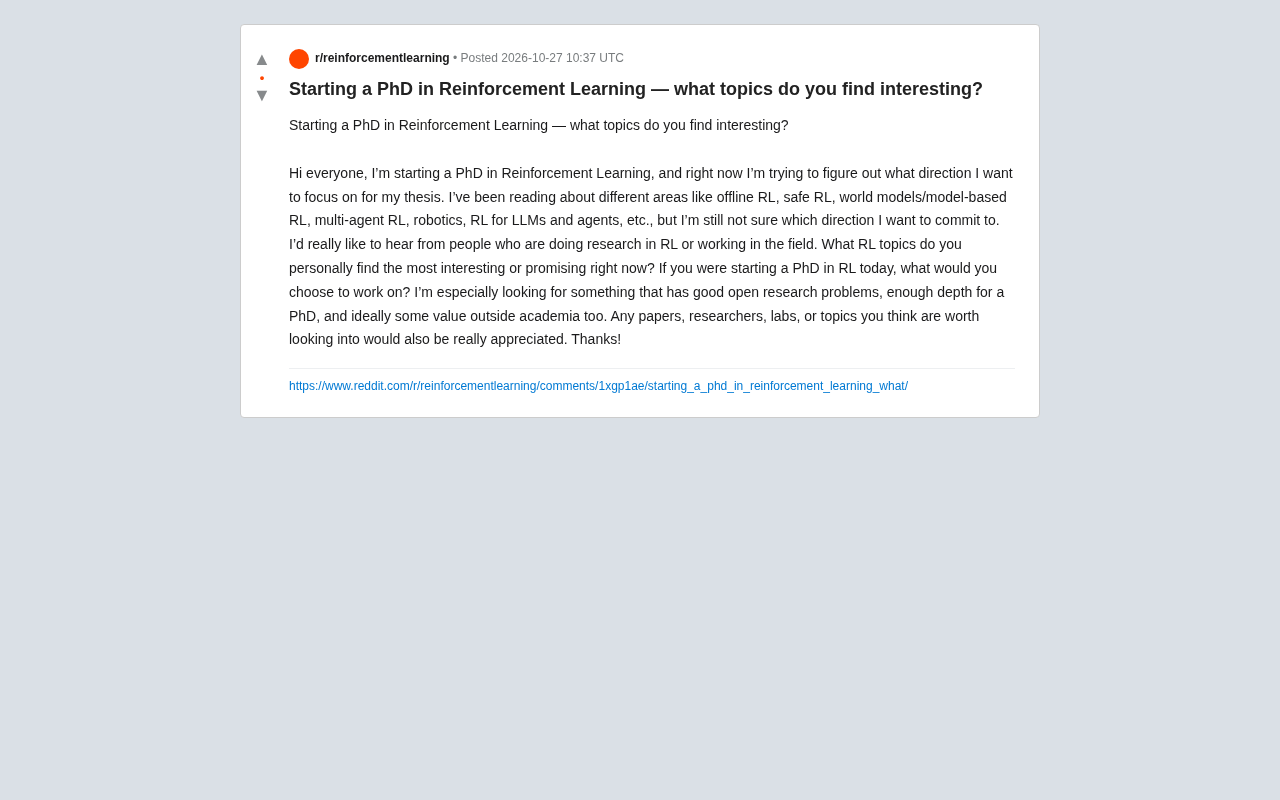
RL博士研究方向怎么选?六大前沿领域深度解析
RL博士研究方向怎么选?本文深度解析RL for LLMs、离线RL、安全RL、世界模型、多智能体RL和机器人RL六大前沿方向的开放问题、优势与风险,并提供兴趣匹配、产业价值平衡、导师匹配和技能可迁移性四个选择框架,帮助博士生做出明智决策。