进阶LLM应用工程实战:混合RAG、工具、记忆与评估

Packt工作坊聚焦LLM应用从演示到生产的工程化,整合混合RAG、工具、记忆与评估。
文章介绍了Packt Publishing将于11月28日举办的进阶LLM应用工程工作坊,由Brij Kishore Pandey主讲。核心观点是:LLM应用在演示中跑通与在生产中可靠运行是两回事,需要系统工程方法。工作坊不再将检索、工具、记忆和评估视为孤立功能,而是整合为完整工程体系。内容涵盖混合RAG流水线(超越单一向量搜索)、工具调用与跨交互持久记忆、防护栏与失败处理、评估与可观测性,以及Google ADK和Gemini的平台实践。文章指出,LLM应用工程正从功能堆叠走向系统工程,适合已能用LangChain/LangGraph跑通demo但面临生产可靠性挑战的开发者。
从演示到生产:LLM应用工程化的关键一跃
很多开发者都有类似的体验:用LangChain或LangGraph搭一个LLM应用演示,几小时就能跑通;但要让它稳定运行在生产环境,却可能耗费数周甚至数月。 Packt Publishing 将于11月28日举办一场动手实践工作坊,由 Brij Kishore Pandey 主讲,主题直指这一痛点——进阶LLM应用工程。
据Reddit原帖介绍,这场工作坊面向正在使用LangChain和LangGraph构建应用的开发者,核心观点很明确:让LLM应用在演示中跑通,与让它生产可靠,是完全不同的两件事。
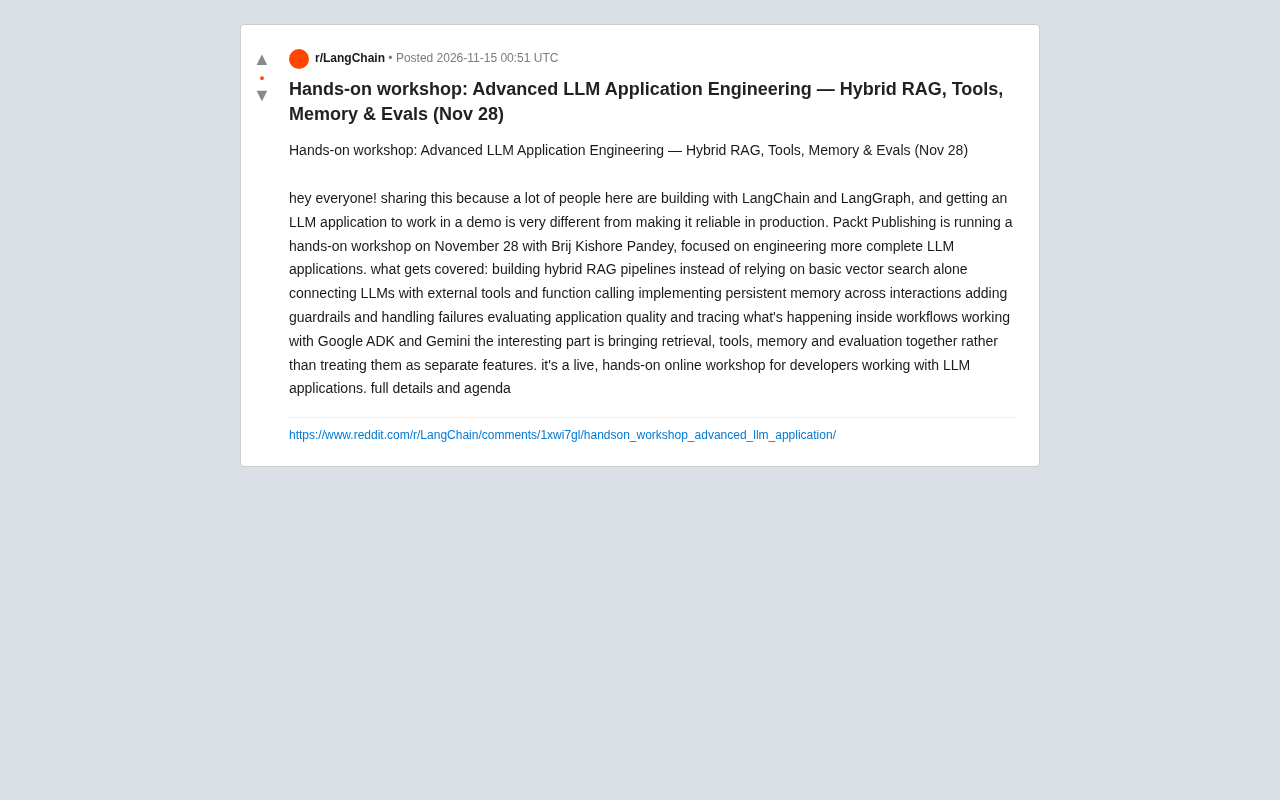
工作坊的独特之处在于,它不再把检索、工具、记忆和评估当作孤立的功能点,而是尝试将它们整合成一个完整的工程体系。原帖作者特别强调,这种整合视角是本次工作坊"有趣的部分"。
混合RAG:超越基础向量搜索
工作坊的第一个重点是构建混合RAG流水线,而不是单纯依赖基础的向量搜索。
纯向量检索在处理精确匹配、专有名词或结构化查询时常常力不从心,混合RAG通过融合多种检索策略来弥补这一短板。虽然原帖没有展开具体的技术组合,但这一方向本身释放了明确信号:生产级RAG需要多路召回与融合排序,而非单一语义相似度。
对于已经熟悉基础RAG的开发者,这部分内容将帮助理解如何设计更鲁棒的检索层,以应对真实业务场景中的复杂查询。
混合检索(Hybrid Retrieval) 通常指将稀疏检索(如BM25、TF-IDF等基于词频的算法)与稠密检索(如基于嵌入向量的语义相似度)结合。稀疏检索擅长精确匹配关键词、专有名词和数字,稠密检索擅长捕捉语义近义与上下文。融合方式常见的有加权求和、倒数排名融合(RRF)或学习型重排序(如Cross-Encoder)。在生产RAG中,混合检索能显著提升召回率,尤其面对短查询、领域术语或结构化字段过滤时。此外,多路召回后往往需要重排序阶段来统一排序,确保最终送入LLM的上下文既相关又精炼。
工具调用与持久记忆:让LLM应用"有手有脑"
第二个核心模块是连接LLM与外部工具及函数调用。LLM本身无法直接操作数据库、调用API或执行计算,函数调用机制让模型能够触发外部能力,从而扩展应用边界。
与此紧密相关的是跨交互的持久记忆实现。多数演示级应用在单次会话结束后就丢失上下文,而生产应用需要记住用户偏好、历史操作和中间状态。工作坊将覆盖如何在多次交互之间保持记忆,这直接关系到用户体验的连续性和个性化能力。
这两个模块共同解决了LLM应用"能做什么"和"记得什么"的问题,是从玩具走向工具的必要条件。
函数调用(Function Calling) 是LLM的一种结构化输出能力:开发者以JSON Schema描述可用工具(函数名、参数、说明),模型在需要时输出符合Schema的调用请求,由外部运行时执行并将结果回传给模型继续推理。它不同于让模型直接生成代码,而是通过受控接口扩展能力,降低幻觉风险。持久记忆则通常借助外部存储(如向量数据库、键值存储或关系型数据库)保存对话历史、用户画像与任务状态,并在后续交互中按需检索注入提示词。记忆可分为短期(会话内)与长期(跨会话),设计时需考虑写入策略、检索相关性及隐私合规。
防护栏、失败处理与可观测性
工作坊的第三个板块聚焦于添加防护栏和处理失败。LLM应用的不确定性远高于传统软件,模型可能输出有害内容、调用错误工具或陷入循环。防护栏机制用于约束输出边界,失败处理则确保系统在异常时优雅降级而非崩溃。
与之配套的是评估应用质量和追踪工作流内部状态。原帖提到要"评估应用质量并追踪工作流中发生的事情",这指向了LLM应用的可观测性建设——只有能看清内部每一步的输入输出,才能定位问题、持续优化。评估不仅是上线前的检查,更是迭代过程中的指南针。
防护栏(Guardrails) 是一组输入输出约束机制,包括内容过滤(毒性、偏见、敏感信息)、格式校验(JSON Schema、正则)、工具调用白名单与权限控制、以及话题边界限制。可观测性(Observability) 在LLM应用中通常通过追踪(Tracing)实现:记录每次请求的提示词、模型输出、工具调用参数与结果、延迟和token消耗,形成可回溯的调用链。常用工具包括LangSmith、LangFuse、OpenTelemetry等。评估(Evals)则分为离线批量评估与在线持续评估,指标涵盖准确性、相关性、忠实度、有害性等,常借助LLM-as-a-Judge或人工标注。
Google ADK与Gemini:平台实践
工作坊还将涉及Google ADK和Gemini的使用。ADK(Agent Development Kit)为构建智能体应用提供了框架支持,结合Gemini模型的能力,参与者可以了解如何在具体平台上落地上述工程模式。
这部分内容对于正在选型技术栈的团队尤其有价值——它提供了一个可参照的工程实现范例,而非纯理论讨论。
Google ADK(Agent Development Kit) 是Google推出的开源框架,用于构建、部署和管理基于Gemini等模型的智能体应用。它提供多智能体编排、工具集成、会话管理与评估钩子等能力,并与Vertex AI生态衔接。Gemini是Google的多模态大模型系列,支持文本、图像、音频等输入,并通过函数调用、结构化输出等接口与ADK配合。相比LangChain/LangGraph,ADK更贴近Google Cloud的部署与运维体系,适合已在GCP上的团队。了解不同框架的抽象层次与绑定关系,有助于在选型时权衡灵活性、可移植性与运维成本。
谁适合参加
根据原帖信息,这是一场线上实时动手工作坊,面向正在开发LLM应用的开发者。如果你已经能用LangChain或LangGraph跑通demo,但正为生产环境的可靠性、可维护性和可评估性发愁,这场工作坊的整合视角值得关注。
工作坊的议程和完整细节可通过原帖提供的链接查看。对于无法实时参加的开发者,也可以关注Packt Publishing后续是否提供录播或相关材料。
核心信号:LLM应用工程正在从"功能堆叠"阶段走向"系统工程"阶段,检索、工具、记忆、评估和可观测性需要被当作一个整体来设计,而非各自为战。
相关推荐

Gemini 4 Neon 曝光:或成 Opus 5.5 有力竞争者
Hacker News 讨论帖指出 Gemini 4 Neon 看起来像 Opus 5.5 的竞争者。本文解读这一社区信号背后的产品定位、顶级模型竞争格局变化,以及对开发者模型选型策略的实际意义。

Claude Fable 5.2 独立创作短片《Fable》引热议
Hacker News 上出现由 Claude Fable 5.2 独立完成剧本、画面与导演的短片《Fable》,本文分析全流程 AI 创作的意义、社区反应及对内容创作者的启示。

Anthropic IPO定价:AI巨头上市信号
Anthropic 进行 IPO 定价的消息引发关注。本文分析这一动作对 AI 行业估值、商业化路径和竞争格局的潜在影响,并指出公开市场对 AI 公司的期待与挑战。