金丝雀发布:生产环境零停机升级AI模型的实战方法

金丝雀发布通过分阶段流量爬升、指标门控与自动回滚,将大模型升级从高风险硬切换变为可控的渐进过程。
本文系统介绍了在生产环境升级AI模型的核心挑战与解决方案。硬切换的根本风险在于全量暴露与高成本回滚:一旦新模型出现问题,旧部署冷启动需要拉取权重、加载显存、预热推理引擎,在压力最大的时刻反而执行最耗时的操作。金丝雀发布以三个机制应对这一困境:分阶段流量爬升将影响面严格控制在小比例用户;指标门控将人工判断转化为自动化放行规则;自动回滚则利用旧部署始终在线的特性,将回滚从冷启动操作降级为近乎瞬时的流量切换。专用推理场景因GPU资源固定、冷启动代价极高,尤为需要这种范式。文章还建议将输出质量监控纳入门控体系,因为模型退化往往比系统崩溃更隐蔽。
在生产环境升级AI模型从来不是一件轻松的事。直接做一次硬切换(hard swap),意味着所有用户会在同一时刻暴露给新模型——一旦新模型存在性能退化、延迟飙升或输出质量下降的问题,影响面将是全量的。而回滚同样棘手:你需要在压力之下冷启动旧版本部署,这段时间里服务质量难以保证。
金丝雀发布(Canary Rollout)正是为了解决这一困境而生。它通过分阶段的流量爬升、指标门控以及自动回滚机制,让模型升级变成一个可控、可观测、可逆的渐进过程。
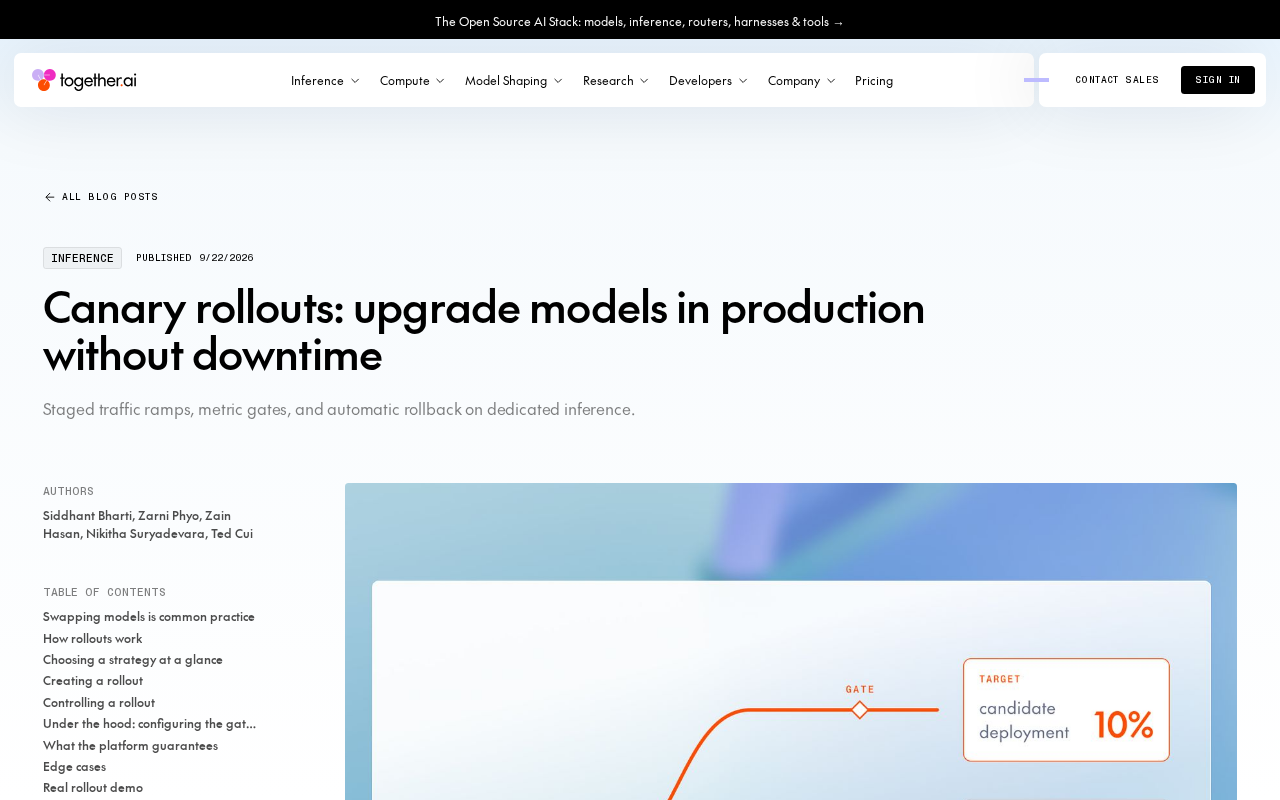
硬切换的代价
理解金丝雀发布的价值,先要看清硬切换的问题所在。
当你把流量一次性从旧模型切到新模型时,相当于把全部赌注压在一次上线上。新模型在离线评测中表现再好,也无法完全模拟真实生产流量的分布——边缘案例、长尾请求、并发压力都可能触发未曾预料的问题。
更严重的是回滚环节。如果旧部署已经被缩容或下线,回滚时需要重新冷启动——拉取模型权重、加载到显存、预热推理引擎。对于大模型而言,这个过程可能耗费数分钟,而这几分钟正是用户体验最糟糕的时刻。你是在故障已经发生、压力最大的时候去做一件本就耗时的操作。
金丝雀发布的三大核心机制
金丝雀发布在专用推理(dedicated inference)场景下,主要依赖三个相互配合的机制来降低升级风险。
分阶段流量爬升
与其一次性切换,不如让新模型从极小比例的流量开始承接。典型的做法是先引入 1%~5% 的流量,观察一段时间后逐步提升到 10%、25%、50%,最终达到 100%。
这种渐进式爬升的意义在于:即使新模型存在问题,受影响的也只是一小部分用户,问题的暴露范围被严格控制在可接受的边界内。同时,小比例流量也足以让你在真实环境中验证新模型的实际表现,而不是依赖离线评测的间接推断。
指标门控
光有流量爬升还不够,你需要在每一个爬升阶段设置明确的指标门(metric gates)。只有当新模型在关键指标上达标,流量才允许继续提升。
常见的门控指标包括:推理延迟(P50/P99)、错误率、吞吐量,以及更贴近业务的输出质量指标。指标门把人工判断转化为自动化的放行规则——新模型必须用数据证明自己足够好,才能承接更多流量。这避免了凭感觉上线的主观性,也让整个发布过程变得可审计。
输出质量指标的门控在实践中往往是最难实现、也最容易被忽略的一环。延迟和错误率可以通过基础监控系统直接采集,但模型输出质量的退化可能以更隐蔽的方式呈现:回答变得更短、拒绝率上升、格式错乱、多语言能力下降等。常见的应对策略包括:使用基于规则的启发式检测(如检查输出长度分布、特定格式合规率)、用另一个评判模型(LLM-as-Judge)对金丝雀流量的输出进行实时打分,或对比新旧模型对相同输入的响应差异(Shadow Mode)。其中Shadow Mode是一种常见的辅助手段——让新模型在不对外提供响应的前提下并行处理生产请求,仅记录输出供质量评估,从而在正式接入流量之前就积累足够的质量信号。
自动回滚
当指标门检测到异常——比如延迟超过阈值或错误率飙升——系统应当立即自动回滚,而不是等待人工介入。
自动回滚的关键优势在于时效性。由于旧模型在爬升过程中始终保持在线(只是流量占比逐渐下降),回滚本质上只是把流量权重重新切回旧部署,不涉及冷启动。这意味着回滚几乎是瞬时的,用户几乎感知不到波动。这也是金丝雀发布相比硬切换最本质的改进:回滚从一次高风险的冷启动操作,变成了一次低成本的流量调权。
为什么专用推理场景尤其需要它
在专用推理部署中,模型通常占用固定的GPU资源,部署和预热成本高昂。这恰恰放大了硬切换回滚的痛点——冷启动一个大模型部署的代价远高于传统Web服务。
金丝雀发布通过让新旧版本在过渡期并存,用额外的短期资源开销换取了升级过程的安全性。对于那些对可用性要求极高的生产服务而言,这笔交易通常是划算的:你多付出的是过渡期的资源成本,换来的是零停机的升级体验和近乎瞬时的回滚能力。
专用推理(Dedicated Inference)与无服务器推理(Serverless Inference)是两种截然不同的部署模式。在无服务器模式下,模型实例按需启动、用完即销毁,平台负责弹性伸缩,用户无需管理底层GPU资源;而在专用推理模式下,用户为特定模型保留了一组固定的GPU实例,这些实例持续运行、随时可接受请求。这种模式的优势是低延迟与高吞吐的稳定性保证,但代价是资源始终被占用,且每次模型部署变更都涉及实质性的初始化开销——包括从存储加载模型权重(对70B以上参数量的模型,权重文件可达数百GB)、将参数映射到显存,以及运行推理引擎的预热(warm-up)请求。正是这种高昂的冷启动成本,使得专用推理场景下的模型升级比普通Web服务回滚的代价高出一个数量级,也因此让金丝雀发布"旧部署保持在线"的设计思路变得尤为关键。
落地建议
要把金丝雀发布真正用好,有几点值得在实践中注意。
流量爬升的节奏应根据业务容忍度来设定——高风险服务可以放慢节奏、增加观察窗口;指标门的阈值要基于历史基线数据设定,既不能过于宽松放过真实问题,也不能过于敏感导致频繁误触发回滚;此外,建议把输出质量的监控纳入门控体系,而不只是看延迟和错误率这类系统指标,因为模型升级最隐蔽的风险往往来自质量回退而非系统崩溃。
归根结底,金丝雀发布把模型上线从一个二元的、全或无的决策,转变为一个连续的、可观测的渐进过程。对于越来越依赖大模型的生产系统来说,这种发布范式正在从锦上添花变为基础设施级的必需能力。
相关推荐
Anthropic上市:AI泡沫还是买入机会?
Anthropic在纳斯达克上市,开盘价较发行价高出约三分之一,市场给出两万亿美元级别的隐含估值。拆解813亿美元募资、1.5万亿美元发行估值与两万亿美元市场估值三个数字的差异,分析Claude业务增长与5.67亿美元季度营业亏损并存的基本面,并给出下一份财报该关注的检查清单。
FBI的AI黑客警告,为何系于微软一句话
FBI公告称AI工具Artex攻击超2250家组织,但引用链显示该数字源自微软报告中"尝试登录"的表述。尝试与成功入侵之间的差距,揭示了这场AI驱动攻击的真实规模与日志证据的局限。
Fable 5.2 助攻:浏览器里的月球火星探索游戏 Getsumen Express 诞生记
开发者利用 Fable 5.2 平台打造浏览器游戏《Getsumen Express》,玩家可探索月球火星、扫描真实地标、射击外星人并乘坐星际列车。游戏基于 Three.js 与 WebGPU 开发,成本约 730 美元,展示了 AI 辅助开发的潜力。