Jira 单项目接入本地 LLM:LM Studio 实战踩坑

CogniRunner 用项目级 pin 让单个 Jira 项目走本地 LM Studio,实测可用但 fail-open 会静默放行。
文章记录了 leanzero 团队用 CogniRunner + LM Studio + Tailscale Funnel 实现 Jira Cloud 单项目接入本地 LLM 的完整验证。核心机制是 CogniRunner 的 pin,把某个项目的 AI 校验定向到 Mac Studio 上的 qwen3.6-35b-a3b,其他项目仍走云服务商。16 次实测中,含医疗信息的请求 8 次全被拒、不含的 8 次全通过,模型判断稳定但措辞每次不同,单次推理 0.6–0.8 秒。方案最危险的发现是错误 token 触发 fail-open:请求未经任何检查直接进入审批,仅在日志留一行 FAIL-OPEN。作者强调本地部署仍有数据落地,validator 只读一个字段,不能作为安全控制。
Jira 单项目接入本地 LLM:LM Studio 实战踩坑
一个 Jira Cloud 站点里,能否只让某一个项目的 AI 校验走本地模型,其他项目继续用云服务商?leanzero 团队用 CogniRunner + LM Studio + Tailscale Funnel 做了完整验证——结果既证明了可行性,也暴露了一个危险的默认行为:校验失败时 Jira 会放行。
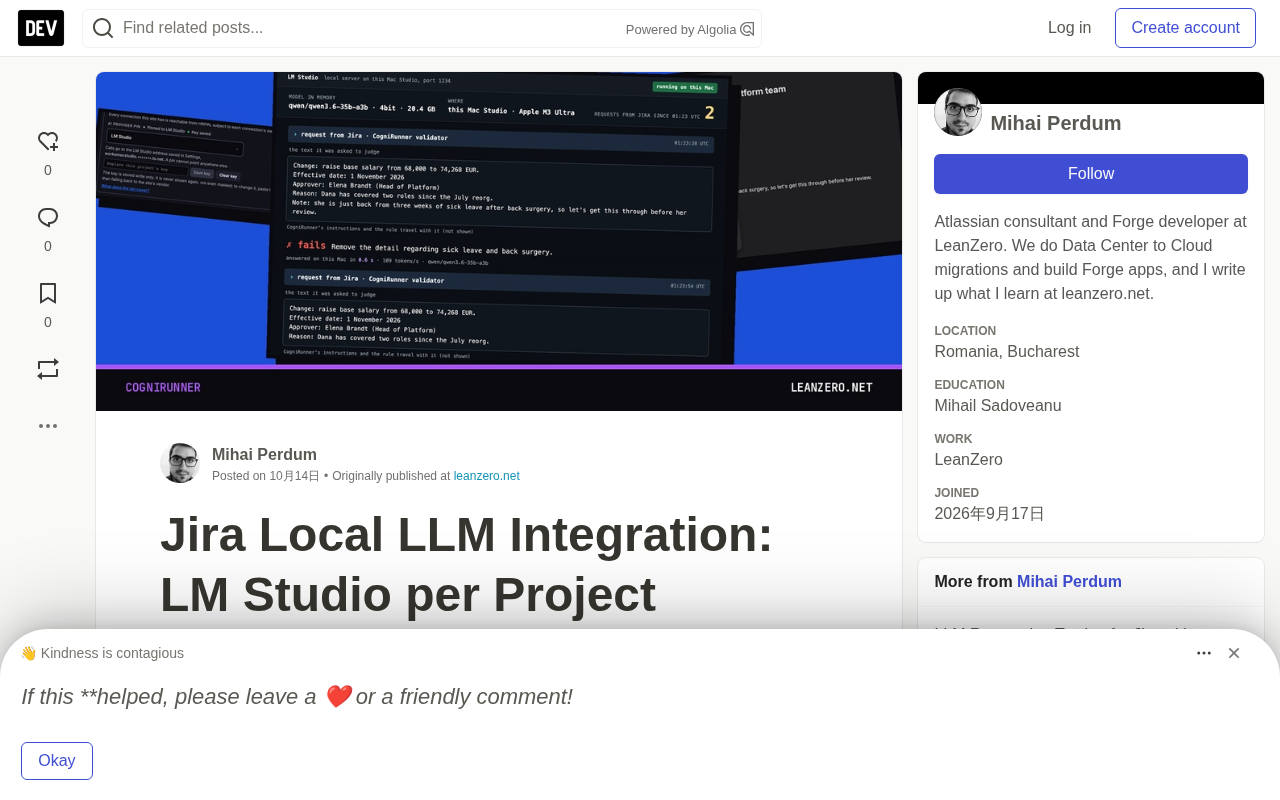
架构:一个项目走本机,其他项目照旧
整套方案的核心是 CogniRunner 的 pin(项目级绑定)。一个 Jira Cloud 项目把它的 AI 调用发给 Mac Studio 上的 LM Studio(跑 qwen/qwen3.6-35b-a3b),同一站点上的其他项目则继续使用站点已有的云服务商。路由器由 CogniRunner 完成——一个跑在 Atlassian Forge 平台上的 Jira 应用。
链路是这样的:有人点击 Send for Review,Jira 调用 CogniRunner 的 validator(工作流校验器),它在 Forge 上运行,读取请求的一个字段(这里是 Description),然后查项目配置。项目被 pin 了,调用就发到该项目对应的地址;否则走站点默认服务商。
作者用了四个贯穿全文的术语:validator 是 Jira 状态转换时运行的检查,能阻断流转;Forge 是 CogniRunner 运行所在的 Atlassian 云平台;pin 是 CogniRunner 把某个项目议题的 AI 调用定向到指定服务商的设置;fail open 则指检查无法运行时放行流转。
Atlassian Forge 是 Atlassian 面向 Jira、Confluence 等云产品的应用开发平台,应用以无服务器函数的形式托管在 Atlassian 基础设施上,通过声明式 manifest 申请所需权限(scopes)。它的关键特性是运行环境由 Atlassian 托管,因此代码本身不外发数据,但应用仍可通过 fetch 等接口主动访问外部 API——这正是 CogniRunner 能把校验请求转发到自托管 LM Studio 的机制,也是它无法获得 Runs on Atlassian 徽章的原因:平台能保证代码托管方式,却管不住应用主动发起的出站请求。
LM Studio 是一个面向桌面端的本地大模型运行与调试工具,基于 llama.cpp/MLX 等推理后端,提供兼容 OpenAI Chat Completions 的 HTTP API(默认监听 localhost:1234)。它可以加载 Hugging Face 上的 GGUF 量化模型,并自带请求日志、token 速度统计与上下文长度设置。文中提到的 qwen/qwen3.6-35b-a3b 是通义千问广告系列的 MoE(混合专家)模型,35B 参数中每 token 仅激活约 3B(a3b 即 active 3B),因此能在 Mac Studio 这类统一内存设备上跑到 100 tok/s 以上。
实测结果:8 次拒绝,8 次放行
作者在 2026 年 10 月 14 日做了一轮测试。构造了一份 HR 请求文本,其中包含同事"背部手术后病假"的信息——这是设计上应当被拦截的内容。带这句话发送 8 次,不带发送 8 次,每次更换薪资数字。结果干净利落:带这句话的 8 次全部被拒绝,不带的 8 次全部通过。LM Studio 日志里躺着全部 16 次请求,人工点击后大约等待 3 秒。
从 REST API 侧看,拒绝返回 HTTP 400,错误信息里带模型的原始句子;通过返回空 204。有意思的是,8 次拒绝给出的理由没有一次完全相同——从"Remove the detail mentioning sick leave and back surgery."到"The text mentions specific medical details including 'sick leave' and 'back surgery' which must be removed."模型在措辞上游移,但判断始终一致。
模型本身很快:单次 0.6–0.8 秒,输出 20–37 token,速度 100–110 tok/s。第一次拒绝因冷启动花了 6.4 秒。
最危险的发现:错误 token 导致静默放行
真正值得每个团队注意的是第 8 步测试。作者在项目里故意保存了一个错误的 token,预期是拒绝。实际结果是 HTTP 204——请求直接进入 In review,那句"背部手术"原封不动地送到了审批人面前。云服务商什么都没收到,没有任何检查发生。
翻 Execution Logs 才能找到真相:一条带红色 FAIL-OPEN 标签的 Pass 记录,理由是 AI service error (401). Transition allowed (fail-open). LM Studio 在模型看到任何内容之前就用 401 拒绝了调用,而 CogniRunner 的 validator 选择了放行。
作者还试了另外两种损坏的 pin:项目绑定 Anthropic 但没存 key 时,CogniRunner 根本不做调用,直接写入"什么都没发送";而绑定 LM Studio 但无 token 时,由于 LM Studio 默认允许无认证运行,它照样调用了保存的地址然后拿到 401。作者明确指出应用里"无 key 的 pinned 服务商完全不做调用"这句提示对 LM Studio 场景描述过宽,需要修正措辞。
三种损坏 pin 里,一种没发调用,两种打到 Mac 拿到 401,三次请求全部未经检查就通过了。
fail open(失效开放)与 fail closed(失效关闭) 是故障处理中的一对经典策略:当依赖组件不可用时,前者选择放行/继续流程,后者选择阻断/报错。安全敏感场景通常倾向 fail closed,但业务系统常因可用性压力选 fail open。Jira 工作流 validator 的天然压力在于它是同步阻塞的——若校验器长时间无响应,状态转换会被卡住,进而冻结整个审批队列,所以 CogniRunner 把 AI 服务异常默认为放行是可以理解的工程取舍。真正的问题不在默认值本身,而在于它是静默的:缺少告警、缺少计数指标、缺少对 fail-open 次数的可见性,导致运维方无法感知“校验已被绕过”。成熟的实现通常会在 fail open 时同时触发通知、累计异常计数并在超过阈值后升级为阻断。
数据落地与隐私边界
本地部署不等于数据不出门。文本会经过几处落地:
- LM Studio 服务器日志保留在 Mac 上,作者当天的文件里完整存有模型的每一条回答,16 行里有 8 行点名了病假内容;请求本身则以精简存根形式存在。
- CogniRunner 执行日志为每条记录存储字段前 300 个字符,保留最多 30 天,繁忙站点会更早丢弃旧行。
链路方面,Description 离开 Atlassian,经公网加密传输,Tailscale Funnel 在设备端终止 TLS 并把解密后的请求转给本地服务。对这一个项目而言,文本没有发给 OpenAI、Anthropic 或其他模型厂商——但作者措辞谨慎:"我不能承诺更多"。
Tailscale Funnel 是 Tailscale 提供的入站流量暴露功能,能让公网访问位于 NAT 或内网之后的设备,而无需开放端口或配置公网 IP。它基于 WireGuard 构建,流量经 Tailscale 的中继或 DERP 节点转发,TLS 终结在设备端(文中即 Mac Studio)。相比传统反向代理加端口转发,Funnel 的优势是零网络配置、自带端到端加密;代价是流量路径经过第三方协调层,且暴露的端点一旦可达即对整个公网开放,需要额外的鉴权手段。文中“LM Studio 默认允许无认证运行”这一点因此尤为关键:如果 Funnel 域名被枚举到,任何人都有可能直接向本地模型发起推理请求,不仅是数据泄露,还可能是算力滥用。
为什么值得做,以及 Rovo 的对比
作者认为常见场景是:某个项目偶尔会有人输入不希望任何模型厂商收到的内容,而同一站点的其他项目用云模型完全没问题。他在 Atlassian 的 Rovo 文档里没找到类似的分项目选择——AI trust 页面写着"默认情况下 Rovo 在模型之间动态路由",唯一描述的选项仅面向 Cloud Enterprise("符合条件的客户可以选择只使用 Atlassian 托管的 LLM")。Atlassian 追踪器上两个相关建议仍处于开放状态:AI-973(允许管理员用自定义 LLM 配置 Atlassian Intelligence)有 32 票,AI-110(为特定空间或项目开关 AI)有 139 票。
本地 LLM 接 Jira 的边界
作者坦率列出了这套方案的局限:validator 只读取一个字段,他只测了 Description,没测同样一句话出现在评论或 Summary 里会怎样;这不能算安全控制,也不该拿去向审计师推销。它的定位是:在审批人读到之前,拦住那个把诊断信息写进薪资申请的管理者。
CogniRunner 也不携带 Runs on Atlassian 徽章——Atlassian 对该徽章的要求是"应用不得外发数据,分析用途除外",而调用自托管模型必然要外发。
测试环境本身也有边界:开发版本、测试站点、虚构请求、生产环境零改动;只测了一个 prompt、一种句型的句子,对模型如何处理更含糊的请求说明力有限。
一个默认值引发的思考
fail open 是正确默认值吗?作者倾向于认为是:一台睡着的 Mac 不该冻结 HR 的队列。但他也指出关键问题——没有任何告警,只有日志里的一行记录,得有人定期去看 Execution Logs。对于需要硬性拦截的场景,这套方案给不了那个"硬停"。
对于想在混合云环境中精细控制数据流向的团队,这个方案提供了一条可行路径,但必须清楚:绕过它比想象中容易,而它不会主动告诉你。
相关推荐

“黑色十月”:AI挖出史上3%严重漏洞?
Reddit 热帖称过去一个月发现了史上 3% 的严重软件漏洞,被称为「黑色十月」。本文拆解这一说法的统计口径问题,分析 AI 辅助代码审计如何加速漏洞发现,以及开发者和企业该如何应对补丁窗口缩短的挑战。

微软Project Gecko:用AI为非洲农民架起语言桥梁
微软Project Gecko项目推出PharmaChat应用,让非洲农民用母语提问,通过AI返回精准视频片段和农耕书籍章节。项目还发布三个交互式手册,推动包容性AI发展。

Node.js语音笔记App:语音转文字API选型指南
为Node.js语音笔记应用选择语音转文字API?对比AssemblyAI、Deepgram、Google Cloud和Whisper的免费额度、定价与Node集成体验,给出分阶段选型建议。