JOLT:一个模型兼任师生,训练效率提升6.5倍

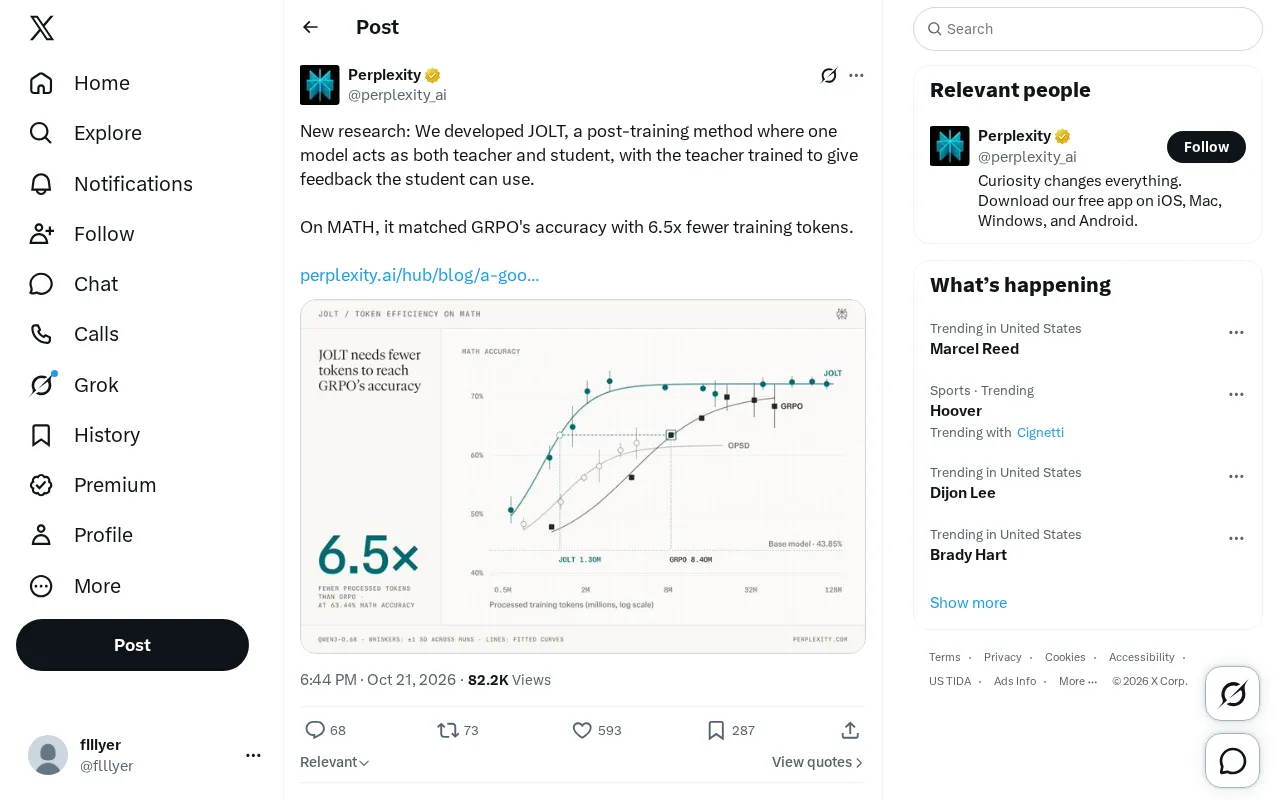
JOLT让同一模型兼任师生,以1/6.5的token达到GRPO同等数学推理精度。
文章介绍了一项名为JOLT的大模型后训练方法,其核心是让同一个模型同时扮演教师和学生,并对教师角色进行专门训练,使其产出学生能够消化利用的反馈信号,从而缩小师生间的表征鸿沟。在MATH数学推理基准上,JOLT以约GRPO六分之一的训练token达到了同等准确率,若可复现,将实质性地改变后训练的成本结构。文章同时指出该结果仅限单一基准、单一来源,总FLOPs代价、教师训练开销、共享参数下的能力退化与奖励hacking风险均待验证,并讨论了其对中小团队和实验迭代速度的潜在影响。
大模型后训练(post-training)的成本瓶颈,往往不在算力本身,而在于训练数据的利用效率。传统强化学习方法如GRPO需要大量采样和试错,token消耗惊人。近期一项名为JOLT的研究提出了一条新思路:让同一个模型同时扮演教师和学生,教师被训练成能给出学生用得上的反馈,从而大幅压缩训练所需的token量。
JOLT的核心设计:教师与学生合二为一
JOLT的全称并未在原始素材中披露,但其机制描述足够清晰。在常规的师生蒸馏或反馈学习中,教师模型和学生模型通常是两个独立实体——教师负责评价或生成指导信号,学生负责学习。JOLT打破了这一分离:同一个模型既做教师又做学生。
关键在于,教师角色并非天然具备给出有效反馈的能力,而是被专门训练出来的。研究团队让教师部分学会生成学生能够消化和利用的反馈信号,而非泛泛的评价。这种“反馈可用性”的训练目标,是JOLT区别于普通自博弈方法的核心。
从信息论的角度看,这一设计减少了师生之间的表征鸿沟——因为二者共享同一套参数基底,反馈信号的分布天然更贴近学生当前的能力边界。
效率数据:6.5倍token缩减意味着什么
据研究团队披露,在MATH数学推理基准上,JOLT达到了与GRPO相当的准确率,而训练token消耗仅为后者的约1/6.5。
这个数字值得拆开来看。GRPO(Group Relative Policy Optimization)是当前主流的大模型推理能力强化学习方法,被广泛用于数学和代码任务的后训练。它的效率问题一直存在争议:需要为每个问题生成多个采样回答、计算组内相对优势,token开销与采样数量成正比。JOLT用6.5倍的token缩减达到同等精度,如果这一结果能在更多任务上复现,对后训练成本结构的影响是实质性的。
需要说明的是,目前公开的效率对比仅限MATH一个基准,样本范围有限,尚不能推断其在代码生成、多轮对话或开放域推理上的表现。
GRPO 与组内相对优势
GRPO(Group Relative Policy Optimization)由 DeepSeek广告 团队在 2024 年提出,是 PPO 的一种变体,专为 LLM 推理任务的后训练设计。它的做法是对同一个问题采样一组(通常 8~64 个)回答,用奖励模型或规则打分,再以组内平均分为基线计算每个回答的相对优势,从而省去 PPO 中独立的价值网络(critic)。这降低了显存和模型规模开销,但代价是 token 消耗与采样组大小成正比:每个问题都要生成多条完整推理链,长链推理任务上这一开销尤为突出。JOLT 的 6.5 倍缩减正是针对这一结构性成本,而非单纯优化采样实现。
与现有方法的定位差异
JOLT并非首个尝试压缩后训练成本的工作。此前的方向包括拒绝采样微调、直接偏好优化(DPO)系列方法、以及各类自奖励(self-rewarding)机制。JOLT的差异点在于两点:一是师生同体,二是教师反馈经过专门训练以适配学生。
自奖励方法通常让模型对自己的输出打分,但打分能力与生成能力之间的错位是常见失败模式——模型可能给自己错误答案打高分。JOLT通过训练教师角色来缓解这一问题,但具体如何防止奖励 hacking,原始素材未展开,这可能是论文中需要重点关注的技术细节。
自奖励与奖励 hacking
自奖励(self-rewarding)指让模型对自己的输出进行评价或打分,从而在无外部标注的情况下构造训练信号。其典型失败模式是奖励 hacking:模型学会产出容易被自己打高分的答案,而非真正正确的答案,导致打分能力与生成能力同步漂移、训练信号失真。常见缓解手段包括引入外部奖励模型、设置评分与生成的角色分离、或对评分施加正则约束。JOLT 的“教师角色专门训练”本质上是在同一参数基底上人为制造角色分工,思路接近后者,但师生共享参数是否会重新引入评分—生成耦合,是判断其能否规避奖励 hacking 的关键。
值得关注的开放问题
从单一来源的简短披露中,有几个问题尚无法回答。其一,JOLT在MATH上的准确率绝对值是多少,与GRPO打平是在何种模型规模下实现的;其二,6.5倍token缩减是否以更多的训练步数或更复杂的教师训练阶段为代价——总计算量(FLOPs)与token数并非同一口径;其三,教师与学生共享参数时,是否存在能力退化或模式坍塌的风险。
这些都是评估该方法实际可用性的关键,有待论文全文和后续复现工作给出答案。
token 数与 FLOPs 并非同一口径
大模型训练成本通常有两种度量:token 数反映数据吞吐量,FLOPs 反映实际浮点运算量,二者关系取决于模型规模、序列长度和前后向计算比例。JOLT 报告的 6.5 倍缩减是 token 口径;如果它需要额外的教师训练阶段、更多训练步数,或每步要跑多次前向(教师评价 + 学生生成),总 FLOPs 的节省可能明显小于 6.5 倍,甚至在模型较小时出现倒挂。评估这类方法时,应同时报告 wall-clock 时间、总 FLOPs 与峰值显存,否则“效率提升”的结论容易在不同口径间被放大。
对后训练实践的可能影响
如果JOLT的效率优势具有泛化性,最直接的受益场景是中小团队和学术实验室——它们往往受限于token预算,无法承担GRPO级别的大规模采样。同等精度下token需求降低一个数量级,意味着推理能力后训练的门槛下移。
另一个角度是迭代速度。后训练实验的周期很大程度上受采样成本制约,token效率提升会直接缩短实验反馈循环,让研究者能在相同预算内尝试更多超参配置和课程设计。
当然,在独立复现出现之前,这些判断都停留在推测层面。单一基准、单一来源的结果,需要更多验证才能转化为工程实践中的默认选项。
相关推荐

Hermes Agent零基础实战:自进化AI助手
Hermes Agent 零基础教程:GitHub 41.7K 星的自进化 AI Agent 怎么装怎么用。本文拆解其学习循环、三层记忆与 Skill 自改进机制,对比 Claude Code 和 OpenClaw 的差异,并附 WSL 安装实操步骤。

RAG面试核心:离线建库与在线检索全流程拆解
拆解RAG检索增强生成的完整工作流程:离线阶段文档加载、切割、向量化、入库,在线阶段问题改写、向量检索、重排、生成,并解析RAG面试核心考点与系统优化方向。

AI大模型零基础入门:原理与API调用实战指南
从AI发展脉络到大模型训练原理,再到Token、Temperature、Top-P等核心概念,本文结合实战课程讲解系统提示词、Function Call、RAG与记忆能力的实现逻辑,并给出四类API调用场景的落地路径,适合零基础开发者入门。