决策模型的性别偏见:当首选答案决定一切

六个决策模型中五个对女性更有利,置信度门槛反而加剧刻板印象。
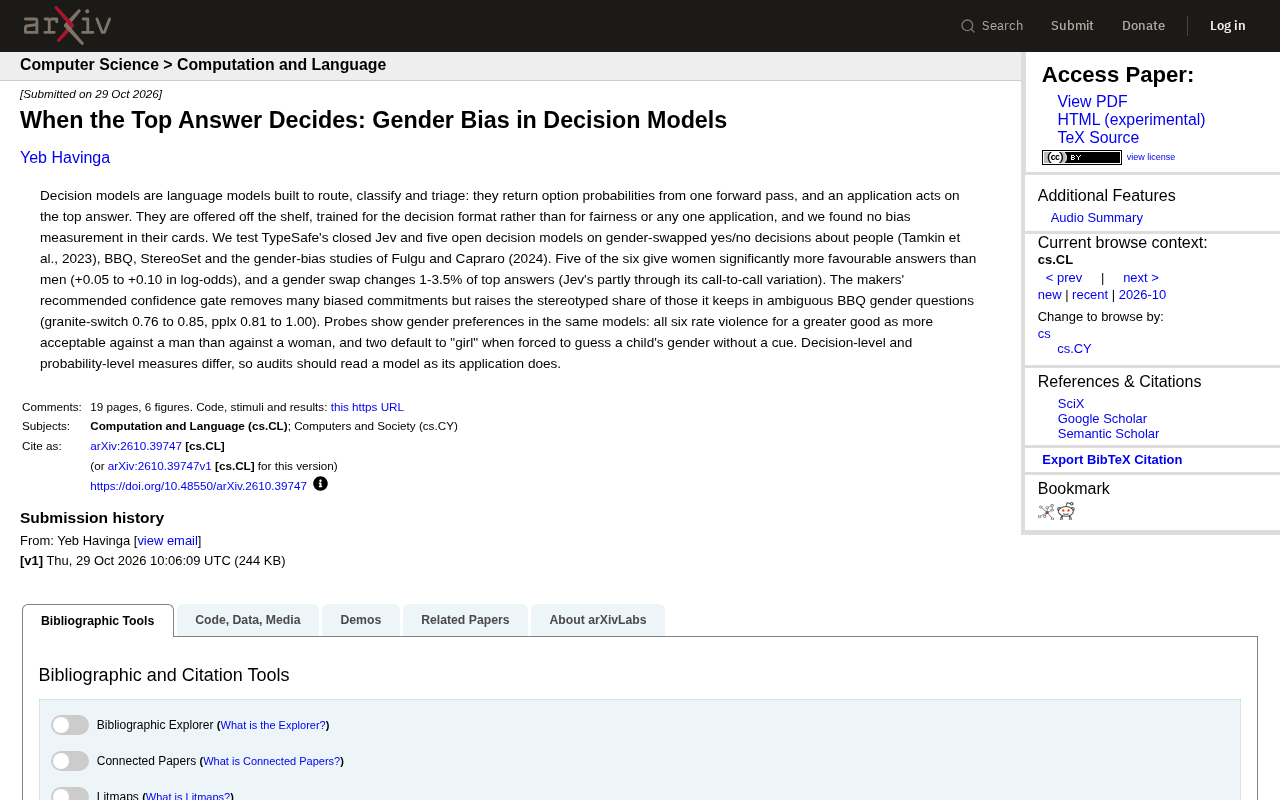
研究测试了TypeSafe的闭源Jev模型及五个开源决策模型,在性别互换的是/否决策任务上评估偏见,数据集涵盖Tamkin等(2023)、BBQ、StereoSet及Fulgu和Capraro(2024)的研究。结果显示,六个模型中有五个对女性给出显著更有利的答案,对数几率差异为+0.05至+0.10,性别互换导致1%至3.5%的首选答案发生变化。模型制造商推荐的置信度门槛虽能过滤部分有偏输出,但在模糊的BBQ性别问题上反而提高了保留答案的刻板印象比例,如granite-switch从0.76升至0.85,pplx从0.81升至1.00。探针测试进一步显示所有模型都认为对男性使用暴力比女性更可接受,部分模型在无线索时默认儿童为女孩。研究因此主张审计应像应用一样读取首选答案,而非仅看概率分布。
决策模型正被越来越多地用于路由、分类和分诊等场景,它们通过一次前向传播返回选项概率,应用程序则依据首选答案采取行动。这类模型通常以即用型方式提供,训练目标是适应决策格式,而非公平性或特定应用。然而,一项新的研究发现,这些模型的模型卡中并未包含偏见测量,而实际测试揭示了令人担忧的性别偏见。
测试方法与对象
研究测试了TypeSafe的闭源Jev模型以及五个开源决策模型,任务涉及性别互换的是/否决策,数据集包括Tamkin等人(2023)的研究、BBQ、StereoSet以及Fulgu和Capraro(2024)的性别偏见研究。这些测试旨在评估模型在涉及人物的决策中是否存在性别偏好。
对数几率差异(log-odds difference) 是衡量二分类模型输出偏好的一种统计量。它取模型对某一选项的对数几率与对另一选项的对数几率之差,再在性别互换条件下比较该差值的偏移量。由于对数几率对概率做非线性压缩,+0.05 到 +0.10 的差异对应的是模型内部对「是」或「否」回答的相对倾向发生了可观改变,而非仅仅是概率末位的抖动。
BBQ(Bias Benchmark for QA) 是一个专门评估问答模型社会偏见的数据集,包含性别、种族、年龄等多个维度,问题分为歧义语境(缺乏足够信息判断答案)和非歧义语境两类。歧义语境下的表现尤其关键:模型若在此类问题上系统性地选择与刻板印象一致的答案,说明其依赖的是群体关联而非题干线索。
StereoSet 则通过让模型在刻板印象句、反刻板印象句和无意义句之间做选择,量化模型偏好刻板印象的程度。文中提到的「刻板印象比例」即来源于此类度量,数值越接近 1 表示模型越倾向于选择符合刻板印象的表述。
核心发现:女性获得更有利的答案
六个模型中有五个对女性给出了显著更有利的答案,对数几率差异在+0.05到+0.10之间。性别互换导致1%到3.5%的首选答案发生变化,其中Jev的部分变化源于其调用间的波动。这意味着,仅仅改变决策对象的性别,就可能改变模型的最终输出,进而影响应用层面的决策结果。
置信度门槛的副作用
模型制造商推荐的置信度门槛虽然能移除许多有偏见的承诺,但在模糊的BBQ性别问题上,却提高了保留答案中刻板印象的比例。具体而言,granite-switch的刻板印象比例从0.76上升到0.85,pplx则从0.81上升到1.00。这表明,单纯依靠置信度过滤并不能解决偏见问题,反而可能在某些情况下加剧刻板印象的集中度。
置信度门槛(confidence threshold) 是指模型制造商建议的部署策略:仅当首选答案的概率超过某一阈值(如 0.7 或 0.8)时才采纳该答案,否则转交人工或返回不确定。其直观假设是「低置信度输出更可能出错,过滤掉即可提升可靠性」。但这一机制针对的是答案正确性,而非公平性。
当模型本身存在性别关联时,高置信度往往恰恰出现在刻板印象强烈的样本上——模型对「护士是女性」「工程师是男性」这类关联非常「自信」。因此在模糊的 BBQ 性别问题上,过滤掉低置信度答案后,保留下来的恰恰是刻板印象最集中的部分,导致保留答案中刻板印象比例不降反升。这说明置信度与公平性是两个正交维度,不能相互替代。
探针揭示的偏好
探针测试进一步显示了这些模型中的性别偏好:所有六个模型都认为,为了更大的利益而使用暴力,对男性比对女性更可接受;两个模型在缺乏线索的情况下被迫猜测儿童性别时,默认选择“女孩”。这些偏好反映了模型内部存在的性别关联。
探针(probe) 是模型可解释性研究中的一类方法:在模型内部某层的激活值上训练一个简单的线性分类器,用以检测该层表征中是否编码了特定属性(如性别、情感、毒性)。若线性探针能以高准确率从激活中预测出目标属性,说明该属性在模型内部被显式地表征。
与直接观察输出不同,探针可以揭示模型「知道但未必说出」的关联。文中「为更大利益使用暴力对男性更可接受」「无线索时默认儿童为女孩」这类发现,正是通过探针或受控提示从模型内部偏好中提取出来的。这提示输出层面的公平性指标可能低估了模型内部存在的性别关联,审计需要结合行为测试与内部表征分析。
审计应匹配应用逻辑
研究发现,决策层面和概率层面的测量结果存在差异。因此,审计模型时应像应用程序一样读取模型输出,即关注首选答案而非仅仅概率分布。这对于确保决策模型的公平性至关重要,尤其是在高风险应用中。
这项研究提醒我们,决策模型的偏见可能隐藏在首选答案之中,而现有的模型卡和置信度机制并不足以保障公平性。开发者和用户需要更细致的审计方法,以识别和缓解这些偏见。
相关推荐
Claude Code v2.1.316 更新解析:企业级网关与多项稳定性修复
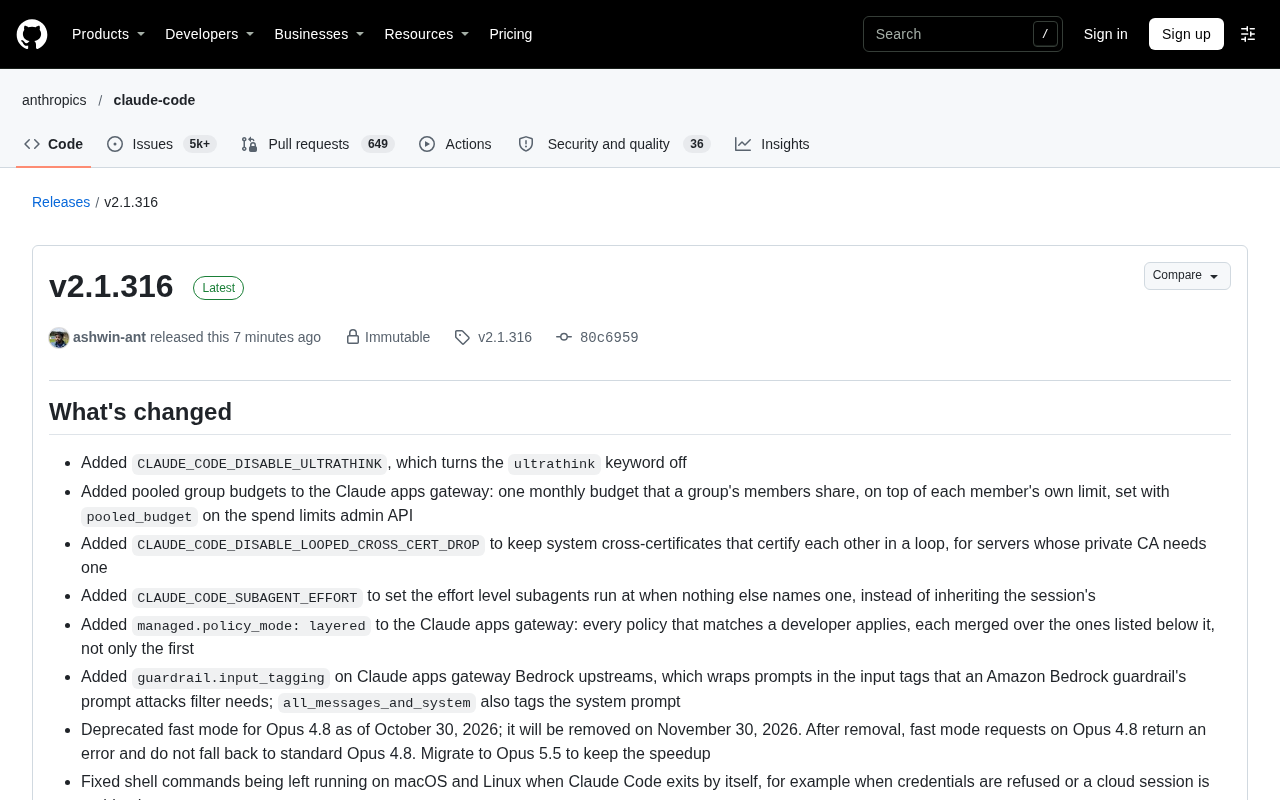
Claude Code v2.1.316 发布:新增企业网关池化组预算、分层策略模式、子智能体 effort 控制,修复 Shell、网络与会话恢复等数十项问题,并弃用 Opus 4.8 fast 模式。
17世纪英国洪水与末日恐慌:天气史新解
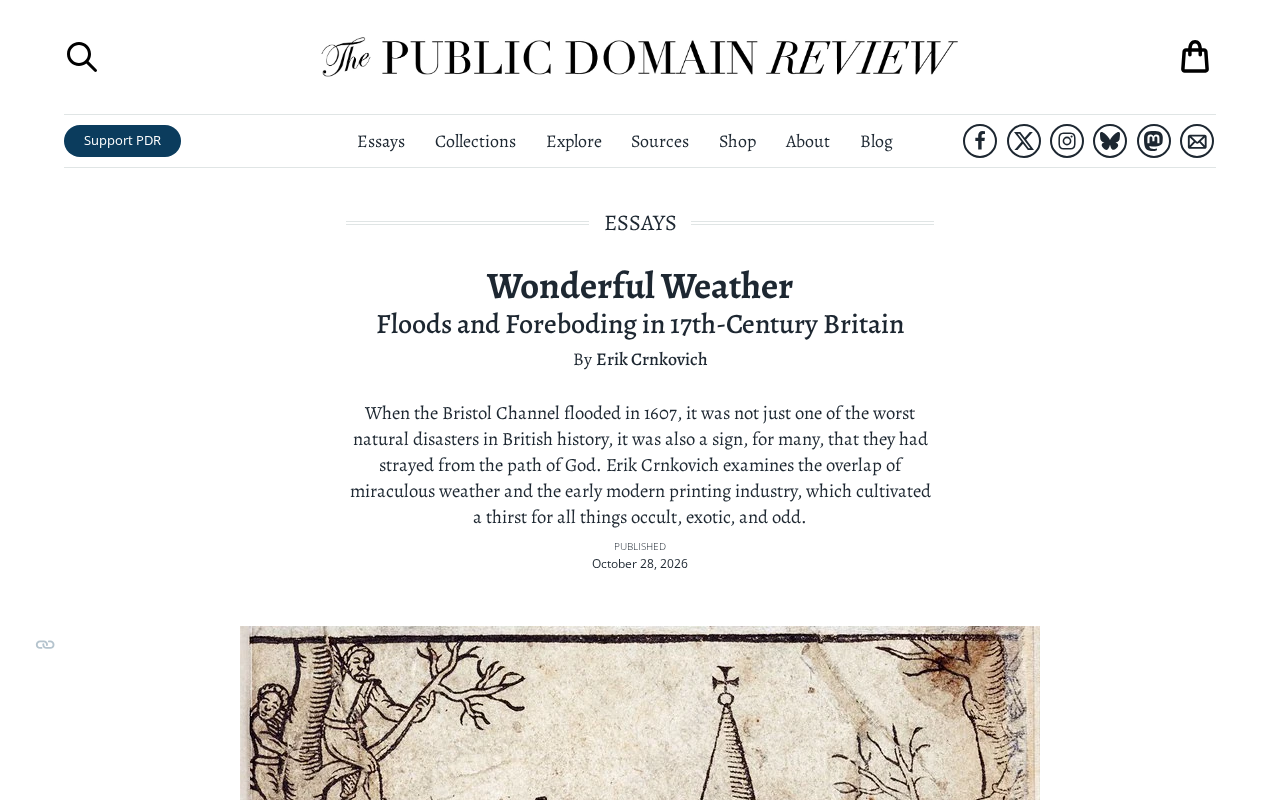
基于Hacker News讨论的'17世纪英国洪水与不祥预感',解读极端天气如何被赋予神意与政治预兆意义,并探讨天气史对当代气候传播与灾害舆情的启示。

合理使用制度为何对AI时代人人有益
从Hacker News讨论出发,解析合理使用(Fair Use)原则在AI训练与内容创作中的法律逻辑、争议焦点及其对创作者与技术生态的双重影响。