均值回归:LLM如何悄然扼杀创新与多样性

当AI成为平均主义的引擎
在统计学中,均值回归(Regression to the Mean)描述的是一个朴素而深刻的现象:极端值在后续观测中往往会向平均水平靠拢。这一概念最早由英国统计学家弗朗西斯·高尔顿(Francis Galton)在19世纪研究遗传学时发现——他观察到高个子父母的子女身高往往会"回归"到人群平均值。值得注意的是,高尔顿这一发现背后有更深的统计学含义:当两个变量存在不完全相关时,极端观测值的出现部分源于随机波动,后续观测自然会"收缩"向均值。诺贝尔经济学奖得主卡尼曼(Daniel Kahneman)后来在《思考,快与慢》中引用这一原理,揭示人类在判断因果关系时的系统性偏误——我们倾向于将均值回归误读为某种干预的效果。此后,这一规律在金融市场、医学研究、体育成绩等领域无处不在。当我们把这一概念投射到大语言模型(LLM)身上时,一个令人不安的图景开始浮现——这些强大的AI系统,本质上正是一台将一切拉向平均值的引擎。
这一观点在Hacker News上引发了热烈讨论:LLM在带来生产力革命的同时,可能正在悄然扼杀真正的"新"(the new)——那些出乎意料的、打破常规的、真正原创的思想与表达。
LLM的数学本质就是均值回归
从技术层面看,这一论断并非危言耸听。LLM的核心机制是预测下一个最可能出现的token,意味着每一次输出本质上都是在训练数据分布中寻找概率最高的路径。概率最高,往往也意味着最常见、最典型、最"平均"。
这一机制基于Transformer架构中的自注意力机制(Self-Attention)和Softmax概率分布。Transformer架构由Google在2017年的论文《Attention Is All You Need》中提出,其核心创新是自注意力机制——允许模型在生成每个token时,动态权衡序列中所有其他token的重要性。在生成阶段,模型对词汇表(通常包含32,000至128,000个token)计算Softmax概率分布,形成一个总和为1的概率向量。通过"温度"(Temperature)参数控制采样的随机性:温度趋近0时输出最高概率token(最保守),温度升高时引入更多随机性(更具创意但也更不稳定)。从数学上看,温度参数T通过在Softmax前缩放logits(logits/T)来控制分布的"尖锐度"——这意味着所谓的"创意模式",本质上不过是人为注入的随机噪声,而非真正意义上的原创思维。
换句话说,LLM被优化的目标是生成"看起来最合理"的内容,而"最合理"的另一面恰恰是"最不出人意料"。真正的创新往往诞生于低概率区域——那些训练数据中罕见的、边缘的、甚至看起来"错误"的组合。当一个系统被设计为始终选择高概率输出时,它天然地与突破性创新背道而驰。
创新的悖论:稀有性被系统性稀释
为什么"新"如此脆弱
真正的新颖性在人类文明中始终是稀缺资源。一个颠覆性的科学假说、一种前所未有的艺术风格、一句从未有人说过的表达——它们之所以珍贵,正是因为偏离了既有的模式。在认知科学中,"远距联想"(Remote Associative Thinking)理论由心理学家萨诺夫·梅德尼克(Sarnoff Mednick)于1962年提出,并发展出了著名的RAT测试来量化创造力。神经科学研究显示,创造性思维与大脑的默认模式网络(Default Mode Network, DMN)高度相关——这一网络在人们进行非结构化思考时最为活跃。2019年发表于《美国国家科学院院刊》的研究表明,高创造力个体的DMN与执行控制网络之间存在更强的异步耦合,使得语义距离遥远的概念能够被同时激活并产生连接。这一机制与LLM存在根本差异:人类创造性思维的"远距性"源于生物神经网络的并行激活特性,而LLM的自回归生成始终沿着训练数据中的高概率路径前进——这恰恰是高概率预测模型难以触及的盲区。
而LLM的问题在于,它把这种偏离"抹平"了。当越来越多的写作、编程、设计与研究借助LLM完成时,我们实际上是在让一个平均化引擎介入人类创造的每一个环节。这种渐进式的思想同质化不会以某次灾难的形式降临,而是通过无数次微小的、几乎无法察觉的"向平均回归"悄然累积。
反馈循环的危险:模型崩溃效应
更深层的隐患在于数据的循环污染。当AI生成的内容大量涌入互联网,这些内容又会成为下一代模型的训练数据,形成一个自我强化的反馈循环:
- 第一代模型学习人类创作,输出趋向平均
- 这些平均化内容成为第二代模型的训练素材
- 第二代模型进一步收窄输出的多样性
- 循环往复,分布的"尾部"逐渐消失
学术界将这一现象称为模型崩溃(Model Collapse)。2023年,牛津大学Ilia Shumailov团队在Nature上发表的研究系统阐述了这一效应,并通过信息论框架给出了精确描述:当模型在自身生成数据上迭代训练时,相当于对原始数据分布进行有损压缩后再压缩——每一轮迭代都丢失了分布尾部的低频信息。从KL散度角度看,第n代模型的输出分布与原始人类数据分布之间的差异随迭代单调递增,而分布熵则单调递减。实验数据显示,经过5-10轮迭代训练后,模型在低频词汇和长尾知识上的覆盖率下降超过40%,而输出的文本在表面流畅性上几乎没有可察觉的退化——这正是其危险性所在:退化是无声的,难以被常规质量评估方法检测到。稀有的长尾知识(如专业术语、小众文化、边缘观点)首先消失,最终模型收敛为一种"文化平均态"。这与信息论中的熵减现象高度吻合——系统在封闭循环中自发走向有序但贫乏的状态。均值回归的隐忧,正与这一研究发现遥相呼应。
"安静的死亡":看不见的创新代价
效率与创新之间的隐形交换
"the quiet death"(安静的死亡)这一表述极具张力。它暗示创新的消亡不会以戏剧性的方式发生,而是在效率的光环下悄无声息地进行。
LLM带来的生产力提升是真实、可见、可量化的——写邮件更快了,写代码更省事了,做方案更高效了。而它所抑制的创新,却是不可见的机会成本:那些本可能诞生却从未诞生的想法,那些因为"AI给的答案已经够好"而被放弃的深度探索。
我们很难为"没有发生的突破"计算损失,这也是为什么这种代价如此容易被忽视。当每个人都能轻松获得"平均水平的优秀"时,追求"卓越的独特"的动力反而可能被悄然削弱。克莱顿·克里斯坦森(Clayton Christensen)在1997年出版的《创新者的窘境》(The Innovator's Dilemma)中揭示了颠覆性创新的核心悖论:真正改变行业格局的突破几乎从不来自主流玩家的"最优化"路径,而是从性能不足、面向非主流用户的边缘市场切入。历史上几乎所有范式级突破——从量子力学到互联网,从印象派到摇滚乐——在诞生之初都是分布尾部的"异常值"。这一逻辑与LLM的均值化倾向存在深刻的结构性相似:LLM被优化为服务"平均用户"的"平均需求",而这恰恰是颠覆性创新最难以在其中生存的土壤。
争议:工具中性论的另一面
对于这一警示,不同声音之间存在明显分歧。部分观点认为LLM确实在助长思想同质化;反对者则指出,人类文化本就充满模仿与重复,真正的原创从来都是少数,LLM不过让这种既有格局更加显性化。
还有一种中间立场值得关注:LLM是工具,均值回归的效应取决于使用方式。把它当作"标准答案生成器",确实会强化平庸;但把它作为"思维碰撞的对手"或"探索边界的助手",反而可能激发人类跳出常规。工具本身是中性的,关键在于使用者的意图与意识。
如何对抗AI均值回归:守护创新离群值
重新认识LLM输出的局限
面对这一挑战,最重要的是意识层面的觉醒。当我们使用LLM时,需要清醒地认识到:它给你的是最安全的答案,而非最好的答案。真正有价值的思考,往往需要主动偏离AI的默认建议。
在创新研究领域,"离群值"(Outlier)对应的正是颠覆性创新的诞生机制。守护创新离群值,本质上是守护人类认知网络中那些低频但高价值的神经连接——它们在LLM的概率分布中被系统性地压低权重,但恰恰是文明进步的关键节点。
几项实践性策略值得参考:
- 将LLM用于处理常规、重复性工作,把创造性思考保留给人类主导
- 主动向模型提出"反常识"的追问,有意识地探索概率分布的尾部
- 保持对AI输出的批判性审视,不轻易接受"够好"的默认答案
- 在关键创新环节保留纯粹的人类协作与非结构化头脑风暴
重新定义AI在创造过程中的角色
LLM作为均值回归引擎的特性,是其数学本质决定的,无法通过简单的技术修补消除。真正的解药在于我们如何定位AI在创造过程中的角色。
如果让AI承担"生成"的主导权,同质化将不可避免;但如果将AI定位为放大人类判断力的工具,把最终的创造性决策权牢牢握在自己手中,那么"新"的消亡或许可以被推迟,甚至逆转。
在AI日益渗透每个创作环节的时代,守护人类思想中那些珍贵的"离群值",可能是我们最重要也最容易被忽视的责任。
核心要点
核心要点
相关推荐
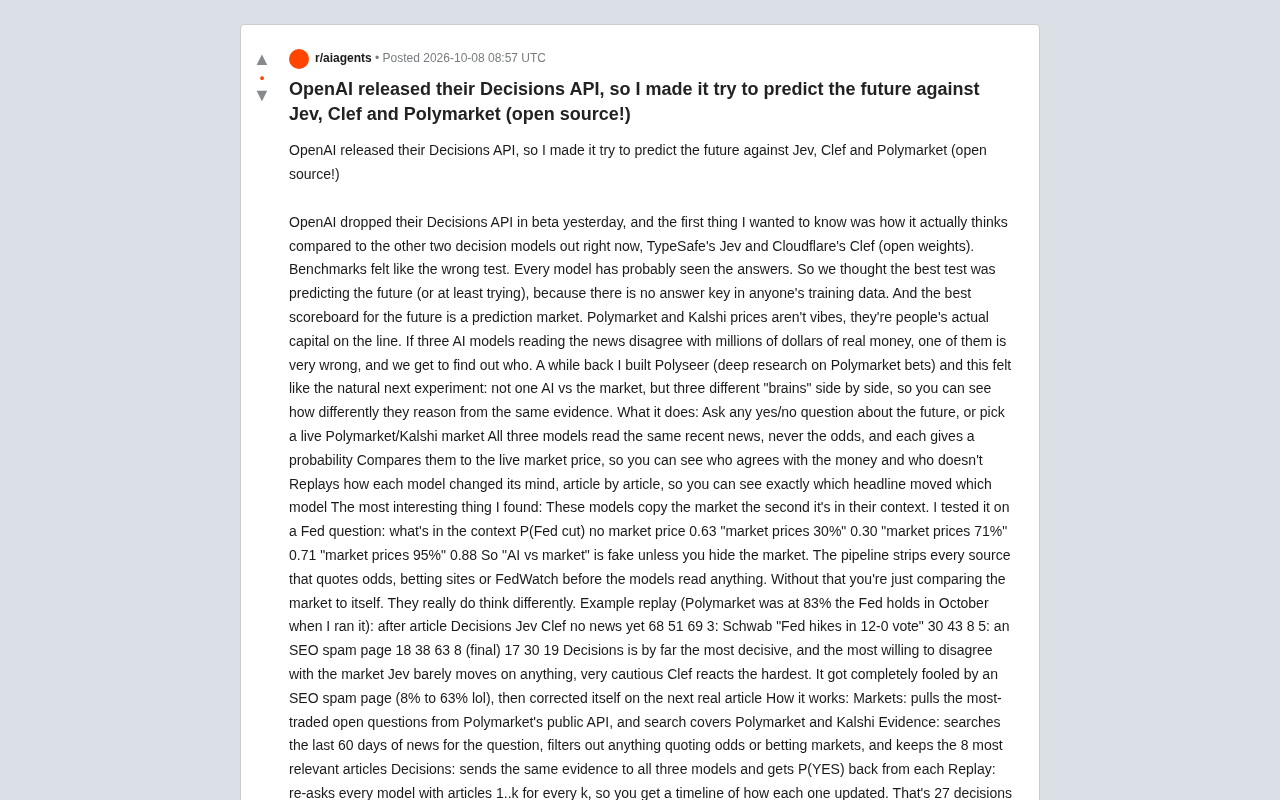
三大AI决策模型对决Polymarket:谁更能预测未来?
开发者用开源项目让 OpenAI Decisions API、TypeSafe Jev 和 Cloudflare Clef 三大决策模型同场预测未来,并与 Polymarket 实时赔率对比。实验揭示模型会复读市场价格,以及三者截然不同的推理风格。
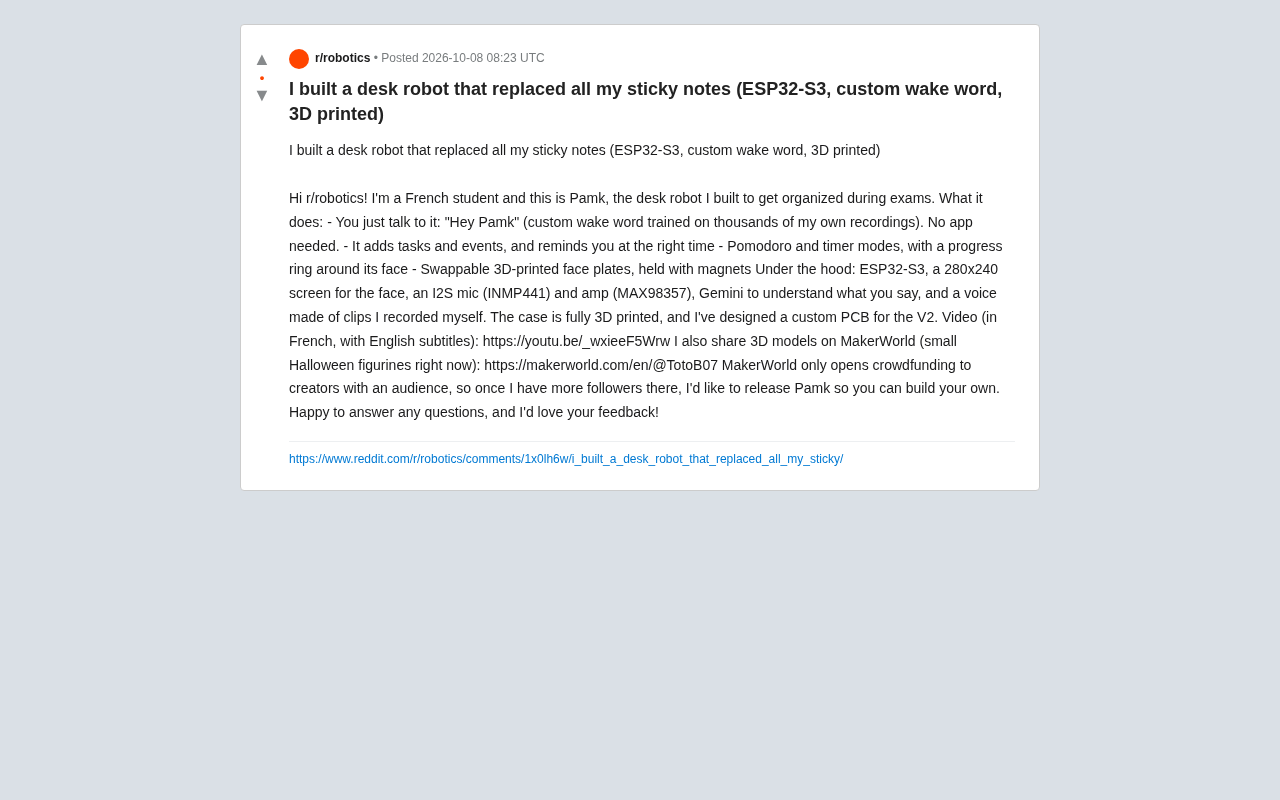
ESP32-S3打造桌面机器人Pamk:自定义唤醒词+Gemini替代便利贴
法国学生用 ESP32-S3 打造桌面机器人 Pamk,通过自定义唤醒词与 Gemini 实现纯语音任务管理,替代便利贴。本文解析其硬件架构、唤醒词训练与开源计划。
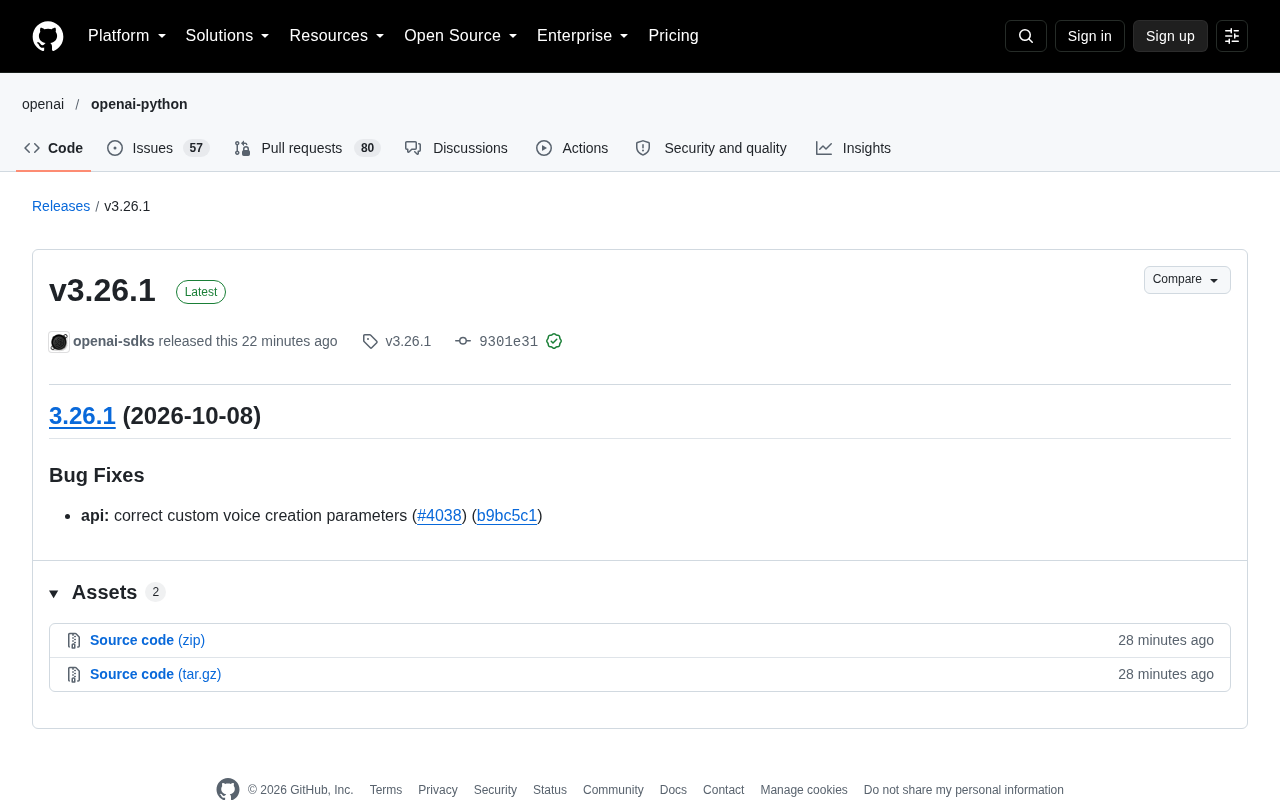
OpenAI SDK v3.26.1 发布:修复自定义语音创建参数
OpenAI SDK 发布 v3.26.1 补丁版本,核心修复自定义语音创建(custom voice)参数问题(PR #4038)。本文解读本次更新内容、影响范围及升级建议。