三大AI决策模型对决Polymarket:谁更能预测未来?
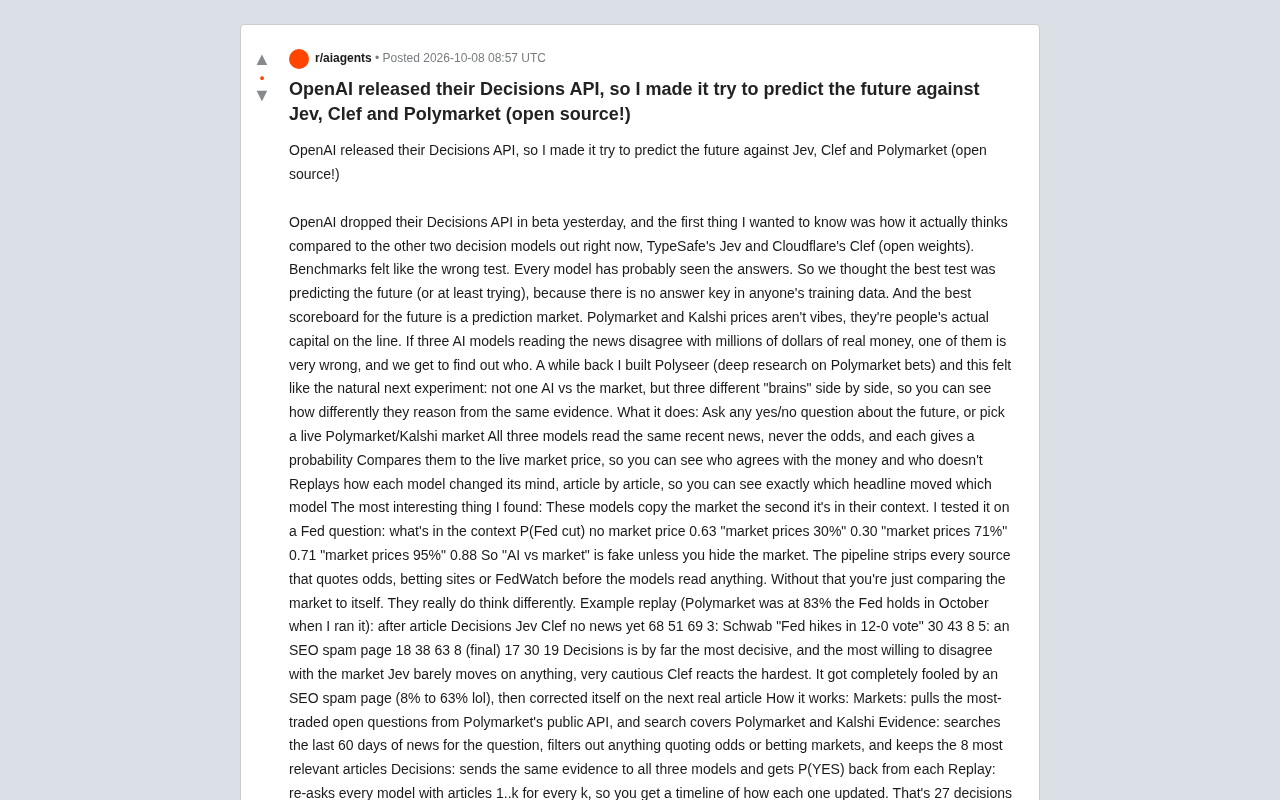
开发者让三大AI决策模型盲测预测未来事件,揭露上下文价格污染会让AI沦为市场复读机。
一位开发者设计了一个开源实验,将 OpenAI Decisions API、Jev 和 Clef 三个决策模型置于相同的新闻证据下,预测未来事件并与 Polymarket、Kalshi 预测市场的实时赔率对比。实验最关键的发现是:只要模型在上下文中看到市场价格,就会几乎直接复读该数字,而非独立推理——这意味着「AI 对抗市场」的前提是必须隐藏赔率。在隐藏价格后,三个模型展现出截然不同的推理风格:Decisions 果断激进,Jev 极为保守,Clef 反应剧烈且易被垃圾信息带偏。项目还提供逐篇文章的推理回放时间线,可精确追溯每条新闻对每个模型判断的影响。作者坦承样本量极小且尚未结算,项目以 MIT 协议开源,核心价值在于揭示上下文污染对 AI 决策的系统性干扰。
OpenAI 近日在 beta 阶段发布了 Decisions API,一位开发者没有用传统基准测试来评估它,而是设计了一场更有意思的实验:让三个主流决策模型同场预测未来事件,并与真实预测市场的赔率一较高下。
这个开源项目把 OpenAI 的 Decisions API、TypeSafe 的 Jev 和 Cloudflare 的 Clef(开源权重)放在同一套证据下,看它们如何从相同新闻中推理出截然不同的结论,再与 Polymarket、Kalshi 的实时价格对比。
为什么用预测市场当裁判
作者的出发点很直接:基准测试早已失效。几乎每个模型都可能在训练数据中见过标准答案,跑分无法反映真实的推理能力。
而预测未来则没有「答案键」——没人的训练数据里包含还未发生的事。更关键的是,预测市场提供了一个客观的参照系。正如作者所说:「Polymarket 和 Kalshi 的价格不是凭感觉,而是真金白银押上去的。」当三个 AI 模型读完新闻后的判断与数百万美元的真实资金相悖时,总有一方会被市场证明是错的,而我们正好可以看出是谁。
这个思路延续自作者早前的 Polyseer 项目(针对 Polymarket 投注的深度研究)。这次的升级在于:不是一个 AI 对抗市场,而是三个不同的「大脑」并排接受同样的证据,让人看清它们推理方式的差异。
**预测市场(prediction market)**是一种通过交易合约来聚合群体预测的机制。参与者对某一未来事件的结果买卖二元合约(如「是/否」),合约价格在 0 到 1 之间波动,反映市场对该事件发生概率的集体判断。Polymarket 基于区块链(Polygon 网络)运行,Kalshi 则是受美国 CFTC 监管的合规交易所。与民调或专家预测不同,预测市场的参与者需要用真实资金下注,这使得价格信号中包含了「皮肤在局中」的激励——预测错误会有实际经济损失,因此理论上能过滤掉纯粹的口头意见,更接近参与者的真实信念。学术研究(如 Arrow 等人的工作)已多次证明预测市场在选举、经济数据等领域的预测精度常优于传统方法。
「AI 对抗市场」其实是个伪命题
实验中最反直觉的发现是:这些模型一旦在上下文里看到市场价格,就会立刻抄答案。
作者用一个关于美联储降息的问题做了测试,结果非常说明问题:
| 上下文内容 | P(美联储降息) |
|---|---|
| 无市场价格 | 0.63 |
| 「市场定价 30%」 | 0.30 |
| 「市场定价 71%」 | 0.71 |
| 「市场定价 95%」 | 0.88 |
换句话说,只要模型看到了赔率,它的「预测」几乎就是对市场的复读。所谓的「AI vs 市场」如果不把价格藏起来,就只是在拿市场和它自己比较。
为了让对比有意义,整个数据管线会在模型读取任何内容之前,剥离所有引用赔率、博彩网站或 FedWatch 的来源。这是让实验站得住脚的核心设计。
这一现象在机器学习领域被称为上下文锚定(context anchoring)或锚定偏差(anchoring bias)。当模型的训练数据中包含大量「参考已知数值后给出判断」的范式时,模型会习得一种捷径:将上下文中的数字作为强先验,而非独立推理。预测市场的赔率对模型而言尤其是高置信度的信号——因为训练语料中关于市场价格的讨论往往伴随着「市场是有效的」这类叙述。这也解释了为什么即便模型被要求「独立判断」,只要上下文中存在赔率数字,其输出就会向该数字大幅靠拢。这与人类认知实验中的锚定效应高度一致:无论锚点是否与问题相关,被试的估计值都会显著偏向初始数字。
三个模型的「性格」截然不同
在隐藏市场价格后,三个模型展现出鲜明的推理风格差异。作者给出了一个「10 月美联储是否维持利率」问题的回放示例(当时 Polymarket 定价 83% 维持不变):
| 读到的文章 | Decisions | Jev | Clef |
|---|---|---|---|
| 尚无新闻 | 68 | 51 | 69 |
| 第3篇:嘉信「美联储 12-0 投票加息」 | 30 | 43 | 8 |
| 第5篇:一个 SEO 垃圾页面 | 18 | 38 | 63 |
| 第8篇(最终) | 17 | 30 | 19 |
从这组数据能清晰看出三者的差异:
- Decisions 最为果断,也最愿意与市场唱反调;
- Jev 几乎对任何信息都不太动摇,极为谨慎;
- Clef 反应最激烈,甚至被一个 SEO 垃圾页面带偏(从 8% 飙到 63%),但在下一篇真实文章出现后又自我修正了回来。
这种「逐篇文章改变主意」的回放机制,恰恰是这个项目最有价值的地方——你能精确看到哪条标题影响了哪个模型。
技术实现
整个系统的工作流程设计得相当清晰:
- 市场数据:从 Polymarket 公开 API 拉取交易量最高的开放问题,搜索覆盖 Polymarket 和 Kalshi;
- 证据收集:检索过去 60 天与问题相关的新闻,过滤掉所有引用赔率或博彩市场的内容,保留最相关的 8 篇文章;
- 决策:把同一批证据发给三个模型,各自返回 P(YES);
- 回放:对每个 k 值用文章 1 到 k 重新提问,生成每个模型的更新时间线。每个问题总共产生 27 次决策,整个过程约 2 秒完成;
- 看板:首页通过 cron 每 15 分钟刷新一次,所有用户共享,避免挂着标签页反复消耗 API 调用。
技术栈方面,项目基于 Next.js 16 + React 19 + Tailwind 4 搭建。OpenAI Decisions API 的请求结构非常简洁——只需传入证据和一个判断性问题,即可拿回概率。Clef 通过 Cloudflare Workers AI 调用,由于是开源权重,也可以用 Ollama 本地运行;Jev 则通过 Vercel AI Gateway 接入。新闻与证据检索使用 Valyu Search API,它能返回完整文章内容供决策模型使用。
实验的局限与开放问题
作者对实验的局限保持了难得的坦诚:样本量极小,且目前尚无市场结算(示例中的美联储问题要到 10 月 28 日才揭晓)。因此这只是一个实验,而非可用于交易的优势,更不构成任何投资建议。
项目代码已以 MIT 协议开源,托管版本也已上线。作者还抛出了一个值得社区思考的问题:当这些市场最终结算后,怎样才是跨模型评估校准度(calibration)最公平的方式?
这个项目的意义或许不在于预测本身的准确性,而在于它揭示了一个容易被忽视的事实——评估 AI 决策能力时,上下文污染(比如泄露市场价格)会让看似独立的判断沦为复读。这对任何想用大模型做预测或决策的人来说,都是一个实用的警示。
**校准度(calibration)**是评估概率预测质量的核心指标,指的是模型给出的预测概率与实际发生频率之间的一致性。一个校准良好的模型,其声称有 70% 把握的事件,在大量重复预测中应有约 70% 真正发生。常用的量化方式包括 Brier Score(预测概率与实际结果之差的均方)和校准曲线(reliability diagram)。对于本项目的挑战在于:预测市场的每个问题只结算一次,单次结果无法区分「预测准确」和「运气好」。要对三个模型做出统计上有意义的校准比较,需要在数百个已结算问题上积累数据,这也是作者所说「最公平的评估方式」尚无定论的根本原因。
相关推荐
用n8n搭建WhatsApp智能线索自动化:AI分级让商机不再流失
拆解一个基于n8n的WhatsApp线索自动化工作流:用AI把客户消息分为hot/warm/cold四级,自动应答并评分,仅在高价值线索出现时通知老板,帮助中小企业高效管理商机、节省人力。

Arabagent.ai:面向中东市场的托管式N8N自动化方案
Arabagent.ai 面向中东市场提供托管式 N8N 自动化服务,含私有工作空间、无限工作流执行、AI 自愈架构及阿拉伯语双语支持,兼顾开源可控性与 SaaS 便捷。

用 n8n 打造 Gmail→Google Sheets 自动化 CRM 实战教程
手把手教你用 n8n 搭建 Gmail 到 Google Sheets 的 AI 自动化 CRM:收到邮件自动触发,由 OpenAI 读取理解内容并提炼任务信息写入待办表格,含触发器、AI 智能体、提示词与 Sheets 工具的完整配置步骤。