开源分类模型对决:Qwen架构的Kev胜过Llama系Laya
开源客服分类模型Kev与Laya同台测评:Kev语境理解更强,Laya速度更快、内存更省。
本文记录了一场针对两款可本地部署的开源分类模型——基于Qwen 3.5的Kev与基于modern BERT large的Laya——的对比测评。两款模型在同一台机器上处理30条合成客服消息,任务是将消息路由到账单、技术支持、销售或需澄清四个标签之一。结果显示Kev在原始顺序下命中26/30,Laya命中12/30,差距主要集中在需要语境理解的边界案例,而非简单直接请求。Laya在速度(中位541ms vs 756ms)和内存占用(2.86GB vs 4.94GB)上更有优势。稳健性测试揭示两款模型均存在选项顺序敏感问题。作者强调开源模型的核心价值在于行为可本地检验与结论可复现,而非某个总分数字。
两款开源分类模型的同台竞技
随着某款闭源分类工具(视频中称为Jev)近期走红,海外博主开始寻找可本地部署的开源替代方案,并锁定了两个候选:基于Llama生态的 Laya 与基于 Qwen 3.5 的 Kev。这场测评并非要评出绝对优胜者,而是探究两款模型各自适合的应用场景,以及在同一套标准下的真实表现差异。
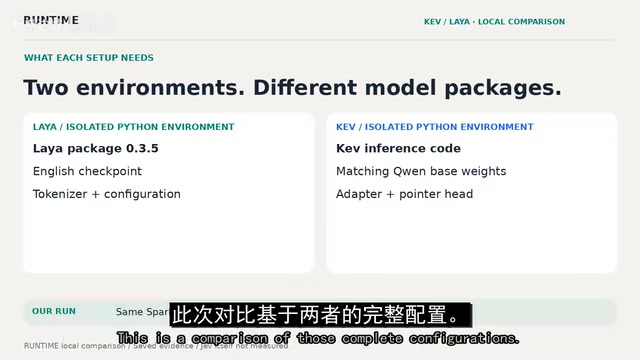
需要明确的是,Kev 与 Laya 都是独立的开源方案,测评对象是这两个本地模型本身,而非那款闭源的 Jev。两款模型都在同一台配备 Spark CPU、限定三线程的机器上单独运行,输入完全一致,以保证可比性。
架构差异:编码器 vs 指针头
两款模型的底层设计路线截然不同。Laya 的英文检查点以 modern BERT large 为起点,这是一个双向编码器,能同时利用上下文两侧信息构建词表示,再经过两层额外的 Transformer 精炼,最后由打分网络为每个选项打分。
Kev 则采用 Qwen 3.5 的 0.8B 基座模型 作为文本骨干,并将 LoRA 微调权重合并进去。它按单向顺序读取上下文,通过一个指针头(pointer head)将最终决策表示与每个候选答案的表示进行比对。
简言之,差异不仅在骨干网络,更在于「阅读方式」——一个双向编码,一个单向读出决策。两者最终都把分数转成概率并选出标签,在本次测试中都不逐字生成回复。博主特别提醒,这些结构图展示的是处理流程,并非模型内部实测的注意力分布。
modern BERT large 属于"仅编码器"(encoder-only)架构的代表。与GPT系列从左到右逐词生成的方式不同,BERT在预训练时使用"掩码语言模型"目标,迫使模型同时参考一个词左右两侧的所有上下文才能预测被遮住的词,因此天然擅长理解整句话的语义。"modern BERT"是对原始BERT的工程改良版,主要更新包括使用RoPE(旋转位置编码)替代绝对位置编码、改进归一化位置等,在保持双向编码优势的同时提升了训练效率和下游任务迁移能力。这类架构特别适合分类、命名实体识别等需要"读懂全句再判断"的任务,而非逐步生成长文本。
LoRA(Low-Rank Adaptation) 是一种参数高效微调技术。它不直接修改预训练模型的原始权重,而是在每个目标层旁边插入一对低秩矩阵(通常秩为4至64),只训练这两个小矩阵的参数。推理时将低秩矩阵的乘积叠加回原始权重,行为等价于全量微调,但可训练参数量减少了数十至数百倍。Kev将LoRA权重"合并进去"意味着推理时不需要额外的适配器加载逻辑,延迟与普通全量模型相当。
资源占用与响应速度
三项体量指标需要分开看待:
- 参数量:Laya 约 4.21 亿,Kev 约 7.53 亿
- 磁盘占用:Laya 打包约 846MB,Kev 含基座、适配器、指针头等约 1.82GB
- 峰值内存:CPU 运行时 Laya 峰值约 2.86GB,Kev 约 4.94GB
速度方面,博主对每个模型计时 90 次决策(30 条消息 × 3 种选项顺序)。Laya 的中位调用耗时 541 毫秒,Kev 为 756 毫秒;95 分位分别约为 607 与 802 毫秒。计时涵盖分词、推理与格式化,但不含模型加载和网络调用。由于软件栈不同且共享同一台机器,这些只是特定配置下的测量值,而非通用速度上限。
测试任务:客服工单路由
测评设计了一个具体场景:客户发来消息后,模型需从「账单、技术支持、销售、需澄清」四个目的地中选出一个标签,应用据此决定后续工作流。这类分类路由很实用,但博主强调,产出一个合法标签只是第一步,它仍可能是错误标签,而一个看似自信的概率数字并不能修正这一点。
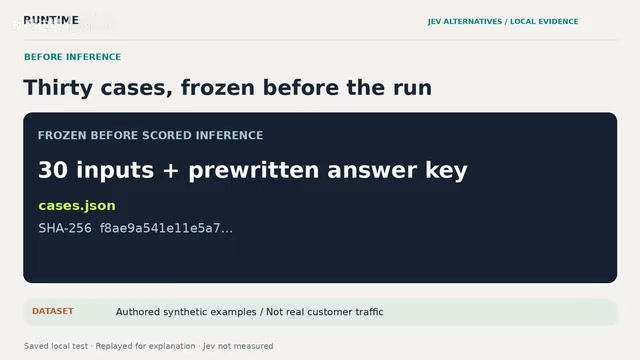
测试集包含 30 条消息:10 条直接请求、10 条按政策应「请求澄清」的情况,以及 10 条边界案例(含否定表述、已解决的问题、明示的优先级,以及藏在消息里的指令)。输入与答案在评分前已冻结。博主坦言这些是合成样本,不代表真实客户流量,也非行业基准,目的是让模型行为——尤其是棘手案例——变得可检验。
关键案例:语境理解见分晓
简单案例中两者表现接近。比如一笔续费被重复扣款要求退款,两款模型都正确选择「账单」,Laya 给出约 88% 的置信度,Kev 约 73%——但更高的数字只说明它对这个特定样本的评分,不代表 Laya 整体更可靠。
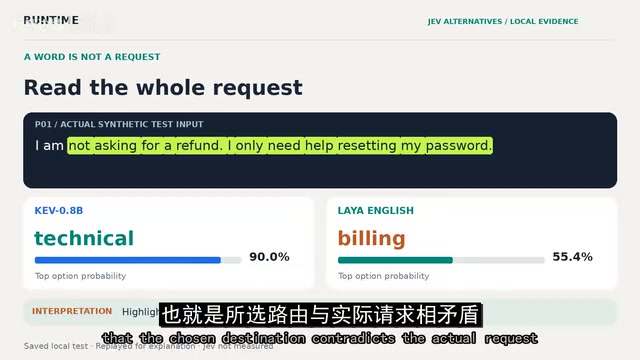
真正拉开差距的是需要语境理解的案例。当客户明确表示不要退款、只需重置密码时,Kev 正确选择技术支持,Laya 却选了账单——仅因为出现了账单相关词汇。另一条消息提到登录问题但说明「昨天已修复」,实际诉求是更正发票,Kev 选账单,Laya 选技术支持。
博主也如实呈现了两者的共同失败:某条消息中所有导出都生成空文件,正确答案是技术支持,但 Kev 选了「澄清」、Laya 选了账单。这种坦诚避免了「完美赢家」的叙事——更高的总分不会让个别错误消失。
总体成绩与选项顺序的隐患
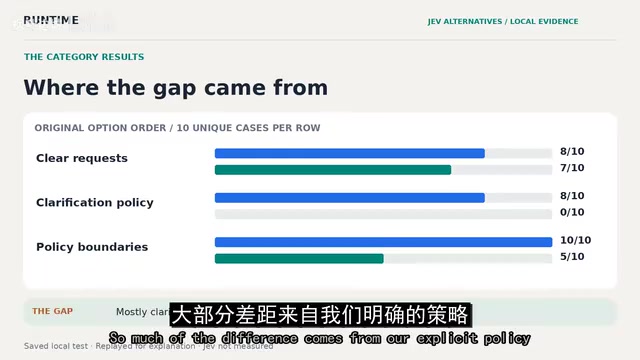
在原始选项顺序下,Kev 命中 26/30,Laya 命中 12/30。拆解来看:10 条清晰请求上 Kev 8 分、Laya 7 分,差距不大;澄清案例 8:0;边界案例 10:5。可见大部分差距来自政策相关和需语境解读的消息,不能据此断言 Laya 无法处理普通路由。
博主还做了一项重要的稳健性测试:把每条消息的四个选项顺序打乱三次。结果显示 Kev 有 4 条消息、Laya 有 5 条会随选项顺序改变结果。三种顺序合计,Kev 命中 74/90,Laya 命中 33/90。博主特别提醒不要把这 90 次当作 90 个独立测试题,那会夸大证据强度。
分类模型对候选答案顺序敏感的现象被称为位置偏差(position bias),在大语言模型评估领域已有系统性记录。单向自回归模型(如Kev的Qwen基座)在生成或评分时,靠近序列末尾的候选项有时会获得更高权重,因为模型的注意力机制在因果掩码约束下只能"向后看"。对于双向编码器(如Laya的BERT基座),理论上受此影响较小,但实际表现仍可能受到选项在输入中排列方式的影响。这一现象提示:在正式部署前,应当用多种选项排列顺序重复测试,并观察标签是否保持一致——博主在本次测评中正是通过三种顺序打乱来量化这种不稳定性,这是评估分类模型稳健性的重要实践。
结论:本地可检验才是价值所在
对于这个政策密集型的试点任务,Kev 是更强的起点;Laya 更快、内存占用更低,但在这套规则下还需改进才能被信任。博主反复强调,任何结果都无法替代在你应用真实消息上的测试。
开源分类模型真正有意思的地方,不是能返回一个标签,而是你可以本地运行、检查行为、并自行判断这个决策是否有用。这 30 个透明案例教会了具体的东西,也留下了改进配置、扩充数据集乃至推翻结论的空间——这正是开源方案可复现、可质疑的核心价值。
相关推荐
多轮对话攻破AI客服:没有恶意消息,护栏为何失效?
一次针对AI客服代理的红队测试发现:即使没有任何单条恶意消息,通过长达数十轮的缓慢对话,模型也会逐步偏离安全策略,而护栏从未触发。本文解析多轮对话越狱的机制与防御思路。
荷兰政府基于NixOS打造微软替代方案DAWO
荷兰政府推出基于NixOS的开源项目DAWO,试图替代微软办公与云生态,推进数字主权。本文解析其技术选型逻辑、摆脱供应商锁定的动因,以及社区对政府开源迁移的争议。
Agentic CUDA Kernel优化器:AI自动调优的新尝试
一款名为Agentic CUDA Kernel Optimizer的工具在Hacker News亮相,尝试用AI智能体自动优化CUDA内核性能。本文解析其技术思路、Agent在Kernel调优中的价值及现状观察。