开源工具aobs:阻止AI智能体重复执行高风险操作

开源工具 aobs 用真实业务记录校验高风险智能体工具调用,阻断重复副作用并引入 CI 策略门禁。
Reddit 上一位开发者发布了开源工具 aobs(Apache-2.0,Python),针对 AI 智能体在高风险工具(退款、发邮件、删除记录、部署等)上自动重试导致重复副作用的问题。核心思路是拦截高风险工具调用,用真实业务记录而非模型参数做校验,超过阈值要求人工审批,并保证跨重试与跨进程重启不产生重复副作用。项目支持 OpenAI 兼容客户端、Anthropic、LangChain/LangGraph,轨迹可导出到 OpenTelemetry,并提供 TOML 策略驱动的 CI 门禁(GitHub Action 输出 PASS/FAIL 与证据)。作者标注项目处于 Alpha 阶段,落地成本主要在于与现有订单、账务系统的对接改造。
AI智能体在工具调用失败时自动重试,通常无伤大雅——但如果它重试的是退款、发邮件或删除记录,问题就大了。Reddit上一位开发者发布了开源工具 aobs(Apache-2.0,Python),专门解决智能体在高风险工具上的重复执行与审批失控问题,并顺带补上了可观测性与CI门禁。
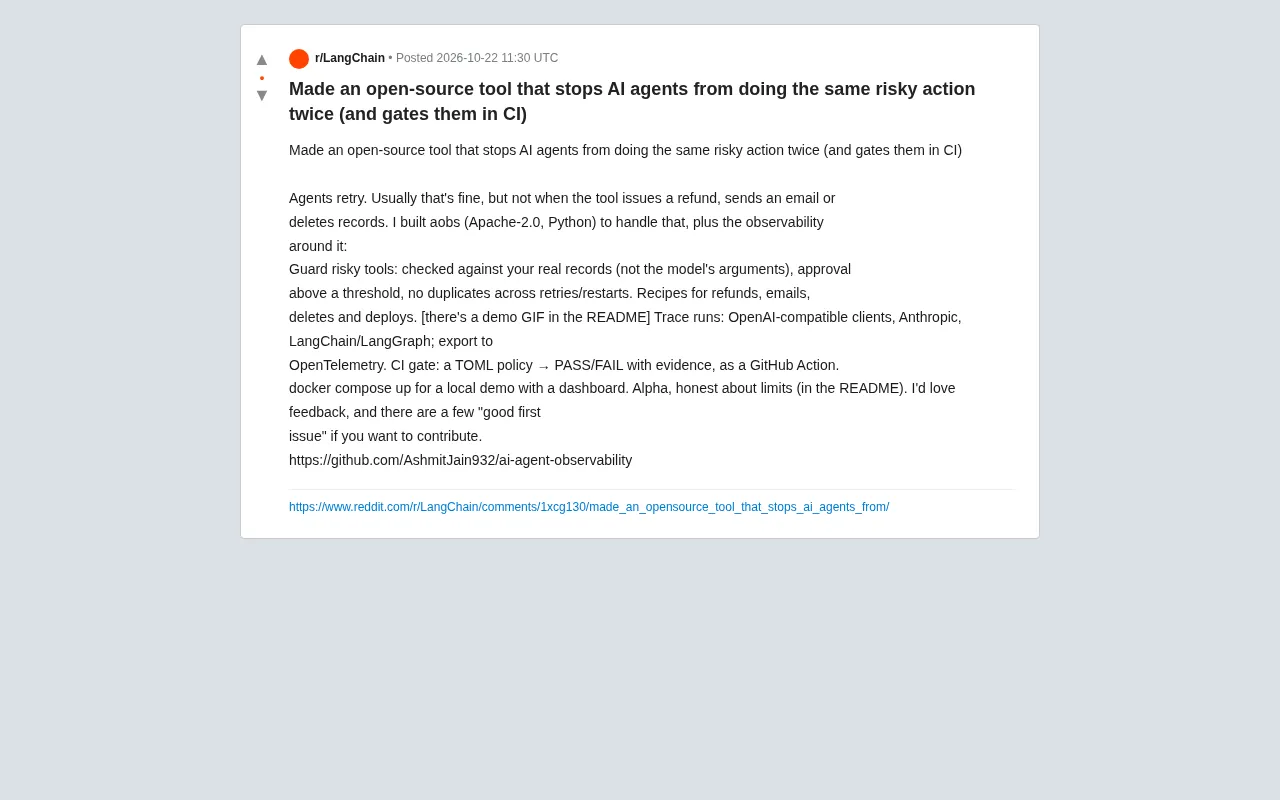
据该帖介绍,aobs 的核心思路是:对高风险工具调用进行拦截,用真实业务记录(而非模型自己给出的参数)做校验,超过阈值则要求人工审批,并保证跨重试、跨进程重启都不会产生重复副作用。项目还提供了退款、邮件、删除、部署等场景的"配方",README 中附有演示 GIF。
为什么智能体重试会变成事故
智能体框架普遍把"工具调用失败"当作可恢复错误,于是自动重试。这在查询类工具上没问题,但在有副作用的操作上,重试就等于重复下单、重复退款、重复发信。更棘手的是,模型给出的参数可能已经"漂移"——它会把一次退款重试写成两笔不同金额的请求,单靠参数去重并不靠谱。
aobs 的做法是把判断依据从模型参数切换到真实记录:检查该操作是否已在业务系统中真实发生过,从而识别并阻断重复。这个设计方向值得肯定,因为它承认了模型输出的不可信性,把安全边界放在了系统层而非提示词层。
幂等性(Idempotency) 是分布式系统中的一个基本概念:同一个操作执行一次和执行多次,对系统状态的影响相同。例如,查询操作天然幂等,而“账户余额加 100 元”就不幂等。实现幂等的常见手段包括幂等键(idempotency key)、唯一约束、状态机去重以及服务端记录操作凭证。在智能体场景中,工具调用天然缺乏幂等保证,因此需要在系统层为有副作用的操作补充幂等语义。aobs 强调“跨重试、跨进程重启都不会产生重复副作用”,本质上就是在为工具调用提供一种幂等保障机制。理解这一点,有助于评估该工具与业务系统对接时需要哪些前提条件。
工具链覆盖与可观测性
项目在集成面上做了不少工作:支持 OpenAI 兼容客户端、Anthropic,以及 LangChain / LangGraph;运行轨迹可导出到 OpenTelemetry,方便接入既有的监控体系。此外还有 docker compose up 启动的本地演示,带一个仪表盘,降低了上手门槛。
对于已经在用 OTel 的团队来说,这种"不过度造轮子"的接入方式比较友好——安全拦截和链路追踪共用一套数据通路,排查问题时不必在两个系统间来回切换。
OpenTelemetry(OTel) 是云原生计算基金会(CNCF)下的开源可观测性标准,统一了链路追踪(traces)、指标(metrics)和日志(logs)的数据模型与采集协议。它本身不是监控后端,而是通过 SDK 和 Collector 将遥测数据导出到 Jaeger、Prometheus、Datadog 等系统。对于智能体应用而言,OTel 的价值在于把一次工具调用链路(模型推理→参数生成→工具执行→结果回写)纳入既有监控体系,从而定位失败点与延迟瓶颈。aobs 选择导出 OTel 轨迹而非自建仪表盘,意味着它更倾向于融入现有运维基础设施,而不是另起一套孤立的观测体系。
CI门禁:把策略检查左移
除了运行时防护,aobs 还提供 CI 门禁:用 TOML 定义策略,输出 PASS/FAIL 及对应证据,并以 GitHub Action 的形式运行。这意味着智能体行为的合规检查可以进入代码评审流程,而不是等到线上出事再回溯。
把策略文件化、把判定结果作为可审计证据,是这类工具走向工程化的关键一步。对受监管行业或内部有严格变更流程的团队,这一层的价值可能比运行时拦截更高。
策略即代码(Policy as Code) 指将合规与安全策略以机器可读的配置文件(如 TOML、YAML、Rego)形式纳入版本控制,并交由自动化流程执行和审计。与传统人工检查相比,它的优势在于判定结果可复现、可追溯,并且能够嵌入 CI 流水线,在代码合并前就拦截违规变更。aobs 用 TOML 定义智能体工具调用的策略,并输出 PASS/FAIL 及证据,是这一理念在 AI 智能体治理上的具体应用。需要注意的是,策略即代码的有效性高度依赖策略本身的完备性和维护频率,否则容易流于形式。
需要理性看待的局限
作者明确标注项目处于 Alpha 阶段,并在 README 中如实说明了限制。对一个个人开源项目而言,这种坦诚是加分项,但也提示使用者:短期内不宜直接用于生产环境的资金类操作。此外,去重判断依赖对真实业务记录的接入,这意味着落地成本主要不在工具本身,而在与现有订单、账务系统的对接改造上。
项目还留出了若干 "good first issue",欢迎社区参与。
小结
智能体的可靠性问题正在从"能不能做对"转向"做错了会不会造成损失"。aobs 代表了一类务实的思路:不追求让模型永不犯错,而是在系统层设置护栏——真实记录校验、阈值审批、幂等保证、OTel 追踪与 CI 策略门禁。这个组合是否好用,取决于它与业务系统的贴合程度,但方向值得关注。
项目地址:https://github.com/AshmitJain932/ai-agent-observability
相关推荐

前端转AI Agent开发:一线架构师解析职业路径与红利
一线AI架构师解析前端转AI Agent开发的行业变化与落地路径:纯前端岗位为何消失、Agent+全栈为何成为招聘主流,以及Agent开发工程师、FDE、远程接单三条转型路线和对应学习策略。

AI Agent开发课程怎么选?五条避坑指南
机械转行开发者踩坑两年总结的AI Agent开发课程筛选清单:完整交付链路、可写进简历的项目、真实开发视角、更新频率、陪跑反馈五个维度,附具体判断方法和避坑要点。

扣子(Coze)智能体搭建入门:零代码开发AI Agent实战指南
扣子(Coze)是字节跳动推出的一站式AI应用开发平台,支持零代码拖拽搭建AI智能体。本文基于B站教程梳理扣子的核心概念、三大优势、国内版与国际版差异,以及智能体与应用的区别,帮助初学者快速入门AI Agent开发。