开源决策模型CLM挑战闭源Jev:延迟提速13倍

CLM是基于Qwen3-8B的开源投影头,以极低延迟和可微调性挑战闭源AI Agent决策模型Jev
CLM是一个约75MB的轻量级开源项目,通过在Qwen3-8B主干上叠加投影头,完整复刻了闭源模型Jev的三种决策原语(Choice/Noul/Score),并实现API级别的无缝替换。其核心优势在于:通过解耦状态头与动作头并缓存动作嵌入,在高频Agent场景下速度达到Jev的4至13倍;开放权重允许基于领域数据微调,在Terminal-Bench 2.1和DeepSWE编码验证基准上达到SOTA水准。但CLM-v0.1-8B当前在零样本广域知识、64K长上下文支持以及绝对概率校准三方面仍弱于Jev。综合来看,固定动作空间、调用频繁且有领域数据的场景适合CLM,需要广域泛化与长上下文的通用场景Jev仍有优势。
在AI Agent决策与验证领域,一个名为CLM(Contrastive Language Models)的开源项目正引发讨论。它定位为TypeSafe AI旗下闭源模型Jev的可自托管替代方案,基于Qwen3-8B构建了一套新的投影头(projection head)。从Reddit社区r/LocalLLaMA的讨论来看,CLM在保持功能对等的同时,在延迟与可微调性上展现出明显优势——但它并非全面碾压,Jev在若干关键维度仍占上风。
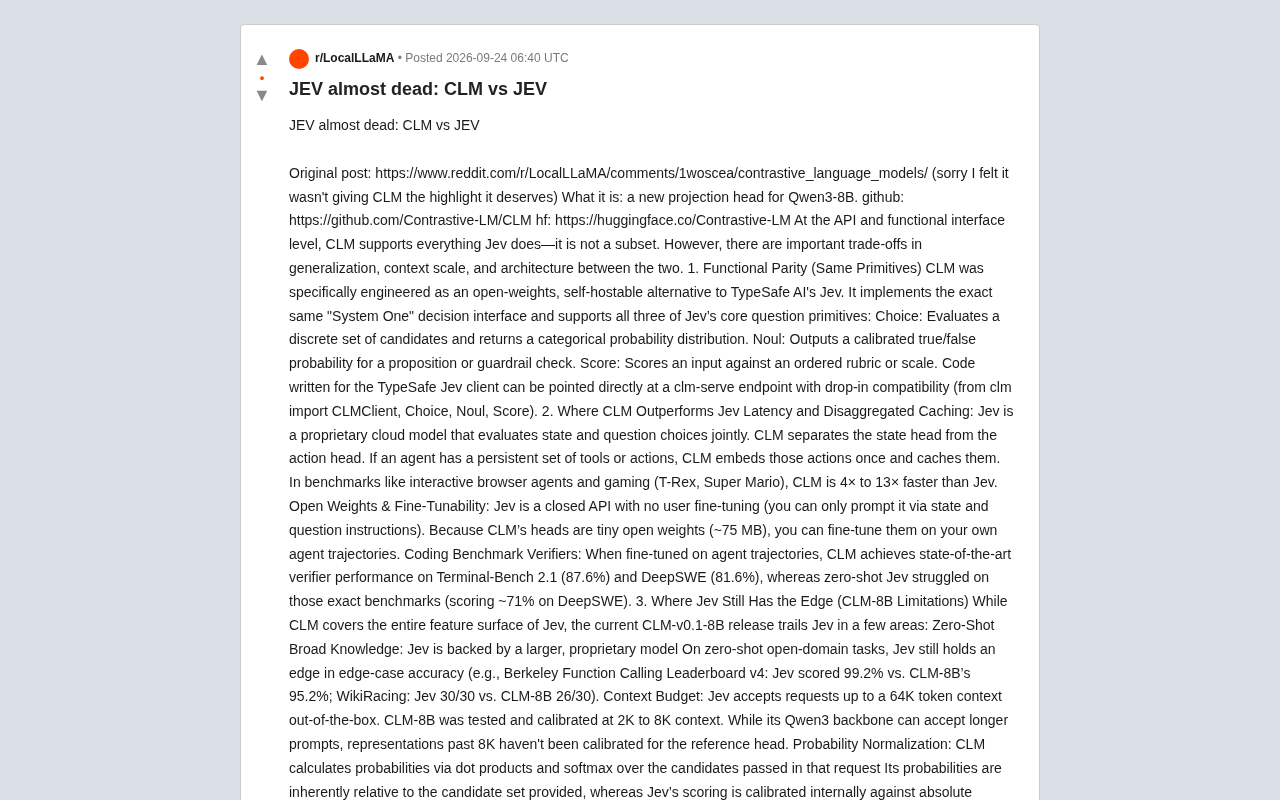
CLM是什么:Jev的开源镜像
CLM并非一个从零训练的大模型,而是在Qwen3-8B主干之上叠加的一组轻量级投影头,总大小仅约75MB。它的设计目标非常明确:做一个开放权重、可本地部署的Jev替代品。
项目在API与功能接口层面完整复刻了Jev的"System One"决策接口,支持三种核心问题原语:
- Choice:对一组离散候选进行评估,返回类别概率分布;
- Noul:针对某个命题或护栏检查(guardrail),输出经过校准的真/假概率;
- Score:按照有序评分标准或量表对输入进行打分。
值得强调的是,CLM声称提供的是Jev的完整原语集,而非子集。原本为TypeSafe Jev客户端编写的代码,可以直接指向clm-serve端点实现"drop-in"无缝替换(from clm import CLMClient, Choice, Noul, Score)。这种兼容性设计降低了迁移门槛,对已经构建在Jev接口上的Agent系统尤其友好。
**投影头(Projection Head)**是一种轻量级的神经网络模块,通常由若干全连接层构成,接在预训练主干模型(backbone)的顶部。其核心作用是将主干模型输出的高维通用表示(embedding)映射到特定任务所需的低维空间或概率分布。由于投影头本身参数量极少(CLM仅约75MB),训练和微调成本远低于对整个大模型进行全量微调。这种"冻结主干 + 微调投影头"的架构范式,使得CLM既能继承Qwen3-8B的语言理解能力,又能以极低代价完成面向决策验证任务的专项适配——这也是它体积小却声称功能完备的根本原因。
CLM的优势:低延迟、可微调、编码验证SOTA
CLM的核心竞争力集中在三个方面。
延迟与解耦缓存
Jev作为专有云模型,会将状态(state)与问题候选联合评估。CLM则把状态头(state head)与动作头(action head)拆开处理。对于拥有持久工具集或固定动作空间的Agent而言,CLM只需将这些动作嵌入一次并缓存复用。
在交互式浏览器Agent以及游戏场景(如T-Rex、Super Mario)的基准测试中,CLM的速度达到Jev的4至13倍。这种架构上的解耦,本质上是把重复计算前置并缓存,对高频调用的Agent循环意义重大。
开放权重与可微调性
Jev是封闭API,用户无法微调,只能通过状态和问题指令进行prompt。而CLM的投影头是体量极小的开放权重,用户可以基于自己的Agent轨迹(trajectories)进行微调。这为特定领域的深度定制打开了空间。
编码基准验证器表现
经过Agent轨迹微调后,CLM在编码验证任务上取得了SOTA级别的表现:Terminal-Bench 2.1达到87.6%,DeepSWE达到81.6%。相比之下,零样本的Jev在这些基准上表现吃力——在DeepSWE上仅约71%。这说明在可获取领域数据的场景下,微调带来的收益足以反超一个更大的闭源模型。
Terminal-Bench和DeepSWE是当前AI Agent编码能力评估领域的两个代表性基准。Terminal-Bench侧重于在真实终端环境中完成命令行操作与系统级任务,考察Agent对工具调用、错误恢复和多步执行的综合能力;DeepSWE则专注于软件工程场景,要求Agent理解代码库上下文并完成实际的代码修改或调试任务。两者的共同特点是具有可程序化验证的确定性结果,因此非常适合用来衡量"验证器"类模型的准确性——即判断某段代码或某个执行步骤是否正确的能力,而非生成代码的能力。这也解释了为什么CLM这类专注于结构化判断的投影头模型,在这两个基准上能够与乃至超过通用大模型。
Jev的护城河:泛化、上下文与概率校准
尽管CLM覆盖了Jev的全部功能面,当前的CLM-v0.1-8B版本在几个维度仍落后于Jev,这些差距值得使用者在选型前认真权衡。
零样本广域知识
Jev背后是更大的专有模型,在零样本、开放域任务上仍保有边缘案例(edge-case)的准确性优势。具体数据显示:在Berkeley Function Calling Leaderboard v4上,Jev得分99.2%,CLM-8B为95.2%;在WikiRacing任务上,Jev满分30/30,CLM-8B为26/30。差距不大,但在对准确率高度敏感的场景中依然关键。
上下文预算
Jev开箱即支持最高64K token的上下文。而CLM-8B仅在2K到8K的上下文范围内经过测试和校准。虽然其Qwen3主干本身可以接受更长的prompt,但超过8K后的表示尚未针对参考头进行校准,这意味着长上下文场景下CLM的可靠性存疑。
概率归一化方式
CLM通过点积(dot product)加softmax在请求传入的候选集上计算概率,因此其概率本质上是相对于所提供候选集的相对值。而Jev的评分是内部针对绝对标准进行校准的。这一差异会影响到需要跨请求比较绝对概率的应用逻辑。
这一差异在实际系统设计中具有重要影响。以点积加softmax的相对概率为例:若Agent在请求A中提供候选集{动作1, 动作2},在请求B中提供{动作1, 动作2, 动作3},即使两次请求的语义输入完全相同,动作1在两次请求中得到的概率值也会不同,因为softmax会将概率"重新分配"到当前候选集上。这意味着CLM的输出只能用于同一请求内的候选排序,而不能跨请求进行绝对比较(例如"本次最优动作的置信度是否高于上一次最优动作")。对于需要维护全局动作质量评估、或跨时间步比较决策置信度的Agent架构,这是一个值得提前规避的设计约束。
选型建议:何时选CLM,何时留Jev
综合来看,如果你担心用CLM替换Jev会损失API功能——答案是不会。你能获得完整的原语集(Choice、Noul、Score),外加巨大的延迟收益和零API成本。
代价在于:相比TypeSafe的托管服务,你会在部分小众的域外(out-of-domain)任务上牺牲一些零样本泛化能力,并受限于当前的上下文校准范围。
换句话说,对于动作空间固定、调用频繁、且能提供领域微调数据的Agent系统(如浏览器自动化、编码验证),CLM是极具吸引力的自托管选择;而对于需要广域知识、长上下文和绝对概率校准的通用场景,Jev的闭源优势短期内仍难被完全取代。作为一个v0.1版本,CLM的后续迭代——尤其是上下文校准范围的扩展——值得持续关注。
需要说明的是,本文基于Reddit社区的单一讨论帖及项目自述数据,相关基准结果尚未经过独立第三方复现,读者在实际选型时应以自身场景的实测为准。
相关推荐

Opus 5.5实测:一个Skill把PDF变成交互式动画电子书
开发者基于 Claude Opus 5.5 打造开源 Skill「Papermorph」,通过 PDF→规划→分镜→旁白→动画测验的流水线,把静态 PDF 自动转化为带交互测验的动画网页电子书,且暂未使用图像模型。本文拆解其工作流与技术亮点。

Perplexity押注垂直整合:Vera芯片替代x86背后的Agent基建野心
Perplexity宣布垂直整合其智能体基础设施,自建沙箱并押注Vera架构替代x86,开始部署Perplexity Computer。本文解析这一战略背后的技术逻辑与行业意义。

Extra Big Ass Intelligence:一场对AI炒作的幽默反讽
Extra Big Ass Intelligence是一个在Hacker News走红的恶搞项目,用幽默反讽调侃AI行业的过度炒作与命名通胀,引发技术社区对AI营销泡沫的集体反思。