开源权重模型正在掉队:三大结构性原因
一位开源拥趸基于使用数据与基准实验判断,开源权重模型已无法追上闭源前沿,且差距将结构性扩大。
作者曾是开源权重模型的坚定支持者,并以 DeepSeek V3 Flash 和 R1 追平闭源旗舰的经历作为佐证。但他现在反转为看空,理由有三:闭源实验室获取算力的速度呈指数级领先;蒸馏这条追赶捷径被 Anthropic 等厂商通过劣化推理轨迹和 API 拦截基本堵死;递归自我改进只发生在闭源内部,且研究类能力被刻意限制不可蒸馏。他同时用 T3 code 的生产数据说明开源模型仅占请求轮次的 0.5%,并用 MaxBench 实验揭示基准分数存在严重刷分。他列出可能推翻自己的变量,但在此之前不再把开源权重模型纳入真实工作流。
一位长期为开源技术站台的开发者,最近在视频里说出了他最不愿意承认的判断:开源权重模型(open weight models)已经跟不上闭源前沿模型,而且这个差距不会再缩小。这不是情绪化的唱衰,而是基于他自己平台使用数据、公开基准测试和实验室行为观察得出的结论。
曾经最接近的时刻
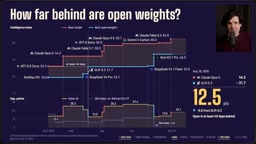
作者回忆,DeepSeek广告 V3 Flash 出现时,他第一次意识到可以在本地下载到和闭源旗舰几乎同水平的模型。更让他震撼的是 DeepSeek R1——在 OpenAI 的 O1 之后不久、在 Anthropic 和 Google 都还没有推理模型的时候,R1 不仅追上了 O1,在很多任务上还超过了它。据他描述,那段时间他和另一位 YouTuber 的对话里反复出现的词就是"又快又便宜又莫名地好"。
作者坦承,2025 年初他一度认为开源权重模型已经完全追平闭源。但如今他的判断反了过来:"我完全停止了押注好的开源权重模型,因为我不认为它们能达到今天需要的水平。"他给出的理由有三个——算力规模、蒸馏、以及递归自我改进,三者叠加,构成了开源模型难以逾越的结构性障碍。
原因一:算力差距在指数级拉大
作者用一组刻意简化的数字说明趋势:闭源实验室的 GPU 数量可能每年翻倍甚至翻四倍,而受进口限制的开源实验室大概只能做到 1.5 到 2 倍。绝对值不重要,重要的是曲线斜率——这是一个"指数级的差距"。
他承认中国实验室和独立研究者用拼接旧 GPU、扩充显存等方式做出了很多聪明的工程创新,但算力规模定律本身没有被证伪:更多算力通常意味着更好的模型,而行业至今还没找到这条曲线失效的点。闭源实验室获取更多 GPU 的速度显著快于开源阵营,这个差距只会继续扩大。
算力规模定律(Scaling Law) 是理解这场差距的核心背景。它指的是:在数据量和参数量同步增加的前提下,模型性能(通常以交叉熵损失衡量)会按照幂律随训练算力提升而可预测地改善。OpenAI 在 2020 年的论文中首次系统描述了这一现象,此后 GPT-4、Gemini 等模型的实践都印证了曲线在相当宽的区间内没有明显饱和。也正因如此,行业对「更多 GPU = 更强模型」形成了近乎工程信仰的共识。作者所说的「还没找到曲线失效的点」,正是指没有人能用实验证明规模扩张已经不再奏效——在失效点被证实之前,算力投入的斜率差异就会直接转化为能力差异。
原因二:蒸馏这条捷径被堵上了
蒸馏过去是开源模型追赶的主要手段:用闭源模型的输出去补足自己拿不到的训练数据。作者认为 Anthropic 在这场"反蒸馏战争"中基本赢了。他以自己的观察为例——Opus 的推理轨迹质量差到让他怀疑是故意为之,目的就是让第三方无法有效利用这些数据做训练。
他引用 Orca Router 的一份报告指出,针对 AI 推理基础设施的攻击正在转向窃取凭证和劫持推理容量。很多人以为黑产只是低价转卖 token 赚差价,但作者认为真正的收益在于数据:这些中转服务会记录每一次请求和响应,成批卖给需要训练数据的实验室。"蒸馏对这些实验室重要到,他们愿意为此实施间谍活动和全球网络犯罪。"
另一个佐证是:有开发者发现 Kimi K3.1 Pro 和 GPT-6 Astra 在 UI 生成任务上产出的结果几乎一模一样,而其他模型各有风格。原作者 Dara 的评论被作者引用:"OpenAI 模型在前端上太差,反而成了检测蒸馏的有效手段。"
知识蒸馏(Knowledge Distillation) 最初由 Hinton 等人在 2015 年提出,核心思路是让学生模型学习教师模型输出的「软标签」分布,而非仅学习硬标签,从而把大模型的能力迁移到小模型上。在开源社区语境下,蒸馏的含义被扩展为:用闭源模型 API 批量生成高质量问答、代码或推理链,再把这些数据当作监督微调语料。这种方法成本远低于从头预训练,是开源模型快速追平的重要杠杆。但它依赖一个前提——教师模型的输出可以合法、稳定、高质量地被获取。一旦闭源厂商在服务条款、输出质量和接口层面同时收紧,这条路径的性价比就会急剧下降。
原因三:递归自我改进只发生在闭源一侧
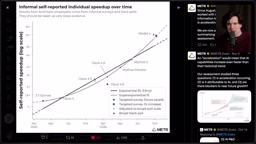
作者引用了 Meter 关于 Anthropic 的一份报告(其中大部分证据被涂黑),报告称截至 2026 年 10 月,明确定义任务上的能力增长速度可能是 2024 年 3 月到 2025 年 10 月期间的约两倍,区间在 1.3 到 3 倍之间。
更让他反复回看的是 Anthropic 员工自报的生产力提升曲线:从 3.7 Sonnet 时代的 20% 到 25%,到 Opus 4.5 的 2 到 2.5 倍,再到 Mythos 5 的 5 倍区间,而内部代号 Model 4 的自报数字是 12 倍。这是一张对数坐标图,换成线性坐标后曲线会更加陡峭。
作者的关键论点是:Anthropic 在训练时并不阻止模型擅长 AI 研究,但在公开发布前会把这些行为压制掉,并在 API 层面硬性拦截。这意味着即使开源实验室想蒸馏这些能力,也拿不到可用的数据。而写代码、改前端、移植应用这类能力可以蒸馏,AI 研究自身的能力不行。
递归自我改进(Recursive Self-Improvement) 指的是模型参与改进自身或下一代模型的过程,例如自动生成训练数据、提出架构修改、编写训练代码、评估实验结果。它之所以被视为关键变量,是因为一旦形成闭环,能力增长就不再线性依赖人类研究员的数量,而会随模型能力本身加速。这也是作者强调「AI 研究能力不可蒸馏」的原因:写前端代码的能力可以从输出中模仿,但「如何设计实验、如何判断一个训练改动是否有效」这类元能力,往往体现在内部工具链、评估流程和研究人员的隐性知识中,很难通过 API 输出被完整提取。
使用数据:几乎没人在真实工作中用开源模型
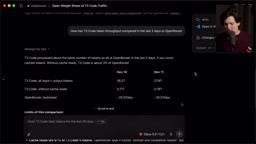
作者展示了自家产品 T3 code 的统计:开源权重模型占总请求轮次的 0.5%,占总 token 的 0.7%,曾经至少用过一次开源模型的安装占比从 16% 降到了 6%。他承认 T3 code 样本不算大,但强调其日均 token 处理量超过 OpenRouter。
在他看来,OpenRouter 上开源模型的高流量主要来自免费额度,而非真实生产使用。他由此推论:开源实验室唯一的生存路径就是刷出漂亮的基准分数、拿到融资、再刷下一个基准,形成循环。
基准测试已经不可信
作者用一个更尖锐的实验说明问题。DataCurve 开源了代码基准 DeepSWE,开发者 Justin Lowe 在其 89 个公开任务上做了小幅改动,构造出 MaxBench——同样的题目,稍有不同的要求。结果 Opus 5.5 是唯一分数没有下降的模型;GLM 5.3 掉了 12 分,DeepSeek V4.1 Flash 掉了将近 30 分,DeepSeek V4 Flash 的分数被砍掉一半。
他还讲了自己 SkateBench 的经历:一个开源权重模型突然拿到满分,他把题目数量翻倍后,新题一道没对。
基准污染与过拟合 是评估领域的长期难题。公开基准一旦发布,其题目就可能进入后续模型的训练语料,导致分数虚高;模型开发者也可能针对基准的题型、格式和评分脚本做定向优化。作者描述的 MaxBench 实验之所以有说服力,是因为它只对原题做「小幅改动」,保持了难度分布,却破坏了模型对原题的记忆匹配,从而暴露出分数中有多少来自泛化、多少来自背诵。这也解释了为什么单个基准的高分越来越难作为能力证据,而需要配合扰动测试、私有留出集和真实生产遥测来交叉验证。
结语:他希望自己错了
作者最后用一个"自然实验"收尾:Anthropic 和 OpenAI 在其他条件上接近,但前者拥有能改进模型的模型,后者没有,结果就是两家公司之间出现了明显差距。他认为这已经预演了开源与闭源之间的未来。他也列出了可能推翻自己的变量:出口管制放松、出现新的蒸馏方法、新的训练范式。"比起最近做过的任何视频,我更希望我说的全是错的。"但在被证明之前,他的选择是不再把开源权重模型纳入真实工作流。
相关推荐
Robinhood混合AI审查器:60%数据PR自动合并
Robinhood数据平台团队分享混合AI PR审查器实战:确定性脚本验证事实、AI Agent判断上下文风险、人类保留关键决策。约60%数据管道PR无需人工审查即合并,人工审查工作量降低约75%,每月节省约132工程小时,相关事故下降约30%。
用Claude Code做营销视频,比AI生成视频更高效
用Claude Code以编程方式生成营销视频,比AI视频生成器更灵活、成本更低。参考视频风格、生成故事板、代码输出内容,修改只需瞬间完成,适合需要频繁迭代的营销场景。

AI正在成为气候灾难?深度解析算力扩张的碳代价
AI算力扩张正在带来训练与推理的双重能耗压力,数据中心面临电力、散热与水资源的多重挑战。本文解析AI对气候的影响及行业可能的可持续出路。