开源Saluki 27B:7.9GB跑满96%性能的端侧Agent旗舰

Saluki 27B将540亿参数模型压缩至7.9GB,在消费级设备上保留96%性能并在工具调用上反超原版。
Underdog AI开源的Saluki 27B基于阿里Qwen3 27B,通过量化与蒸馏技术将54GB模型压缩至7.89GB,体积缩减至原版七分之一,却在九项权威基准中平均保留了96%的性能。更令人意外的是,经过专项调优的工具调用能力实现了对全尺寸原版的反超:Underdog Bench得88分(原版84分),并行调用成功率提升约20%。代码修复与指令遵循方面,模型在SWE-Bench解决30/50个真实Issue,IFEval得分93.5分超越原版。架构上采用热插拔设计,视觉能力以0.9GB插件形式按需加载,配合GGUF格式实现一行命令本地部署,Apache 2.0协议无商用门槛,为端侧AI Agent普惠化提供了可行路径。
把27B塞进7.9GB:一次工程层面的极限压缩
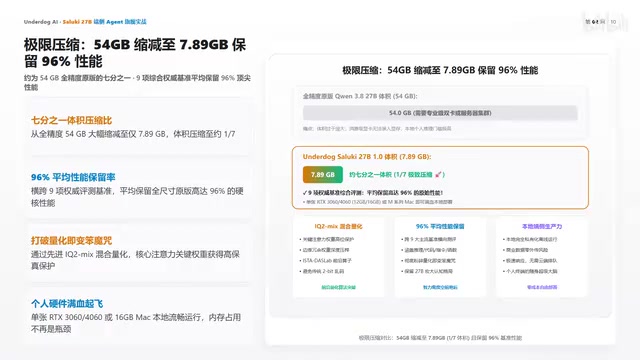
Underdog AI团队近日发布并全量开源了端侧大模型 Saluki 27B 1.0。它基于阿里巴巴开源的 Qwen3 27B 深度打造,通过量化与蒸馏技术,将原本高达54GB的全精度模型压缩至仅 7.89GB,体积缩减到约原版的七分之一。
这个数字意味着什么?在过去,27B级别的模型往往需要专业显卡甚至多卡部署才能流畅运行。而7.9GB的体量,让一张消费级显卡乃至普通笔记本电脑都能承载顶级模型的智力输出。全系列采用 Apache 2.0 协议开源,无任何商用门槛,这对希望将大模型落地到本地设备的开发者而言,是一个值得关注的信号。
真正令人意外的不是压缩本身,而是压缩后的性能表现。官方在九项综合权威基准测试中实测,Saluki 平均保留了原版高达 96% 的性能——这打破了业界长期流行的"量化必然导致智力断崖式暴跌"的刻板印象。
量化(Quantization) 是指将模型权重从高精度浮点数(如FP32或BF16)压缩为低比特整数(如INT8、INT4甚至更低),从而大幅缩减存储与显存占用。以Saluki为例,从54GB压缩到7.9GB,大致对应将每个权重从16位降至约2-3位表示。蒸馏(Distillation) 则是另一条路径:用大模型(教师)的输出分布来训练一个小模型(学生),让后者在更少参数下模仿前者的行为模式。两者结合使用时,量化负责"削减体积",蒸馏负责"修复因压缩导致的能力损耗",互为补充。96%的性能保留率之所以罕见,正在于蒸馏步骤能在一定程度上弥补激进量化带来的精度退化,而非单纯依赖量化算法本身。
工具调用:小模型反超大模型的意外结果
对现代AI Agent而言,工具调用(Function Calling)是决定可用性的核心能力。Underdog AI 在这一维度做了深度专项调优,结果颇具戏剧性。
在基于伯克利 BFCL V4 榜单构建的 Underdog Bench 120项函数调用测试中,Saluki 27B 拿到 88分,直接反超了54GB全尺寸原版的84分。按官方解释,更小的体量反而抑制了模型的"发散废话",让参数抽取与格式对齐更加精准凝练。
在并发任务上,这种优势进一步放大。BFCL 官方100项并行工具调用测试中,Saluki 斩获 42分,远超原版的35分,成功率提升约20%。
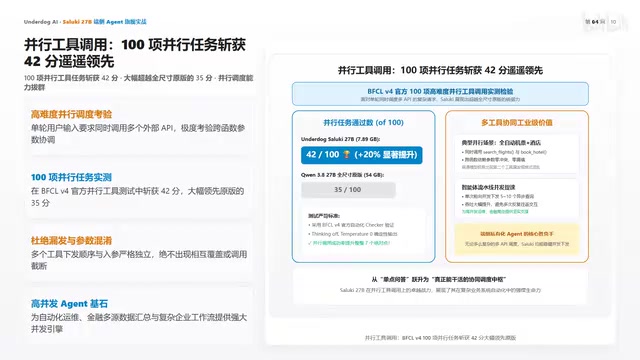
无论是机票酒店的跨函数联动,还是多元数据库的并发查询,Saluki 据称能做到零漏发、零混淆。这种在多工具协同场景下的"调度中枢"定位,正是端侧Agent落地的关键能力——毕竟本地运行的Agent更需要稳定可靠,而非偶尔惊艳。
BFCL(Berkeley Function Calling Leaderboard) 是由加州大学伯克利分校发布的专项基准,专门评估大语言模型在结构化函数调用场景下的准确率,涵盖单函数调用、嵌套调用、并行调用及多轮对话等多个子维度,是目前业界评估Agent工具使用能力最具参考价值的榜单之一。文中提到的"并行工具调用"(Parallel Function Calling)尤其具有现实意义:它要求模型在单次响应中同时生成多个独立函数调用指令,并在结果返回后正确汇总——这对参数抽取的精确性和格式稳定性要求极高,也是许多大模型在实际Agent部署中出现"工具漏调"或"参数混淆"的主要失效场景。
代码与指令遵循:工程能力的硬核验证
工具调用之外,Saluki 在真实工程场景的表现同样关键。在业界推崇的 SWE-Bench Verified 基准中,面对50个源自真实开源项目的复杂 Issue,Saluki 成功解决了 30个,对比全尺寸原版的33个,保留了约91%的实战修复力。按官方描述,它能穿透项目代码库上下文并自动生成标准补丁,让"单机全自动代码助手"成为可能。
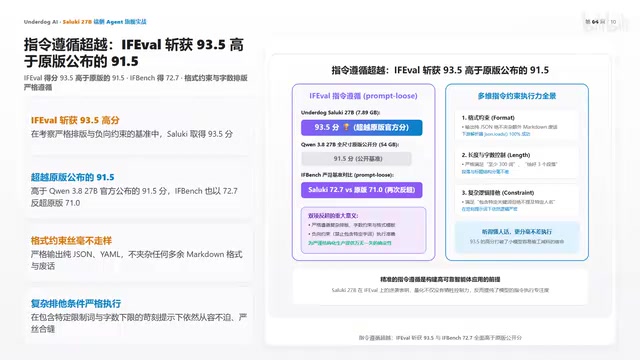
在严谨指令遵循上,Saluki 甚至超越了原版。IFEval 基准中拿到 93.5分(原版91.5分),IFBench 中以72.7分反超原版的71.0分。无论是严格限定纯JSON输出,还是精确控制字数与段落约束,模型都能较为精准地执行。
推理维度上,官方公布的数据相对诚实:代码生成基准 MBPP+ 取得78.0分,多步因果逻辑取得67.5分,而在顶级数学竞赛 AIME 测试中取得80.0分,保留了原版82%~85%的数学推理能力。可以看出,纯推理场景是压缩损失相对集中的地方,但对于一个7.9GB的模型来说,这个保留率依然稳固。
SWE-Bench Verified 是目前评估AI软件工程能力最贴近真实场景的基准之一。它从GitHub上的真实开源项目(如Django、Flask、NumPy等)中抽取已有标准修复补丁的Issue,要求模型在给定代码库上下文后,自动生成能通过对应单元测试的代码补丁。"Verified"子集经过人工筛选,剔除了原始集合中描述模糊或测试不可靠的样例,使评估结果更具可信度。30/50的解决率意味着模型需要完成代码定位、跨文件理解、修改生成与格式合规等多个步骤,而非简单的代码补全——这也是为何该指标比传统的HumanEval等基准更能反映模型的实际工程价值。
热插拔架构与部署体验
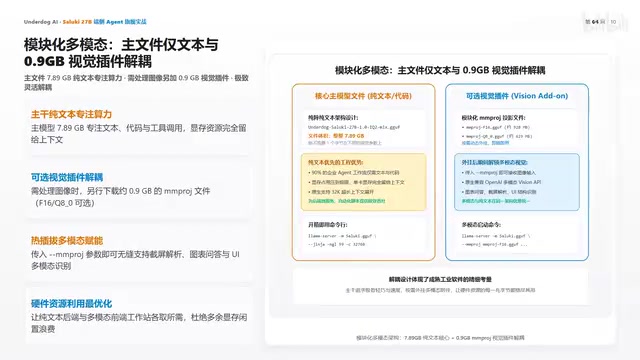
Saluki 的架构设计体现了对本地资源的精打细算。7.89GB 的主模型文件完全专注于纯文本与代码逻辑,把宝贵的本地显存留给 32K上下文 展开。当需要处理图像时,开发者只需额外下载约0.9GB的视觉投影插件(M-Projector),即可无缝扩展多模态能力。
这种"热插拔"设计让硬件资源的每一兆字节都得到利用——不需要视觉能力时,就不必为它付出显存成本。
部署体验上,模型采用标准 GGUF 格式,用未修改的 llama.cpp 即可一行命令拉起服务,原生适配 Qwen3 的对话模板。同时支持思考模式灵活切换:默认开启长程思维链应对复杂难题,而在高频工具调用时可单次关闭,实现毫秒级响应。
GGUF(GPT-Generated Unified Format) 是由llama.cpp项目定义的模型文件格式,专为本地推理优化设计。它将模型权重、量化元数据和对话模板等信息统一打包进单一文件,无需额外依赖库即可被llama.cpp直接加载。相比早期的GGML格式,GGUF具备更强的前向兼容性与跨平台支持,已成为端侧开源模型分发的事实标准。对于普通用户而言,GGUF格式的实际意义在于:只需下载一个文件,通过一行终端命令即可在CPU或消费级GPU上运行量化模型,无需配置复杂的Python环境或依赖CUDA驱动,大幅降低了本地部署的技术门槛。
智力密度的胜利
Saluki 27B 真正的意义,不在于某一项跑分,而在于证明了"智力密度"是可以被工程手段大幅提升的。基于 Apache 2.0 商业友好协议、仅需约7.9GB内存开销,便让普通设备拥有27B级别的推理能力,这为端侧自主智能体的普惠落地推开了一扇门。
当然,作为单一来源发布的性能数据,上述跑分仍需社区更广泛的复现验证——尤其是工具调用"反超原版"这类反直觉结论,更值得第三方评测的交叉检验。但方向本身无疑令人期待:当顶级模型不再被硬件门槛锁死,本地化、隐私友好的AI应用将获得更大的想象空间。
相关推荐

Kimi K3.1实测:开源模型逼近Opus,视频生成意外抢镜
Kimi K3.1在直播实测中完成运动图形、3D渲染、小游戏与视频生成等复合任务。本文分析其2.8万亿参数MoE架构的真实表现、与Opus/GPT的体感差距,以及被官方忽略的视频生成能力,并讨论多模型并用时代的工作流变化。

Sam Altman:人生重大建议,为何仍需来自人类?
OpenAI CEO Sam Altman 谈 AI 建议的边界:AI 能劝阻冲动邮件,但人生重大建议仍应来自人类。他期待 AI 成为会反驳的资深同事,而非谄媚工具。

“黑色十月”:AI挖出史上3%严重漏洞?
Reddit 热帖称过去一个月发现了史上 3% 的严重软件漏洞,被称为「黑色十月」。本文拆解这一说法的统计口径问题,分析 AI 辅助代码审计如何加速漏洞发现,以及开发者和企业该如何应对补丁窗口缩短的挑战。