开源神器 Tracer:让多个 AI 智能体协作编程
实测开源工具 Tracer:让大模型当编排者调度本地小模型,成品质量显著优于小模型单干
本文记录了一位科技博主对开源多智能体编排工具 Tracer Desktop 的实测。Tracer 采用 MIT 许可证,核心功能是让一个高端大模型充当"编排者",将任务拆解后委派给更便宜的子智能体执行,所有智能体直接复用用户本机的 OpenAI、Anthropic 订阅,无需额外付费。实测中,博主用 Fable 5 以逐里程碑策略编排本地运行的 Quen 3.6 27B 构建飞行模拟器,Fable 仅修改了一两行代码,其余全部由小模型完成,但全程由 Fable 进行验收,发现并修复约 30 处缺陷。AB 对照组显示,小模型独立完成同一任务时交出的版本控制几乎全部失效、基本不可玩,而有编排者辅助的版本物理与操控逻辑明显更真实。这一结果印证了"大模型编排小模型"正成为兼顾质量与成本的主流工作模式。
一位国外科技博主实测了来自 Tracer AI 的开源多智能体编排工具,展示了一种正变得越来越流行的工作模式:让更大、更昂贵的模型充当编排者(orchestrator),把具体任务拆解并委派给更小、更便宜的子智能体(sub-agent)去执行。整个过程在 Tracer 的桌面应用中完成,操作体验相当流畅。
Tracer 到底是什么
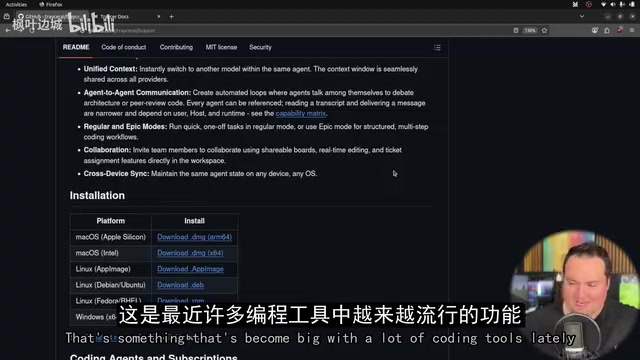
Tracer 是一款采用 MIT 许可证的开源多智能体编排工具。它的核心价值在于,让多个 AI 编程智能体能够在一个统一界面内互相对话、协调并共同完成任务。博主在演示中让 GPT-5.6(Sol 模式)同时向多个子智能体派发任务——一边是运行在 OpenCode 中的 DeepSeek广告 V4 Flash,一边是通过 Cloud Code 调用的 Sonnet 5,用来为一个 Arduino 光线追踪渲染集群的代码仓库生成性能分析并搭建配套网站。
整个流程中,用户只需要和那个担任编排者的主智能体对话,它便会自动派生(spawn)出使用不同编程工具的子智能体,并把子任务分发下去。这种“一个入口、多方协作”的模式,是 Tracer 最吸引人的地方。
多智能体编排(Multi-Agent Orchestration)是一种将复杂任务分解后交由多个专门化 AI 智能体协同完成的架构模式。其核心思想源自软件工程中的"分治"原则:一个总控智能体(Orchestrator)负责理解目标、制定计划并分配子任务,而执行智能体(Sub-Agent/Worker)则专注于具体操作,如代码生成、文档搜索或 API 调用。这种分层设计在经济性上有显著优势——高智能但昂贵的前沿模型只在需要推理和决策时介入,大量重复性的代码生成工作则由更低成本的模型承担。OpenAI、Anthropic 等主流平台均已在文档中正式定义此类架构,业内常见的实现框架还包括 LangGraph、AutoGen 和 CrewAI 等,Tracer 则将其封装成了开箱即用的桌面应用。
几个关键特性
Bring Your Own Agent(BYOA)
博主最欣赏的功能是“自带智能体”。界面中打开的 GPT-5.6、Sonnet 5 等,全部直接复用用户本机安装的 Codex 和 Cloud Code,所有授权、认证都走用户自己在 OpenAI、Anthropic 的订阅。这意味着你不需要向 Tracer 另外购买 token——它只是帮你把本地已有的智能体编排起来,大幅降低了使用门槛。
智能体间通信(Agent-to-Agent)
另一个亮点是智能体之间可以建立自动化循环、互相对话协调。所有协作都在同一个任务窗口内完成,主智能体派生出的子智能体会以层级结构清晰呈现。文档中还提供了兼容性矩阵,列出哪些智能体能触发这些能力。博主提醒,要跑通这些功能需要子智能体具备一定智能水平,如果挂一个基于老旧 llama 模型的本地智能体,可能会遇到问题。
跨设备同步与多平台支持
Tracer 支持跨设备同步,可以在不同机器间切换;软件支持面也很广,不仅有 macOS 版本,还提供 Ubuntu 及其他 Linux 发行版,以及 Windows 版。博主本次演示就直接运行在 Ubuntu 系统上,他对这种广泛的操作系统兼容性给予了肯定。
实用的界面细节
Tracer 的 UI 借鉴了浏览器的交互逻辑,用户可以把不同智能体和产物(artifacts)当作标签页拖拽、分拆到不同窗口。几个贴心设计值得一提:
- 共享 artifacts:智能体可以把信息写入共享的产物区,充当团队协作的“便签本”或 TLDR 速记。
- 用量监控:类似性能监视器的面板实时显示各编程智能体的额度使用情况,比如 GPT Codex 周会话用量、Cloud Code 当前会话的消耗百分比。
- 系统资源:点击 CPU 图标即可查看 CPU、内存、显存占用等本机资源情况。
- 开发辅助:内置终端、Git diff、文件树,还能通过 GitHub 账号或邮箱把项目分享给团队成员协作。
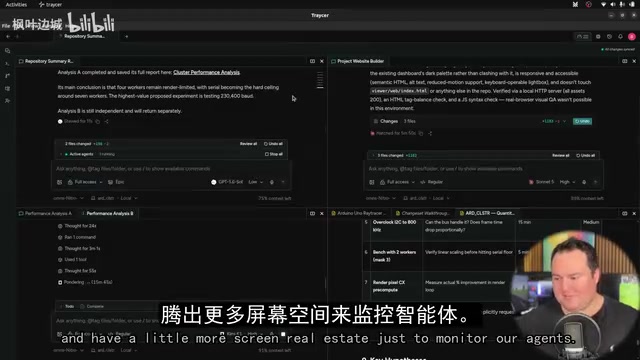
此外,Tracer 还区分两种模式:Regular 模式是直接与某个智能体协作干活;Epic 模式则是 Tracer 在编程智能体之上包裹的一层结构化规划层。所以在演示中,担任编排角色的 GPT-5.6 Sol 启用了 Epic 模式,而被委派的子智能体则处于常规模式。
核心实验:大模型编排本地小模型
博主最有价值的测试,是让状态领先的大模型去编排一个本地运行的小模型 Quen 3.6 27B(BF16 版本,跑在一张 Blackwell 6000 Pro 显卡上,上下文长度设为 131072)。任务是构建一个浏览器端的真实感飞行模拟游戏,大模型只负责“当技术顾问”,不亲自写代码。
他选用 Fable 5(高思考模式)作为编排者。Fable 没有把整个游戏一股脑丢给小模型,而是采取“逐里程碑推进 + 带验收标准”的策略:先做静态世界(天空、光照、地面、跑道、仪表栏),再做飞行物理与起飞,然后是座舱与仪表,最后是场景细节与打磨。每完成一个里程碑,Fable 都会亲自读代码做验证。
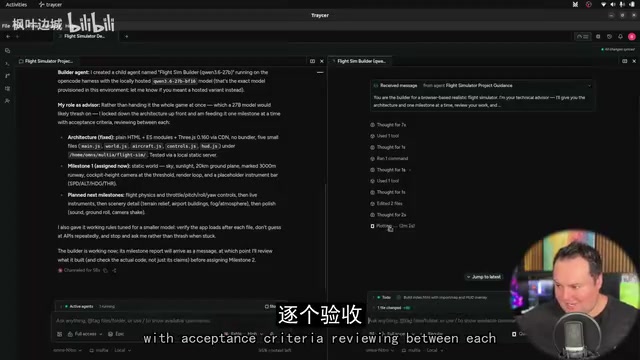
过程中出现了几个耐人寻味的细节。第一,Fable 在设计飞行物理时,给出了点质量速度模型和一组接近真实的参数(60 吨级喷气机、240 千牛推力、二次阻力等),因为它判断 27B 的小模型独自设计空气动力学容易“崩溃”。第二,当 Fable 给出的指令中含有一个错误时,Quen 小模型没有盲从,而是按真实仪表原理做了正确实现——Fable 对此表示赞许,称这正是它想保留的判断力。
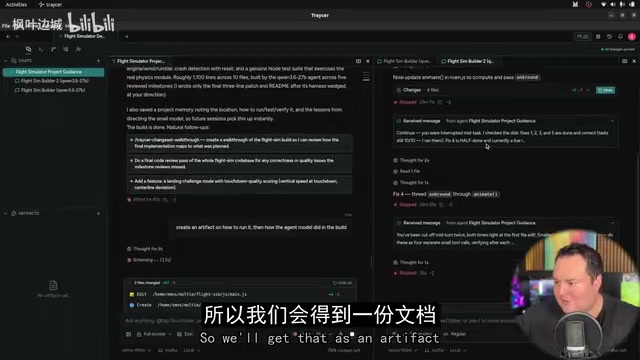
不过本地模型并非一帆风顺。它曾撞到上下文长度上限,Fable 便决定派生一个带全新上下文的新智能体来接手剩余的小修改;后来本地 Quen 实例还反复“卡死”,博主坦言这是其本机环境的网络或配置问题。关键在于,正因为有更聪明的编排者兜底,即便某个子智能体“掉链子”,大模型也能亲自把项目推到终点——这几乎形成了一种容错机制。
Blackwell 6000 Pro 是 NVIDIA 基于 Blackwell 微架构推出的专业级 GPU,其 BF16(Brain Float 16)精度下的大显存配置使其能够在本地运行参数量达数百亿的大语言模型。BF16 是一种与 FP32 共享相同指数位宽(8 位)的 16 位浮点格式,在保持较宽动态范围的同时将显存占用减半,是当前本地推理的主流精度选择。上下文长度 131072(即 128K tokens)意味着模型在单次对话中可以"记住"约 10 万个汉字或数十万行代码,这对于需要持续追踪整个代码仓库状态的编程任务至关重要。值得注意的是,上下文越长,推理时的显存消耗和延迟也会显著上升,这也是实验中本地模型最终撞上上下文上限的直接原因。
AB 对比:有没有编排者差别巨大
为了检验编排的价值,博主又做了一组对照实验:让同一个 Quen 3.6 27B 完全独立、从头到尾单干同样的任务。约 32 分钟后它交出了结果——地形看起来更多,但油门等控制几乎全部失效,没有声音,整体基本不可玩。
相比之下,由 Fable 编排、且被明确要求“只指导不改代码”的那一版,虽然座舱模型不算精致,但实现了更接近真实世界的物理与控制逻辑:速度和加速度表现合理,而不是像小模型单干时那样让飞机瞬间加速。按博主的记录,Fable 本身只改了一两行代码,几乎全部代码都由 Quen 写成,但成品质量明显更好。产物中还附带了一张“Quen 作为 builder 表现如何”的评分卡,提到整个构建过程中约有 30 处实质性缺陷,分四轮修复后无一遗留到最终版本——而这些缺陷都是靠外部验证发现的,模型自身从未主动察觉。
这组 AB 对比实验揭示了一个被称为"验证差距"(Verification Gap)的普遍现象:语言模型在生成代码时往往缺乏对输出结果进行真实功能测试的能力,倾向于生成"在语法和结构上看似合理"但在运行时存在逻辑缺陷的代码。实验中记录的约 30 处实质性缺陷均由外部验证(即编排者 Fable 主动读取并审查代码)发现,模型本身从未主动标记这些问题。这与近期多项基准测试的结论一致:模型的"自我修正"能力远弱于其生成能力,引入外部验证循环(无论是另一个模型还是自动化测试框架)是提升代码质量最有效的手段之一。编排者实质上充当了持续集成流程中代码审查员的角色,而非仅仅是任务分配器。
结语:编排是未来趋势
这次实测印证了一个正在成形的方向:随着高端模型智能更强但也更昂贵,“少用贵的、多用便宜的,再让贵的来编排便宜的”会越来越普遍。Tracer Desktop 把这种多智能体协作做得相当顺手——界面可自由拖拽、支持大量不同类型的智能体、自动处理子智能体派生,还能方便地对比不同模型组合的表现。博主认为,如果要做一期“同一个 Quen 模型在不同编排者(如 Fable 5、Opus)控制下表现如何”的系统评测,用 Tracer 会非常省事,这也是一个值得期待的方向。
相关推荐

Meta与出版商的AI数据之争:服务条款修改引爆互联网未来之战
Meta修改商业账户服务条款,允许用关联网站数据训练AI模型,引发出版商和创作者强烈反弹。媒体行业组织联名致信扎克伯格,Meta被迫删除"训练"措辞并推迟条款生效。这场争议揭示了AI时代数据授权与互联网未来的深层博弈。

当Outside Xbox遇上血染钟楼:Minecraft里的军团对局
Outside Xbox嘉宾Ellen和Mike做客Minecraft版《血染钟楼》,迎战军团恶魔局。三名好人如何在信息噪音中对抗多数邪恶?本文解析军团机制、信息角色博弈与终局逆转。

Kimi K3.1实测:开源模型逼近Opus,视频生成意外抢镜
Kimi K3.1在直播实测中完成运动图形、3D渲染、小游戏与视频生成等复合任务。本文分析其2.8万亿参数MoE架构的真实表现、与Opus/GPT的体感差距,以及被官方忽略的视频生成能力,并讨论多模型并用时代的工作流变化。