开源智能商业数据助手:RAG+MCP+RBAC的记忆驱动架构解析
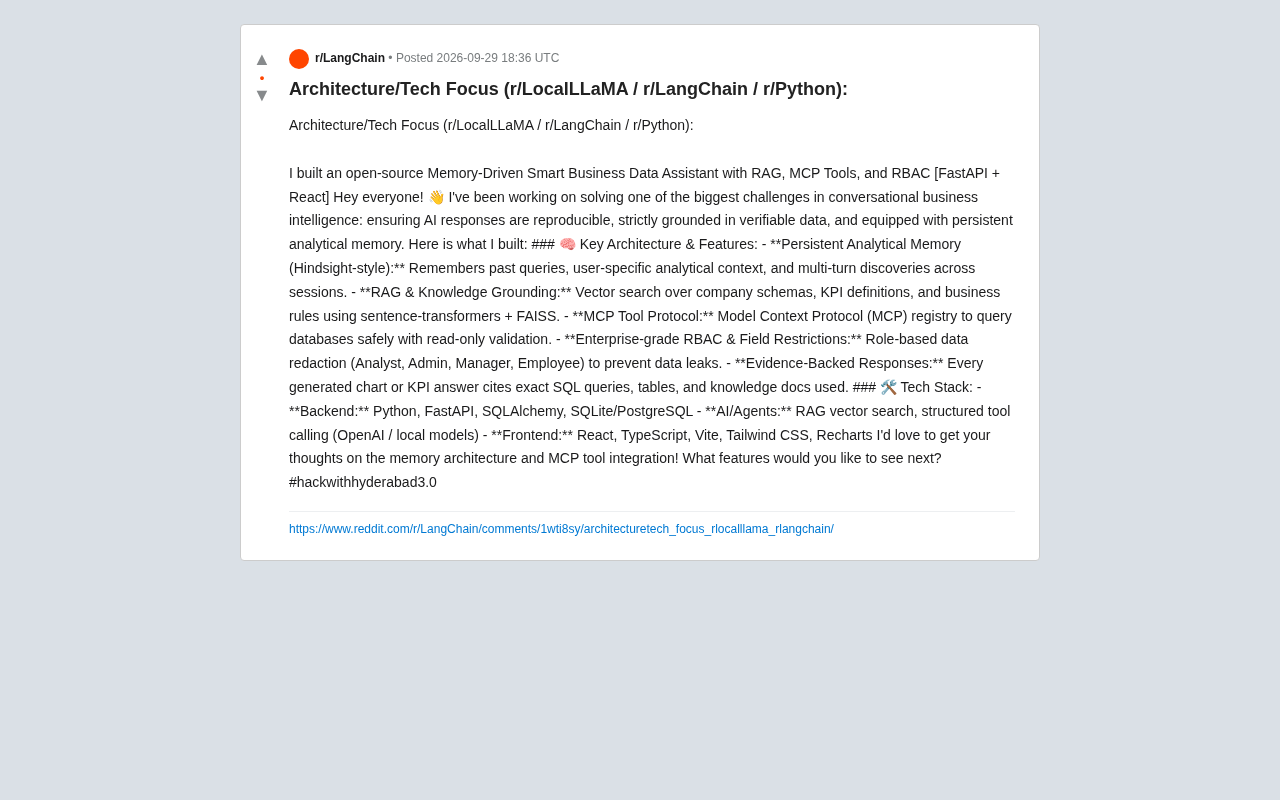
融合RAG、MCP与RBAC的开源对话式BI助手,以可验证、可审计为核心实现企业级数据分析。
这是一个面向企业数据分析场景的开源对话式BI项目,核心理念是"证据支撑"——每一条AI回答都必须引用可追溯的SQL查询、数据表和知识文档,从根本上解决大模型幻觉与不可审计的问题。项目综合运用了RAG(sentence-transformers + FAISS向量检索)实现知识锚定、Hindsight-style持久化记忆实现跨会话分析连续性、MCP协议实现只读安全的数据库工具访问,以及企业级RBAC与字段级数据脱敏防止越权泄露。技术栈采用FastAPI + React,AI层同时兼容OpenAI与本地模型,适合隐私敏感的私有化部署场景。该项目的价值在于将多个模块系统性整合为一套可落地的工程架构,为探索企业级对话式BI的团队提供了完整的参考蓝图。
在对话式商业智能(Conversational BI)领域,一个长期困扰开发者的难题是:如何让 AI 的回答可复现、严格基于可验证数据,并且具备跨会话的持久化分析记忆。近期一位开发者在 r/LocalLLaMA、r/LangChain 和 r/Python 社区分享了他的开源项目——一个融合 RAG、MCP 工具协议与 RBAC 权限控制的记忆驱动型商业数据助手,为解决上述问题提供了一套完整的工程实践参考。
为什么企业级 BI 助手需要"可验证性"
通用大模型在面对企业数据分析场景时,最大的风险并非能力不足,而是"幻觉"和不可追溯。当一个 AI 给出某项 KPI 的数值或生成一张图表时,如果无法追溯它究竟查询了哪张表、执行了什么 SQL、引用了哪份业务规则文档,那么这个答案在企业决策场景中几乎没有可信度可言。
该项目正是围绕"证据支撑"(Evidence-Backed)这一核心理念构建:每一个生成的图表或 KPI 回答,都会引用其所使用的精确 SQL 查询、数据表以及知识文档。这种设计将 AI 从"黑盒回答者"转变为"可审计的分析工具",是企业落地 AI 数据助手时绕不开的关键需求。
记忆架构:让分析具备连续性
项目的一大亮点是所谓的"持久化分析记忆"(Persistent Analytical Memory),作者称之为 Hindsight-style 记忆机制。它能够记住用户过去的查询、用户特定的分析上下文,以及跨会话的多轮分析发现。
这一设计切中了对话式 BI 的痛点。传统的问答式数据分析往往是无状态的——每次提问都从零开始,用户不得不反复重述背景。而具备持久化记忆后,助手可以在多轮对话中逐步积累对某项业务指标的理解,形成连贯的分析脉络。这种"记住上下文"的能力,正是从简单查询工具迈向真正智能助手的分水岭。
"Hindsight-style 记忆"借鉴了认知科学中"后见之明"(hindsight)的概念,强调系统能够在事后对历史交互进行反思性总结,而非简单地原样存储聊天记录。在工程实现上,这类记忆通常分为两层:短期记忆(当前会话的上下文窗口)和长期记忆(跨会话的持久化存储,一般落库或写入向量索引)。相比直接将全部历史消息塞入上下文(受 Token 限制且噪声大),Hindsight 风格的记忆会提炼关键发现与用户偏好,以压缩的语义摘要形式存储,在新会话开始时按需检索召回。这种设计使助手能在长期使用中逐渐"了解"某位分析师的业务关注点,而不是每次都从零开始建立上下文。
RAG 与知识锚定:把回答绑在企业数据上
为了确保回答严格基于企业自身的数据语义,项目采用了 RAG(检索增强生成)方案,通过 sentence-transformers 生成向量、FAISS 完成向量检索,对公司的数据表结构(schema)、KPI 定义和业务规则进行语义检索。
这一层的意义在于,它让模型不再凭借泛化的通用知识去"猜"企业指标的含义,而是从真实的知识库中检索出对应的定义和规则。例如当用户询问某个自定义 KPI 时,系统会先检索到该 KPI 的准确定义文档,再据此生成回答,从而实现"知识锚定"(Knowledge Grounding)。
RAG(Retrieval-Augmented Generation,检索增强生成)的核心思路是将"检索"与"生成"解耦:模型不再依赖训练时记忆的知识,而是在推理阶段实时从外部知识库中取回相关片段,再将其注入提示词(Prompt)供模型参考生成答案。这一架构极大降低了幻觉风险,因为模型的输出有明确的文档来源可以比对。本项目中,sentence-transformers 负责将文本(如表结构描述、KPI 定义)编码为高维向量,FAISS(Facebook AI Similarity Search)则是一个高效的近似最近邻向量检索库,能在毫秒级内从数百万向量中找到与查询语义最相似的文档片段。两者配合构成了离线索引与在线检索的完整流水线,也是目前企业私有知识库问答场景中最常见的技术组合之一。
MCP 工具协议:安全地访问数据库
项目引入了 Model Context Protocol(MCP)工具注册机制来处理数据库查询。值得关注的是其"只读校验"(read-only validation)设计——通过 MCP 注册表管理工具调用,确保 AI 对数据库的访问被限制在安全范围内,避免任意写操作带来的风险。
MCP 作为近期在 AI Agent 领域快速升温的协议标准,其价值在于为模型调用外部工具提供了标准化、可控的接口。将其应用在数据库访问这类高敏感场景中,配合只读约束,是一种务实的安全工程思路。
Model Context Protocol(MCP)由 Anthropic 于 2024 年底提出并开源,目标是为 AI 模型与外部工具、数据源之间的交互建立一套标准化协议,类似于 USB 接口之于硬件设备的角色。在此之前,每个 AI 应用都需要自行实现函数调用(Function Calling)或工具注册逻辑,接口碎片化严重。MCP 通过统一的工具描述格式(JSON Schema)和调用生命周期管理,使模型能够以一致的方式发现并调用任意外部工具。在数据库访问场景中,MCP 的工具注册机制可以精确声明每个工具的能力边界——例如只暴露 SELECT 查询接口而屏蔽 INSERT、UPDATE、DELETE——从而在协议层面强制执行只读约束,而不仅依赖应用层的业务逻辑判断。这比传统的"在代码里加个 if 判断"更具工程可靠性,也更便于审计。
RBAC 权限控制:防止数据泄露
企业数据的敏感性决定了权限管理不可或缺。该项目实现了企业级的基于角色的访问控制(RBAC)与字段级限制,划分了分析师(Analyst)、管理员(Admin)、经理(Manager)、员工(Employee)等角色,并针对不同角色进行数据脱敏(data redaction),以防止越权访问导致的数据泄露。
字段级的数据脱敏意味着同一份数据在不同角色眼中呈现的粒度不同——这是企业 BI 系统与个人分析工具之间的本质区别,也是项目"企业级"定位的重要体现。
技术栈一览
从工程实现看,该项目采用了较为主流且成熟的技术组合:
- 后端:Python、FastAPI、SQLAlchemy,数据库支持 SQLite / PostgreSQL
- AI / Agent 层:RAG 向量检索、结构化工具调用(支持 OpenAI 或本地模型)
- 前端:React、TypeScript、Vite、Tailwind CSS、Recharts
值得一提的是 AI 层同时兼容 OpenAI 与本地模型,这对注重数据隐私、希望本地化部署的企业场景相当友好,也解释了为何该项目会在 r/LocalLLaMA 社区引发讨论。
小结与展望
这个开源项目的价值不在于单点技术的突破,而在于它把 RAG、记忆、MCP、RBAC 等多个模块系统性地整合进一个可落地的商业数据助手架构中,并始终围绕"可验证、可复现、可审计"这一核心目标展开。对于正在探索企业级对话式 BI 的团队而言,它提供了一份颇具参考价值的工程蓝图。
作者本人也在社区征求对记忆架构和 MCP 工具集成的反馈,并询问社区希望看到的下一步功能。这类开放式的迭代方式,正是开源项目保持生命力的关键所在。
相关推荐

MrBeast百万美元挑战:吃空整家超市的内容工业拆解
深度拆解MrBeast百万美元吃空超市挑战:430万卡路里、202天封闭拍摄、规则设计与人物成长,解析头部内容创作者的工业化方法论与商业慈善双线叙事。

Cloudflare 推出 OHTTP 网关:隐私保护的新基础设施
Cloudflare 宣布推出 OHTTP 网关服务,通过中继与网关职责分离,将用户身份与请求内容解耦,为应用遥测、隐私合规等场景提供托管式隐私保护基础设施。本文解析 OHTTP 原理、信任模型与适用局限。

AI 自动化冷邮件:从网站痛点生成个性化外联的实战思路
一位网页设计从业者分享如何用 AI 工具 Swokei 自动诊断潜在客户网站的设计、速度、移动端与 SEO 问题,并生成个性化冷邮件,重构 B2B 外联工作流。本文解析其价值、分工逻辑与合规边界。