开源之痛:独立开发者的架构比前沿实验室早一年却无人问津
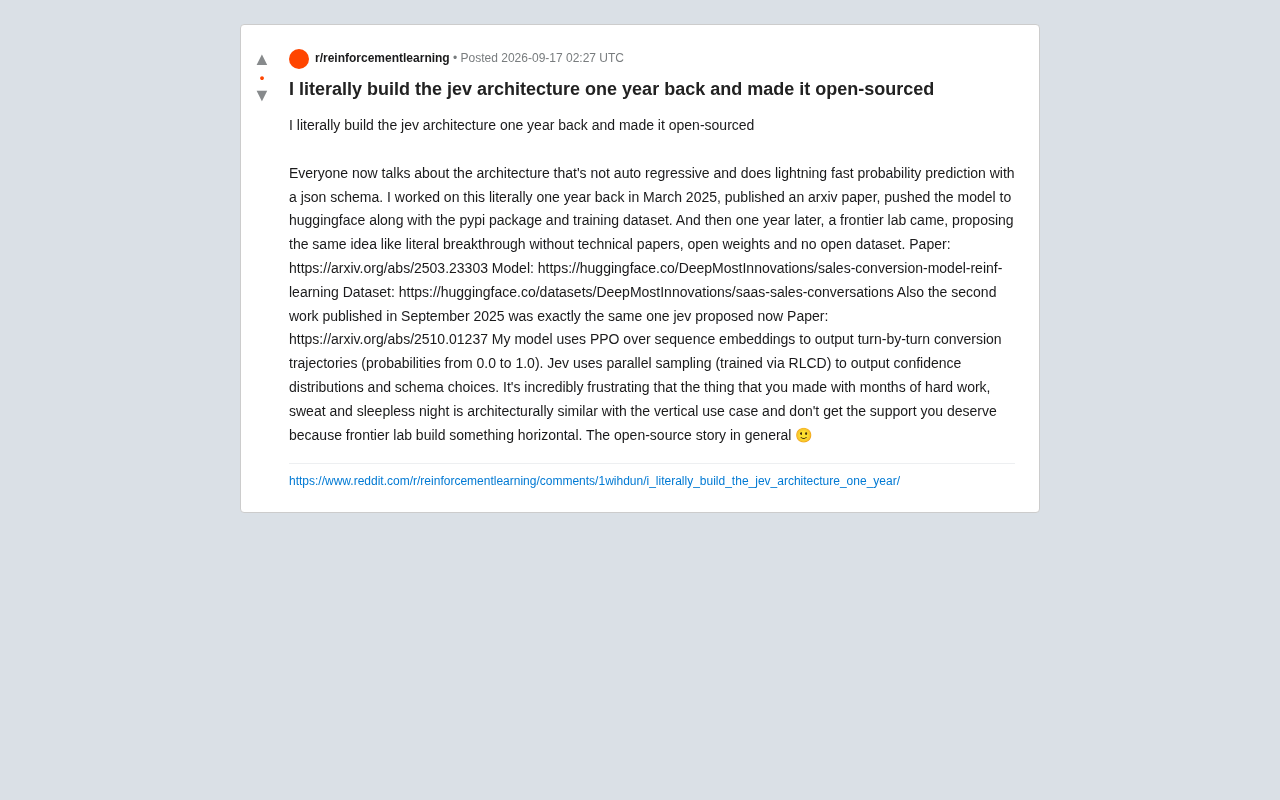
独立开发者称一年前已开源类似非自回归架构,引发开源贡献可见度不对等的讨论。
一位独立开发者在Reddit发帖,声称自己早在一年多前就构建并开源了与某前沿实验室"jev架构"高度相似的非自回归系统,并附上arXiv论文、Hugging Face模型、PyPI包和公开数据集作为佐证。技术层面,其方案以PPO训练序列嵌入输出销售转化轨迹,jev则采用RLCD并行采样输出置信度分布,二者均脱离自回归范式、以强化学习产出结构化概率输出,但在训练算法、采样方式和应用场景上存在实质差异。文章以此为切入点,揭示了开源生态中技术优先级与社区认可度之间长期存在的鸿沟:前沿实验室凭借传播势能和叙事能力轻松将同类想法定性为"突破",而独立开发者即便完全开放也难以获得对等的可见度。作者同时提醒,信息来自单一来源,多重独立发现在AI领域极为常见,不能仅凭架构相似断定抄袭。
一场关于"谁先做出来"的争论
最近围绕一种非自回归(non-autoregressive)架构的讨论在AI社区里持续升温。这类架构的核心卖点是:结合JSON schema进行极速的概率预测,摆脱传统自回归模型逐token生成的束缚。当一家前沿实验室将这套思路作为"突破性成果"推出时,一位独立开发者站出来表达了强烈的不满——他声称自己早在一年多前(2025年3月)就已经构建并开源了架构相似的系统。
这位开发者在Reddit上晒出了完整的证据链:一篇arXiv论文、一个上传到Hugging Face的模型、配套的PyPI包,以及公开的训练数据集。他的核心诉求并不复杂:为什么同样的想法,独立开发者做出来无人问津,而前沿实验室拿出来却被奉为"突破",即便后者既没有技术论文,也没有开放权重和开放数据集?
两套方案的技术对比
抛开情绪,单看技术路线本身,这个案例其实提供了一个有价值的对照样本。
独立开发者的方案
据发帖者描述,他的模型(DeepMostInnovations 的销售转化模型)采用 PPO(近端策略优化) 在序列嵌入(sequence embeddings)之上进行训练,输出的是逐轮对话的转化轨迹——也就是从 0.0 到 1.0 的转化概率序列。这是一个高度垂直的应用场景:预测销售对话中的转化可能性。他还公开了对应的 SaaS 销售对话数据集,形成了论文、模型、数据、工具包的完整闭环。
PPO(Proximal Policy Optimization,近端策略优化) 是强化学习中的一类策略梯度算法,由OpenAI于2017年提出。其核心思想是在每次策略更新时,通过"裁剪"目标函数来限制新旧策略之间的偏差幅度,从而避免过大的参数更新导致训练不稳定。相比早期的TRPO算法,PPO实现简单、计算高效,在机器人控制、游戏博弈以及大语言模型的RLHF对齐训练中被广泛采用。将PPO用于序列嵌入之上,意味着模型不是直接在token层面做强化学习,而是先将对话序列压缩为向量表示,再以此为状态空间进行策略优化——这种设计可以大幅降低动作空间的复杂度,但也要求嵌入本身能充分捕捉对话语义信息。
前沿实验室的方案
被对比的"jev"架构则采用 并行采样(parallel sampling),通过 RLCD(Reinforcement Learning from Contrastive Distillation,对比蒸馏强化学习)训练,输出的是置信度分布和 schema 选择。这是一个更加**横向(horizontal)**的通用方案。
二者的相似之处在于都试图脱离自回归范式、用强化学习手段来产出结构化的概率/置信度输出;差异则在于训练算法(PPO vs RLCD)、采样方式(轨迹式 vs 并行式)以及应用定位(垂直销售场景 vs 通用能力)。
发帖者还提到,2025年9月发表的第二篇工作(arXiv:2510.01237)与jev现在提出的方案"完全一样",进一步佐证了他"想法早已存在"的论点。
RLCD(Reinforcement Learning from Contrastive Distillation,对比蒸馏强化学习) 是一种相对新颖的训练范式,核心思路是通过构造正负样本对进行对比学习,再结合强化学习信号来蒸馏模型的输出分布。与PPO依赖明确奖励信号不同,RLCD更多地借助"优质输出 vs 劣质输出"之间的对比来引导策略改进,在不需要人工标注奖励的场景下尤其有优势。并行采样(parallel sampling) 则是指模型在推理时同时生成多个候选结果,再通过置信度分布或打分机制筛选最优输出,与自回归逐token生成的串行方式形成鲜明对比,理论上可以显著提升吞吐量和速度。
为什么"先做出来"往往不等于"被认可"
这个故事戳中了开源生态里一个反复出现的痛点:技术优先级(priority)与影响力(impact)之间存在巨大鸿沟。
独立开发者以最开放的姿态贡献了论文、开放权重和开放数据集,理论上这是学术与工程界最推崇的透明范式。但现实是,一个想法能否被广泛认知,往往不取决于谁最早提出,而取决于:
- 谁在什么场景下提出。垂直的销售转化预测,天然受众有限;而横向的通用架构则能触达整个行业的想象力。
- 谁来提出。前沿实验室自带巨大的传播势能和信任背书,同样的技术叙事在它们口中就更容易被定性为"突破"。
- 叙事包装能力。一个能被大众理解的"闪电般快速的概率预测"故事,远比一篇垂直领域的arXiv论文更容易破圈。
讽刺的是,发帖者指出对方"没有技术论文、没有开放权重、没有开放数据集",却获得了远超他的关注度。这恰恰暴露了当前AI话语权分配的不对称——开放程度与被认可程度并不成正比。
独立研究者能从中学到什么
这个案例并非孤例,而是开源生态的常态缩影。对于独立研究者和小团队,有几点现实的启示:
优先级证据要固化。 发帖者做对的一点是留下了完整的时间戳链条——arXiv论文、Hugging Face模型、PyPI包、公开数据集。这些都是可验证的先发证据,在争议中至关重要。
垂直深耕与横向传播需要权衡。 深耕垂直场景(如销售转化)能带来真实的商业价值,但传播天花板较低。如果目标是学术影响力,可能需要在成果发布时主动强调其可泛化的通用价值。
开放不等于自动获得回报。 完全开源是一种理想主义的贡献,但也意味着放弃了对叙事和商业化的部分掌控。开发者需要清醒认识到这种取舍。
值得冷静看待的另一面
提一嘴,本文所依据的信息来自单一的Reddit帖子,属于当事人的一面之词。"架构相似"是否构成实质性的技术等同,还需要专业的同行评审来判断。RLCD与PPO、并行采样与轨迹输出之间存在真实的技术差异,不能仅凭"都非自回归"就断定二者是同一发明。
技术史上,同一个想法被多个团队独立、几乎同时地发现(所谓 multiple discovery)是极为常见的现象。前沿实验室未必抄袭,更可能是沿着相似的技术趋势自然演进。真正的问题或许不在于"谁抄了谁",而在于整个生态如何更公平地为早期贡献者提供可见度和支持。
无论如何,这位开发者的委屈是真实的,也代表了大量默默耕耘的独立创作者的心声。这份"开源故事"的苦涩,值得整个社区认真反思。
科学史上将同一发现被多个研究者独立得出的现象称为 多重发现(Multiple Discovery),著名案例包括牛顿与莱布尼茨独立发明微积分、达尔文与华莱士同时提出自然选择理论。社会学家罗伯特·默顿(Robert Merton)的研究表明,当技术或知识积累到一定程度、相关工具和方法论趋于成熟时,同一突破往往会在不同地点几乎同步涌现。在深度学习领域,这一现象尤为普遍——相同的架构改进或训练技巧经常在数周内被多个团队独立发现并发表。因此,"谁先提出"的争议本身并不总能证明存在抄袭,更多时候只是反映了某一技术方向在特定时间节点已经"水到渠成"的成熟度。
相关推荐
冰岛Treble获1800万美元融资,押注语音仿真平台
冰岛语音仿真公司Treble完成1800万美元融资,其平台服务于语音AI模型开发者、AI可穿戴设备及机器人公司。本文解析语音仿真技术价值与融资背后的行业信号。
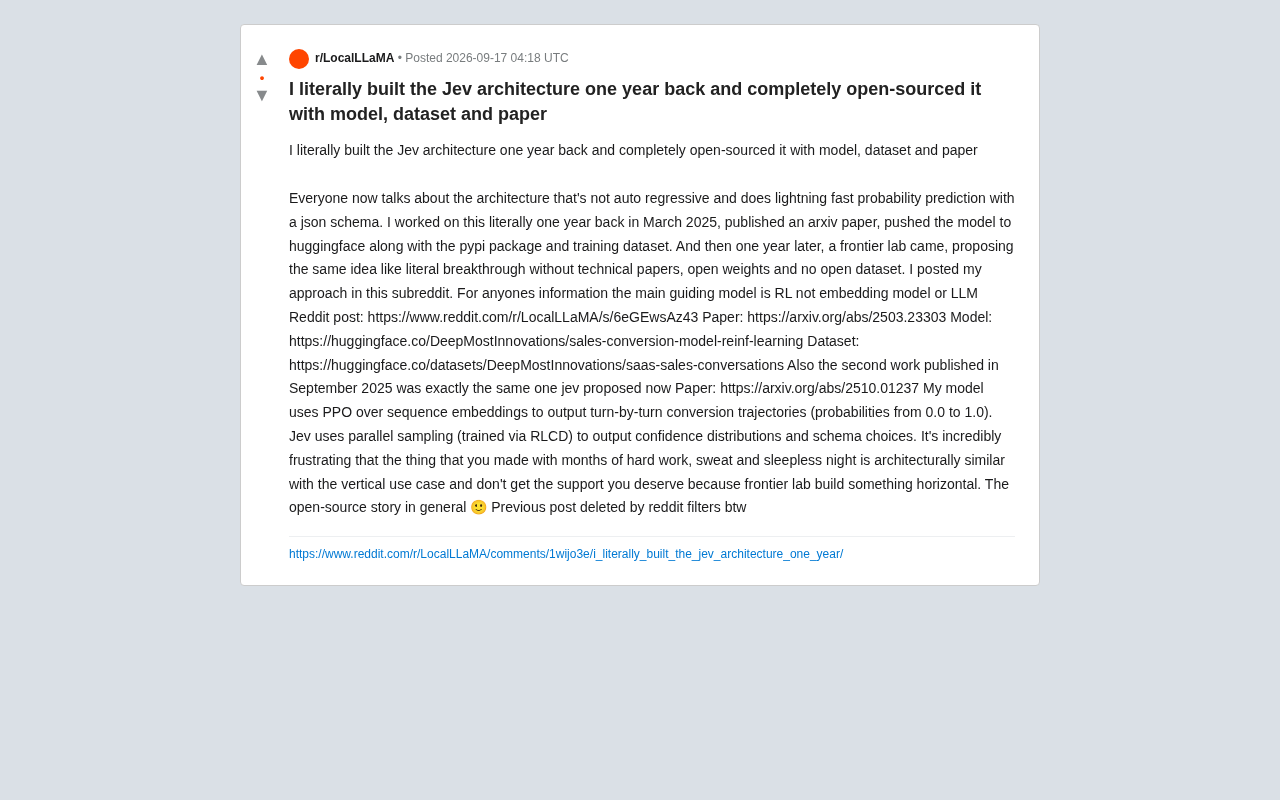
开源之痛:非自回归架构的先行者,为何被前沿实验室抢了风头
一位独立开发者在 Reddit 发帖称,其一年前开源的非自回归 RL 架构,被前沿实验室重新包装为突破。本文拆解 PPO 序列嵌入与 RLCD 并行采样两种路线的异同,并探讨开源生态的溯源与署名困境。
AI全程规划葡萄园:一场100株葡萄藤的真实实验
华盛顿州斯波坎一位爱好者让Muse AI全程规划葡萄园,从品种选择、行距到灌溉全部交给AI,最终种下100株品丽珠。这场AI主导、人类执行的公开实验,揭示了AI辅助农业的机会与边界。