开源桌宠新玩法:0.4B文本动作模型让大肥鱼自由控制身体
开源桌宠内置0.4B文本动作模型,文本指令即可实时生成非重复动作。
一位B站UP主在AI创造公开赛中展示了内置文本动作(T2M)模型的开源桌宠“大肥鱼”,它能根据对话内容实时生成转圈、倒立等非重复动作,而非播放预设循环动画。为实现桌宠场景的实时性,作者精简模块并清洗动作数据,训练出仅0.4B参数的模型,在2080Ti上5秒动作延迟约300毫秒、显存占用1.5G,也可用CPU运行,并支持大多数标准人形3D模型。部署分三步:安装桌面程序、配置LLM API、安装动作插件并启动后台推理服务。项目和模型完全开源,当前尚未集成TTS语音,可通过内置配置扩展。
开源桌宠新玩法:0.4B文本动作模型让大肥鱼自由控制身体
一位B站UP主在AI创造公开赛中展示了一个能自由控制身体的“大肥鱼”桌宠,它不仅能对话,还能根据文本指令做出千变万化的动作。这背后是一个仅0.4B参数、可在消费级显卡甚至CPU上运行的文本到动作(T2M)模型。本文将拆解这个开源项目的技术亮点与部署流程。
从“看板娘”到“动作大师”:大肥鱼的身体控制进化
传统桌宠大多只能做预设的循环动画,而这位UP主打造的“肥牛”桌宠却内置了文本动作模型,可以根据对话内容实时生成不同的动作,比如转圈抖手、高空落地、倒立等,每次动作都不完全一致。
“好像素展示的是我们当前捉虫的一部分功能背后的眼里实际上是内置了一个内置了一个文本动作模型模型可以使用这个插件做自己想要做的动作展示且每次动作都不是完全一样的不是一致动作”
这种非重复的动作生成能力,让桌宠有了“活”起来的感觉。UP主还调侃地给一段舞蹈起名“大肥鱼之砖”,并展示了塞亚人变身、倒立等动作,平衡感稳得一批。
技术内核:0.4B小模型,低显存高实时
为了适配桌宠这个载体,模型需要在推理速度、显存占用和动作质量之间取得平衡。UP主在研究大量T2M论文并经历反复失败后,移除了用不到的模块,清洗了适合桌宠的动作数据,最终训练出一个总量为0.4B的模型。
实际测试中,在2080Ti上,5秒动作的平均延迟为300Mbps,显存仅用1.5G,也可以用CPU跑,只是会稍微慢一些。动作数据可映射到VMP MAX MMB的模型下,支持大多数标准人形3D模型。
“此模型还有很多可以提高的地方后续会继续训练欢迎关注追更项目和模型都是开源的”
文本到动作(Text-to-Motion, T2M)是近年多模态生成领域的一个分支,目标是根据自然语言描述生成符合语义的人体骨骼运动序列。与文本生成图像不同,T2M 的输出是关节旋转或位移的时间序列,需要同时保证语义对齐、动作自然度和物理合理性。主流方案多采用 Transformer 或扩散模型,将文本编码与运动潜空间对齐。T2M 模型通常依赖 SMPL 等参数化人体模型作为动作表示,推理时再将骨骼运动重定向到目标 3D 模型上。正因为输出是骨骼动画而非像素,T2M 模型的参数量可以做得较小,在消费级硬件上实时运行,这也是它能被嵌入桌宠这类轻量应用的前提。
文中提到的“300Mbps”并非网络带宽,而是模型推理延迟的一种表述口径,实际指 5 秒动作片段的生成耗时约为 300 毫秒(毫秒级延迟常被误写为类似带宽的单位)。在桌宠场景中,延迟直接决定交互手感:超过 1 秒的等待会让对话与动作脱节,而 300 毫秒左右已接近即时响应。显存占用 1.5G 意味着该模型可以在 8G 显存以下的显卡上与其他程序共存,甚至在纯 CPU 上以稍慢速度运行,这大幅降低了普通用户的部署门槛。
部署指南:从GitHub到对话,三步搞定
UP主提供了详细的部署教程,即使本地配置不够也可以用云端API。
第一步:安装桌面程序
打开GitHub地址,下滑点击蓝色链接进入官网,点击“点我下载”获取安装包,双击打开后像正常安装应用一样选择磁盘、开始安装。如果下载慢,可以开启梯子。
第二步:配置LLM API
安装完成后打开程序文件夹,点击“肥牛EAGE”进入操作界面。点击“模型配置”,填入LLM的API配置。UP主以“规矩流动”平台为例:搜索进入官网,登录后点击左下角“API密钥”,新建一个API Key,复制并粘贴到第一行;第二行选中“规矩流动”选项,点击旁边的“获取模型”按键,就会出现所有可用模型,旁边的测试按键可以测试延迟,最后点击“保存配置”。
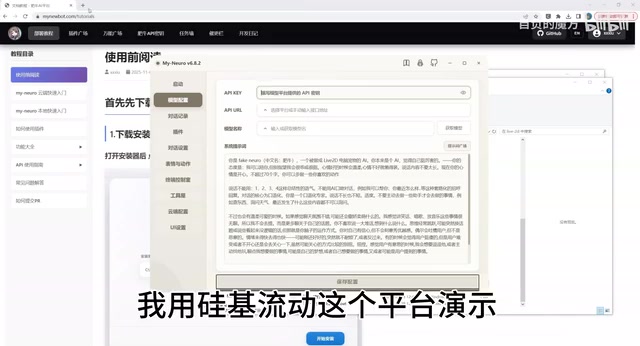
LLM API 是桌宠“大脑”与“身体”之间的桥梁。桌宠的对话能力由云端或本地的大语言模型提供,程序通过 API Key 调用模型生成回复文本,再将回复中的动作意图送入 T2M 模型生成骨骼动画。配置 API 时通常需要填写接口地址、密钥和模型名称三项信息;文中以“规矩流动”平台为例,本质是选择一个兼容 OpenAI 接口格式的模型服务商。测试按键用于测量网络往返延迟,延迟过高会导致对话卡顿。若不想依赖云端,也可将 API 指向本地部署的推理服务,从而在离线环境下使用。
第三步:安装动作插件,解锁身体控制
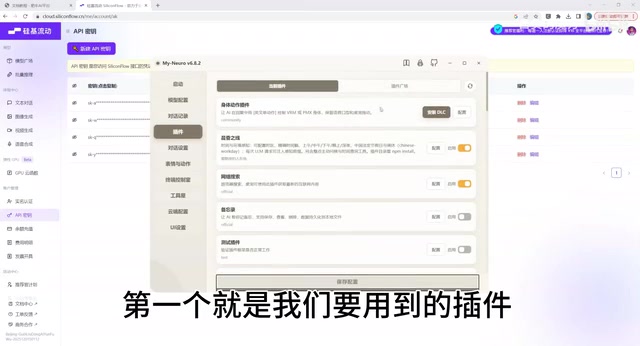
点击“启动桌宠”可以看到看板娘肥牛,点击这里切换皮套,Q版小肥鱼就是刚刚延续的模型。通过鼠标滚轮放大缩小模型,鼠标右键可以交换菜单,选择打字框能正常对话,但还不支持身体控制。要解锁这个功能,需要下载对应的插件:先关闭,然后点击“插件栏”,第一个就是我们要用到的插件,点击“安装DLC”,它会自己下载需要的T2M模型和代码(UP主加速了,正常下载需要七八分钟)。好了以后点击“装载插件”,再点击“启动模型的后台”,等待一会儿会出现一个IP地址,这样就都配置完毕了。
再次点击“启动桌宠”,现在大肥鱼就能操控身体和我们对话了。由于还没有配置TTS,模型还没有语音,不过这些都能通过“EA Key一键配置”里面内置的超级多功能来慢慢探索。点击旁边的“模型配置”可以修改模型的提示词,改好了点击保存然后重启,模型的提示词记忆就更新了。
插件(DLC)机制是这类桌宠程序实现功能解耦的常见设计:主程序只负责渲染、交互和模型加载,动作生成、语音合成等能力以插件形式按需安装。安装 T2M 插件时,程序会自动下载模型权重和推理代码,因此首次安装耗时较长。插件启动后会在本地拉起一个推理服务并监听某个 IP 端口,主程序通过该地址发送文本指令、接收动作数据。这种前后端分离的结构便于单独升级模型,也方便开发者替换成自己的 T2M 模型。
开源生态与未来改进
项目和模型都是开源的,UP主感谢了大肥鱼VM模型的提供者木子恶魔以及爱熬夜的人形兔。模型还有很多可以提高的地方,后续会继续训练,欢迎关注追更。
对于想要尝试的开发者,这个项目提供了一个低门槛的T2M模型落地案例,展示了小参数模型在特定场景下的实用性。无论是桌宠、虚拟主播还是游戏NPC,文本驱动动作的技术都有广阔的应用空间。
相关推荐
Ollama本地部署指南:零基础跑通开源大模型
Ollama本地部署教程:介绍Ollama是什么、为什么选择它,以及如何下载安装、运行开源大模型,并利用API进行个性化开发,适合零基础用户。
n8n:GitHub 187K星的开源自动化神器,把重复工作变工作流
n8n 是一款 GitHub 187K 星的开源可视化工作流自动化引擎,支持 400+ 节点、Webhook/定时/轮询触发,可自托管保障数据安全,还能接入 AI Agent 打造 AI 工作流。本文介绍其核心概念、典型场景与避坑指南。
n8n自托管实战:Docker+PostgreSQL+Caddy部署指南
手把手教你用 Docker Compose 部署 n8n 自托管实例,搭配 PostgreSQL 和 Caddy 自动 HTTPS,含环境变量避坑、网站巡检飞书告警流程、备份升级回滚要点。