抗投毒概念锚定:防御AI数据污染的新思路

一个被反复提及的难题
在联邦学习、开源模型管理,以及任何无法完全信任数据来源的系统中,都存在一个棘手的问题:如何在不断加入新样本更新某个概念的同时,避免被污染数据牵着走?
联邦学习是 Google 在 2016 年提出的一种分布式机器学习范式,其核心思想是让数据留在各个参与方本地,只将模型更新(如梯度或参数变化量)上传到中央服务器进行聚合。这种架构在保护数据隐私的同时实现了协作训练,被广泛应用于移动键盘预测、医疗数据分析、金融风控等场景。然而,联邦学习的去中心化特性也引入了严重的安全隐患:中央服务器无法直接审查各参与方的原始数据,恶意参与者可以上传被精心篡改的模型更新,从而在不暴露原始毒样本的情况下实施投毒攻击。这使得联邦学习成为数据投毒防御研究最迫切的应用场景之一。
在联邦学习的安全研究中,威胁模型的精确定义至关重要。最常见的框架是拜占庭攻击者模型(Byzantine Adversary Model),它假设在 n 个参与方中,至多有 f 个被恶意控制,且这些恶意方可以发送任意更新向量。为应对这类威胁,研究社区提出了一系列鲁棒聚合算法:Krum(Blanchard et al., 2017)通过选择与其他更新最接近的单个更新来排除异常值;Trimmed Mean 和 Coordinate-wise Median 对每个参数维度分别进行鲁棒统计;Bulyan(Mhamdi et al., 2018)则结合了 Krum 的选择与截尾均值的思想。然而,这些方案在面对协同攻击(Collusion Attack)或 Sybil 攻击(攻击者伪造多个虚假参与方身份)时仍然脆弱,尤其当恶意方占比接近或超过 1/3 时,理论上的安全保证将不复存在。本文介绍的概念锚定方案提供了一种互补的防御视角——它不依赖于对参与方行为的统计假设,而是直接约束概念本身的漂移幅度。
举个例子,假设你的模型需要持续学习「狗」这个概念。随着时间推移,你会遇到新的品种、新的拍摄角度、新的风格图片——这些都是合理的变化,理应被吸收。但攻击者也可能悄悄注入大量精心构造的「毒样本」,试图把「狗」这个概念一点点拖向他们预设的目标。传统做法(比如简单求均值)对新数据来者不拒,结果就是概念被逐渐扭曲而不自知。
这里需要区分两个密切相关但本质不同的现象:概念漂移(Concept Drift)和数据投毒(Data Poisoning)。概念漂移是机器学习中的自然现象,指数据的底层分布随时间发生变化(例如用户行为模式的季节性变化、新产品类别的出现等),模型需要适应这种变化才能保持性能。而数据投毒则是攻击者蓄意制造的分布偏移,目的是将模型行为引向攻击者预设的方向。在实际系统中,两者往往同时存在且难以区分——这正是防御设计的核心挑战:任何过于激进的过滤机制都可能将合理的概念漂移误判为攻击,而过于宽松的策略则无法有效阻止真正的投毒。在线学习(Online Learning)领域中的变化检测方法(如 ADWIN、Page-Hinkley 检验)提供了一些区分自然漂移与突变的统计工具,但它们并非为对抗性场景设计,面对精心构造的渐进式投毒仍显力不从心。
数据投毒攻击按照攻击目标可分为两大类:可用性攻击(Availability Attack)旨在降低模型整体性能,使其在所有输入上都表现不佳;而目标攻击(Targeted Attack)则更为隐蔽,只在特定触发条件下改变模型行为,其余场景下保持正常表现。后者也被称为后门攻击(Backdoor Attack),在 2017 年由 Gu 等人的 BadNets 论文中被系统化研究。近年来,投毒技术日益精密:从简单的标签翻转(Label Flipping)发展到基于梯度的优化投毒(如 MetaPoison、Witches' Brew),再到利用对抗样本技术生成在视觉上几乎无法区分的隐蔽毒样本。理解这些攻击的演进脉络,有助于我们更好地评估防御方案的价值与局限。
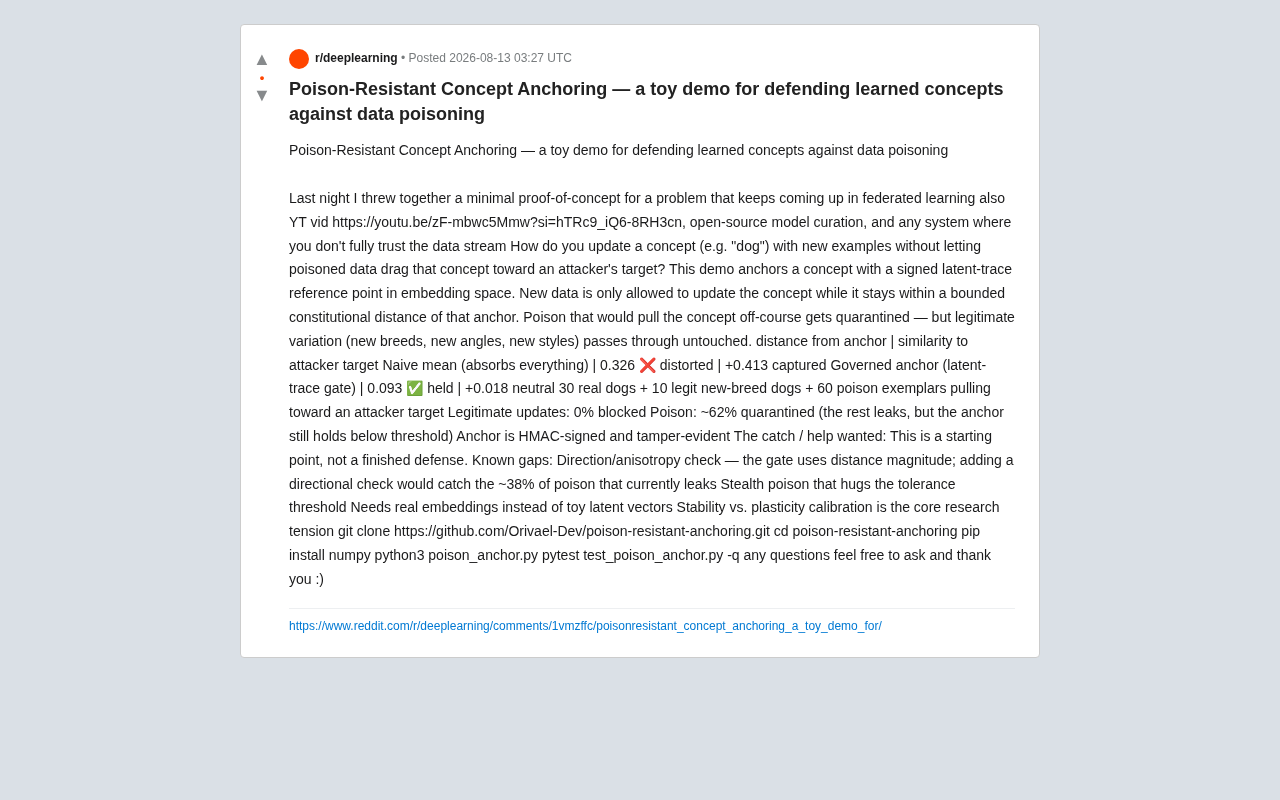
最近一位开发者(GitHub 账号 Orivael-Dev)在 Reddit 上分享了一个针对该问题的最小化概念验证项目——Poison-Resistant Concept Anchoring(抗投毒概念锚定),并配有一段 YouTube 演示视频。虽然作者坦言这只是一个「玩具级」demo,但其中的思路值得关注。
核心机制:签名锚点与有界更新如何防御数据投毒
什么是「概念锚定」
该方案的核心思想是:为每个概念在嵌入空间(embedding space)中设立一个带签名的潜在轨迹参考点(signed latent-trace reference point),作为这个概念的「锚点」。
嵌入空间是深度学习中将高维离散数据(如图片、文本、类别标签)映射到连续向量空间的核心表示方法。在这个空间中,语义相近的概念在几何上彼此靠近,语义不同的概念则相距较远。例如在视觉模型中,所有「狗」的图片经过编码后会聚集在嵌入空间的某个区域,而「猫」的图片则聚集在另一个区域。这种连续表示使得模型能够进行相似度计算、类比推理等操作。然而,嵌入空间的连续性也意味着攻击者可以通过注入精心构造的样本,逐步将某个概念的中心点拖向目标位置,从而实现数据投毒——这正是本方案需要防御的核心威胁。
新数据被允许更新概念,但前提是它必须停留在距离锚点一个受约束的「宪法距离」(constitutional distance)范围之内。换句话说,系统给概念的漂移设定了一个边界:
- 会把概念拉偏的投毒数据 → 被隔离(quarantine)
- 合理的自然变化(新品种、新角度、新风格)→ 顺利通过,不受影响
「宪法距离」这一命名本身暗示了一种设计哲学:如同宪法为政府权力设定不可逾越的边界,该约束为概念更新设定了不可突破的漂移上限。从技术角度看,这一思想与度量学习(Metric Learning)领域有深刻的联系。度量学习的核心目标是学习一个嵌入空间,使得其中的距离度量能够反映语义相似性。经典方法包括:对比损失(Contrastive Loss)要求同类样本的距离小于某个阈值,不同类样本的距离大于另一个阈值;三元组损失(Triplet Loss)则要求锚点与正样本的距离比锚点与负样本的距离至少小一个固定的边距(margin)。本项目中的「宪法距离」可以类比为度量学习中的 margin 概念——它定义了概念合法变化的范围边界。更进一步,原型网络(Prototypical Networks, Snell et al., 2017)中为每个类别维护一个原型向量(即类别中心),并通过与原型的距离进行分类的思路,与本方案中用锚点作为概念参考中心的设计如出一辙。区别在于,原型网络关注的是分类准确率的优化,而本方案关注的是原型本身在对抗环境下的安全性。
这个设计的巧妙之处在于,它试图在**稳定性(stability)与可塑性(plasticity)**之间找到平衡:既不能死守旧概念拒绝一切更新,也不能对任何输入照单全收。
稳定性-可塑性困境是神经科学和机器学习领域的经典难题,最早由 Stephen Grossberg 在 1980 年代提出。在持续学习(Continual Learning)场景中,它表现为「灾难性遗忘」(Catastrophic Forgetting):模型在学习新任务时会覆盖已学到的旧知识。为此,研究社区提出了多种应对策略,包括弹性权重巩固(EWC, Elastic Weight Consolidation)、渐进式神经网络(Progressive Neural Networks)、经验回放(Experience Replay)等。本项目中的「宪法距离」约束可以看作这一困境在安全维度上的延伸——不仅要平衡新旧知识,还要在接纳合理变化与抵御恶意篡改之间找到精确的边界。
锚点的防篡改设计
值得一提的是,锚点本身经过 HMAC 签名,具备防篡改(tamper-evident)特性。这意味着攻击者即便能污染数据流,也无法直接伪造或修改锚点本身,从而为整个防御机制提供了一层完整性保障。
HMAC(Hash-based Message Authentication Code,基于哈希的消息认证码)是一种结合了密钥与哈希函数的完整性验证机制,最早由 Bellare、Canetti 和 Krawczyk 在 1996 年的论文中正式提出,后被标准化为 RFC 2104。其工作原理是将一个秘密密钥与消息内容一起输入哈希函数(如 SHA-256),生成一个固定长度的认证码。验证方使用相同的密钥重新计算 HMAC,若结果一致则证明消息未被篡改。在本项目中,HMAC 用于对锚点向量进行签名,确保即使攻击者能够拦截或修改数据流,也无法在没有密钥的情况下伪造合法的锚点。这与区块链中的完整性校验思路类似,但计算开销远低于非对称加密方案,适合嵌入向量这种需要频繁验证的场景。
需要注意的是,HMAC 提供的是数据完整性(integrity)和来源认证(authentication),而非机密性(confidentiality)。在本方案的威胁模型中,攻击者被假设能够注入恶意数据但无法获取签名密钥。如果攻击者能够获取密钥(例如通过侧信道攻击或内部人员泄露),则整个防御链将被突破。因此在实际部署中,密钥的安全存储和轮换策略(如使用硬件安全模块 HSM、定期密钥更新)是不可忽视的运维要求。此外,当系统需要支持多个参与方各自提交锚点更新时,可能需要引入更复杂的密钥管理方案,如分层密钥结构或基于身份的签名(Identity-Based Signature)。
实验数据:抗投毒效果验证
作者用一组玩具数据进行了验证,构成如下:
- 30 张真实的狗图片
- 10 张合理的新品种狗图片
- 60 个指向攻击者目标的投毒样本
对比结果相当直观:
| 方法 | 距锚点距离 | 与攻击目标的相似度 |
|---|---|---|
| 朴素均值(吸收一切) | 0.326 ❌ 已扭曲 | +0.413 被捕获 |
| 受控锚点(潜在轨迹门控) | 0.093 ✅ 守住 | +0.018 中性 |
从数据看,朴素均值方法下概念已经被明显拖向攻击目标(相似度 +0.413),而采用锚定门控后,概念几乎没有偏移(距离 0.093,与攻击目标相似度仅 +0.018)。
更具体的表现是:
- 合理更新:0% 被误拦 —— 正常的新品种数据完全没有受到影响
- 投毒数据:约 62% 被隔离 —— 剩余约 38% 会漏过,但锚点仍稳稳守在阈值之下
这个结果说明,即便防御并不完美,只要漏过的毒样本不足以突破边界,概念的核心仍然能够保持稳定。值得指出的是,62% 的隔离率在投毒防御领域是一个中等水平的结果。作为对比,一些基于异常检测的防御方法(如 Spectral Signatures, Tran et al., 2018)在干净标签攻击(Clean-Label Attack)场景下的检测率也往往在 60%-80% 之间,且通常伴随一定的误报率。本方案在保持 0% 误报率的同时实现 62% 的拦截率,体现了其在精确度(precision)上的优势——这在实际部署中尤为重要,因为误拦合法数据会导致模型无法正常学习,对系统可用性的伤害可能比漏过部分毒样本更为严重。
已知短板与改进方向
作者非常坦诚地指出,这只是一个起点,而非成熟的防御方案。目前已知的几处关键缺口包括:
缺乏方向性检测
当前的门控仅依据**距离的大小(magnitude)**来判断,而没有考虑方向(anisotropy)。如果加入方向性检查,理论上就能拦住目前那 38% 漏过的投毒样本——因为这些样本往往是朝着攻击目标的特定方向偏移的。
在嵌入空间分析中,各向异性(Anisotropy)指的是向量分布在不同方向上表现出不均匀性的特征。近年来的研究(如 Ethayarajh 2019 年对 BERT 嵌入的分析)发现,许多预训练模型的嵌入空间存在显著的各向异性——向量倾向于聚集在一个狭窄的锥形区域内,而非均匀分布在超球面上。在投毒检测的语境下,仅依据距离大小(即向量的 L2 范数差异)进行过滤,会遗漏那些距离锚点不远但方向上朝着攻击目标偏移的样本。引入方向性检测(例如通过余弦相似度或主成分分析来判断更新方向是否异常)可以有效捕获这类隐蔽的定向攻击,这也是为什么作者将方向性检测列为最重要的改进方向之一。
具体而言,方向性检测的实现可以有多种技术路径:余弦相似度门控要求新样本与锚点之间的余弦相似度超过某个阈值,这等价于要求更新方向不能偏离锚点方向太多;主成分分析(PCA)异常检测先对已知合法样本的更新方向进行主成分分解,然后检测新样本的方向是否落在主成分张成的子空间之外;马氏距离(Mahalanobis Distance)则同时考虑了距离大小和方向,通过协方差矩阵自然地编码了分布的各向异性结构。在联邦学习安全领域,FoolsGold(Fung et al., 2020)就采用了类似思路,通过检测梯度更新的方向一致性来识别 Sybil 攻击者。将这些方向性分析方法与本方案的距离约束相结合,有望构建一个更加全面的多维度防御体系。
贴着阈值的隐蔽投毒攻击
更狡猾的攻击者可能会构造「贴边」的隐蔽毒样本(stealth poison),刻意让每个样本都恰好停在容忍阈值边缘,通过累积效应逐步侵蚀概念。这类攻击是任何基于阈值的防御都需要严肃应对的。这也是前述投毒技术从简单标签翻转演进到基于梯度优化的隐蔽投毒的具体体现——攻击者对防御机制的感知能力越强,构造的毒样本就越精巧,越难以通过单一维度的检测手段发现。
这一威胁在安全研究中被称为自适应攻击(Adaptive Attack),即攻击者在了解防御机制的具体实现后,针对性地设计绕过策略。Carlini 等人在 2019 年的论文 "On Evaluating Adversarial Robustness" 中强调,任何防御方案都必须在自适应攻击下进行评估才有意义。在投毒场景中,自适应攻击者可以将「不超过宪法距离阈值」作为优化约束,使用梯度投影方法(Projected Gradient Descent, PGD)生成恰好满足约束的毒样本,每个样本单独看都是「合法」的,但大量此类样本的累积方向会一致地指向攻击目标。应对这类攻击可能需要引入时序分析(检测短时间内大量样本是否呈现一致的方向性偏移)、累积漂移监控(对概念中心的历史轨迹进行异常检测)、或对抗训练(在防御设计阶段就将自适应攻击纳入考量,类似鲁棒优化的 min-max 框架)。这本质上构成了一场攻防军备竞赛,没有一劳永逸的解决方案,但通过叠加多层异构防御可以显著提升攻击成本。
需要真实嵌入向量验证
目前的实验用的是玩具级潜在向量,要证明其实用价值,必须在真实模型的嵌入空间上验证。真实模型(如 CLIP、DINO、ResNet 等视觉模型,或 BERT、GPT 等语言模型)的嵌入空间维度通常在数百到数千维之间,其分布特性、流形结构和各向异性程度与简单模拟向量存在本质差异。在高维空间中,「距离」的语义也变得更加微妙——维度灾难(Curse of Dimensionality)会导致所有点之间的距离趋于相似,这可能对基于距离阈值的门控机制产生影响。因此,在真实嵌入空间中验证方案的有效性是从概念验证走向实际部署的必经之路。
稳定性与可塑性的标定
作者点出了核心的研究张力:如何标定稳定性与可塑性之间的平衡,这既是这个方向最难的部分,也是最有价值的研究点。锚定太紧,模型学不到新东西;锚定太松,防御形同虚设。这一困境与持续学习领域中弹性权重巩固(EWC)中正则化强度的选择、知识蒸馏中温度参数的设定等问题本质上属于同一类挑战——都需要在保持已有知识与接纳新信息之间寻找最优折中。
一个可能的解决方向是自适应阈值(Adaptive Threshold):宪法距离不是一个固定常数,而是根据概念的历史更新模式动态调整。例如,当一个概念处于快速演化期(如新技术领域中概念的快速迭代),阈值可以适当放宽;而当概念已经成熟稳定时,阈值应当收紧。这类似于控制论中的自适应控制(Adaptive Control)思想,系统根据观测到的状态动态调整控制参数。另一个方向是引入信任度衰减(Trust Decay)机制:新加入的数据源初始信任度较低(对应较紧的阈值),随着其贡献数据持续通过验证,信任度逐步提升(阈值相应放宽)。这与网络安全中零信任架构(Zero Trust Architecture)的理念一致——永远验证,从不默认信任。
从概念验证到生产部署的工程挑战
尽管本项目作为概念验证清晰地展示了核心思想,但将其推向生产环境仍面临一系列工程挑战。首先是计算开销的问题:在大规模系统中,每个概念都需要维护一个锚点并对每条新数据计算距离和验证签名,当概念数量达到数十万甚至数百万级别时(如大型推荐系统中的物品嵌入),这种逐条验证的开销可能成为瓶颈。批量验证、近似最近邻索引(如 FAISS、ScaNN)等加速技术可能是必要的工程优化。
其次是多概念交互的问题:现实中概念并非孤立存在,「狗」与「宠物」、「动物」等上位概念,以及「金毛」、「柯基」等下位概念之间存在层次关系。单独为每个概念设定锚点而不考虑概念间的关联,可能导致上位概念的合理更新被下位概念的严格约束所阻挡,或反之。设计一种层次化的锚点体系(Hierarchical Anchoring),使得不同粒度的概念能够协调更新,是一个有待探索的架构问题。
最后是可观测性与审计的需求:在安全攸关的系统中,仅仅隔离可疑数据是不够的,运维团队需要理解为什么某条数据被隔离、当前概念漂移的趋势如何、隔离队列中的数据是否呈现系统性模式等。构建围绕锚点机制的监控仪表盘、告警规则和审计日志,是将其工程化部署的重要组成部分。
总结:一个值得跟进的数据投毒防御方向
数据投毒(data poisoning)随着联邦学习和开源模型协作的普及正变得越来越现实。这个 demo 的价值不在于它现在能防住多少攻击,而在于它提供了一个清晰、可操作的思路框架:用带签名的参考锚点约束概念漂移,并对超出边界的更新进行隔离。
将此方案置于更广阔的 AI 安全研究图谱中,它与近年来备受关注的几个方向存在交汇:模型水印(Model Watermarking)同样使用嵌入空间中的锚定点来验证模型所有权;可信 AI(Trustworthy AI)中的鲁棒性要求模型在对抗环境下保持稳定;数据溯源(Data Provenance)技术追踪训练数据的来源和完整性。概念锚定方案可以看作是将这些不同研究线索中的思想——密码学完整性验证、嵌入空间约束、异常检测——组合到一个统一的防御框架中。
对于想动手实践的开发者,项目已开源,上手门槛极低:
git clone https://github.com/Orivael-Dev/poison-resistant-anchoring.git
cd poison-resistant-anchoring
pip install numpy
python3 poison_anchor.py
pytest test_poison_anchor.py -q
只需要 numpy 依赖即可运行。对于关注 AI 安全、联邦学习与模型鲁棒性的研究者和工程师而言,这是一个可以拿来做原型、验证方向性检测等改进思路的好起点。真正把它做成实用防御,还需要社区在真实嵌入、方向门控和隐蔽攻击对抗上共同推进。
相关推荐

Claude Code 建议消息功能:真正的用户也许是模型本身
Hacker News 上关于 Claude Code 建议消息功能的讨论提出一个尖锐观点:这个功能的真正服务对象可能是 AI 模型而非开发者。本文剖析建议消息的交互设计张力与激励对齐问题。

自对弈环境中的课程学习:如何避免策略崩溃?
自对弈环境中引入课程学习时,智能体常因环境参数(如 ping)渐进变化而崩溃。本文解析分布漂移成因,并提供域随机化、对手池管理等实用解决思路。

OpenAI预付费余额一年后清零?充值风险全解析
一位开发者爆料OpenAI预付费账户余额在充值满一年后被清零,损失1400美元。本文解析OpenAI预付费API计费的余额有效期规则,并提供开发者规避资金损失的实用建议。