自对弈环境中的课程学习:如何避免策略崩溃?

自对弈与课程学习耦合时,环境参数退火会导致旧模型遭遇分布外输入而崩溃,域随机化是更鲁棒的替代方案。
本文分析了在自对弈训练中引入课程学习时出现的一类典型故障:当环境参数(如网络延迟)做单向退火时,对手池中的早期模型从未见过高难度参数,面对分布外输入时行为崩溃,导致晋级流程卡死。问题根源在于课程变化打破了自对弈的核心假设——对手应能在当前环境分布下给出合理行为。文章提出了四种应对策略:对全体对手池统一课程分布、以域随机化取代单向退火、基于性能指标自适应调节课程节奏,以及维护跨阶段多样化的模型快照。其中,将单向退火改为全程域随机化被认为是成本最低、见效最快的调整,能从源头上确保每个历史模型都具备处理全参数范围输入的能力。
在强化学习领域,自对弈(self-play)是训练竞技型智能体的核心手段之一,从 AlphaGo 到 OpenAI Five 都依赖这一机制。但当研究者试图在自对弈中引入**课程学习(curriculum learning)**时,常会遇到一个棘手的问题:智能体在训练过程中突然崩溃,无法通过晋级(promotion)环节。近期 Reddit 社区的一则讨论精准地描述了这个困境。
问题的核心:环境参数的渐进式变化
原帖作者尝试在训练中对一个竞技机器人的延迟(ping)参数做退火处理——让 ping 值从 0 逐渐增加到 100(具体数值随机选取),并且机器人在对局中能够观测到自己当前的 ping。这是一个典型的课程学习设计思路:从简单条件(低延迟)过渡到困难条件(高延迟),让智能体逐步适应更复杂的环境。
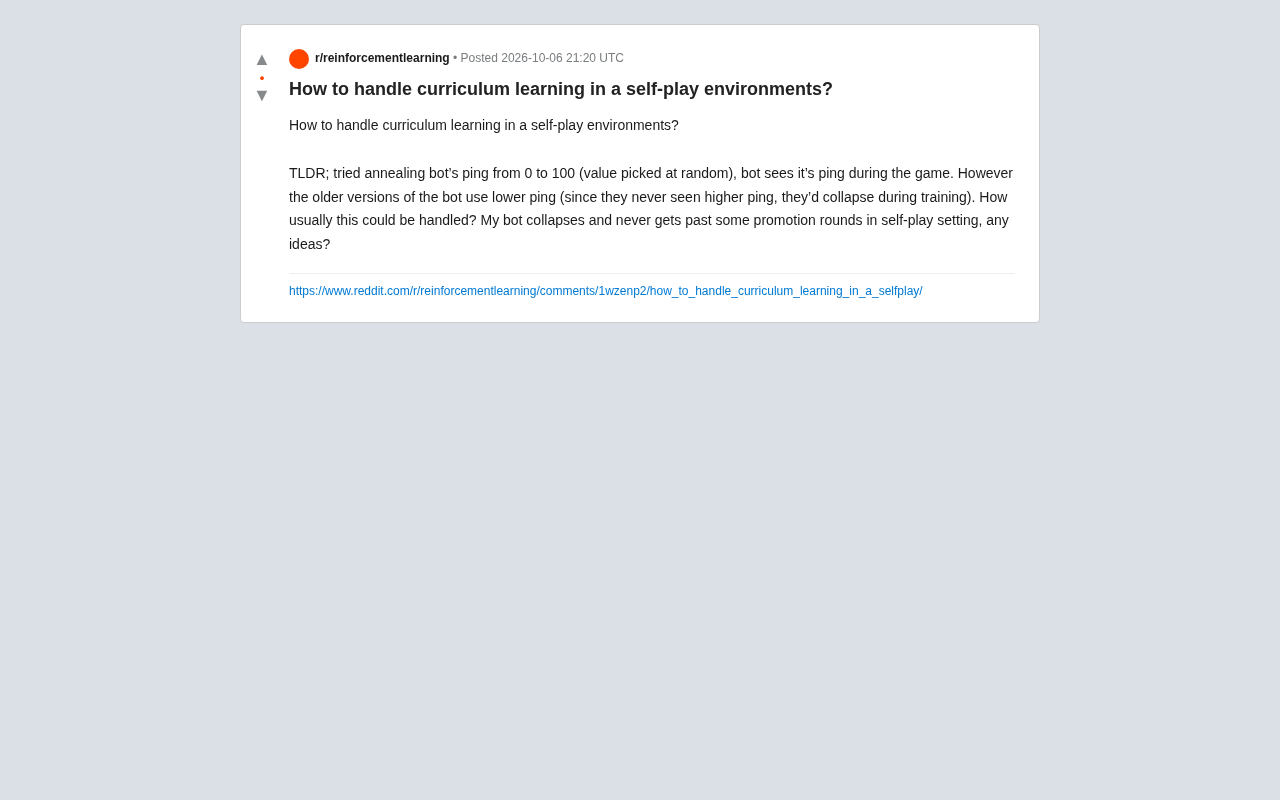
然而问题随之而来。作者发现,旧版本的机器人(即历史对手池中的早期模型)只经历过较低的 ping 值,从未见过高 ping 的场景。当新版本在高延迟条件下训练时,这些旧版本对手在面对它们未曾见过的情况时会直接"崩溃"(collapse),导致整个自对弈的晋级流程卡死在某些阶段,无法继续推进。
为什么会发生崩溃?
理解这个问题需要拆解自对弈与课程学习叠加时的内在矛盾。
对手池的分布漂移
自对弈训练通常维护一个历史模型组成的对手池,新模型需要战胜过去版本才能晋级。这种机制的前提是,对手池中的模型能够在当前环境分布下给出合理的行为。但一旦引入了会变化的环境参数(如 ping 退火),早期模型所处的训练分布与当前分布产生了偏移。那些在低 ping 环境下学成的策略,面对高 ping 时相当于遇到了分布外(out-of-distribution)输入,行为自然失控。
分布漂移(distribution shift)是机器学习中的经典挑战:模型在训练分布上表现良好,但在测试或部署时遭遇不同分布的输入,性能急剧下降。在自对弈场景中,这一问题被进一步放大——每个历史模型本质上都是在特定"时间切片"的环境分布下冻结的产物。当课程参数持续演变时,对手池实际上变成了一个由"过时快照"组成的集合,每个快照对应不同的有效输入范围。这与迁移学习中的协变量偏移(covariate shift)高度相似:输入的边缘分布 P(x) 发生了改变,但模型的条件分布 P(y|x) 仍停留在旧分布的参数化形式上。对于竞技性自对弈而言,这意味着晋级门槛本身失去了有效性——你要求新模型击败一个在当前规则下"失能"的对手,既不能保证新模型真正变强,也无法稳定地推进训练。
观测空间与泛化能力的错配
作者让机器人观测自己的 ping,这本身是合理的——让智能体感知环境条件是适应变化的基础。但如果早期模型在训练时该观测值始终处于一个狭窄区间(接近 0),它的策略网络就从未学会如何响应高 ping 的观测值。这不是智能体"不想"适应,而是它在参数空间里根本没有对应的有效映射。
常见的处理思路
针对这类问题,强化学习实践中积累了若干可借鉴的方案。
对全体训练统一课程
最直接的办法是不要只对新模型施加课程变化,而是确保对手池中的模型也在同样的参数分布下被评估或微调。如果旧模型无法处理高 ping,那么它们就不应该作为当前阶段的有效晋级门槛,或者需要对其进行适当的再训练/适配。
域随机化而非单向退火
与其做从 0 到 100 的单向退火,不如采用域随机化(domain randomization):在训练早期就让 ping 在整个范围内随机采样,而不是循序渐进地提高上限。这样每个版本的模型从一开始就见过各种延迟条件,避免了后期才遇到陌生分布的崩溃风险。虽然这会增加早期训练难度,但能显著提升策略的鲁棒性。
域随机化(domain randomization)最初由 OpenAI 和 Berkeley 的机器人学研究者提出,用于弥合仿真环境(sim)与真实世界(real)之间的差距——通过在仿真中随机化物理参数、纹理、光照等,迫使策略网络学到对这些变量鲁棒的特征表示。其核心逻辑是:如果模型见过足够宽泛的输入分布,真实世界的输入就不再是"分布外"的陌生样本。将这一思路迁移到课程学习中,意味着放弃"先学简单再学困难"的线性假设,转而让模型从训练第一天起就暴露于完整的参数范围。这种方式的代价是早期训练信号更加嘈杂、收敛更慢,但换来的是策略在整个参数空间内均匀分布的泛化能力。对于需要长期维护对手池的自对弈训练来说,这一属性尤为重要——每个历史模型都具备处理全范围输入的能力,对手池的有效性得以贯穿始终。
平滑课程的推进节奏
如果坚持使用退火式课程,关键在于控制推进速度。课程变化过快会让模型来不及适应,过慢又影响效率。一种做法是基于性能指标自适应地调整课程进度——只有当模型在当前难度上达到稳定表现后,才扩大参数范围。
自适应课程(adaptive curriculum)是相对于预定义固定节奏课程的一类方法,其核心思想是用智能体当前的表现作为反馈信号来驱动课程进度,而非依赖固定的训练步数或时间计划。常见实现方式包括:基于成功率阈值的进阶(如胜率稳定超过60%才扩大参数范围)、基于策略梯度信号的难度调节(监控策略熵或价值函数方差),以及利用进步速度(learning progress)作为课程推进的代理指标。后者的理论依据来自内在动机(intrinsic motivation)研究:智能体在能够快速获得进步的难度区间内探索最为高效。对于自对弈与课程学习耦合的场景,自适应课程还需要额外考量对手池中历史模型的适应状态,避免在对手池尚未"跟上"时过快提升当前模型所面对的课程难度。
维护多样化的对手池
对手池的管理也值得优化。可以保留不同课程阶段的模型快照,并在采样对手时兼顾各个阶段,而不是一味地让新模型只对抗最近的版本。这有助于防止训练陷入某种狭窄的策略循环。
给实践者的建议
这则讨论揭示了一个被低估的工程细节:课程学习和自对弈各自都是成熟技术,但二者耦合时会产生意想不到的交互效应。环境参数的动态变化会打破自对弈赖以运作的"对手行为可预测"假设。
对于遇到类似问题的开发者,建议优先尝试将单向退火改为全程域随机化,这通常是成本最低、见效最快的调整。若问题依然存在,再进一步审视对手池的构成与观测空间的设计,确认模型在整个参数范围内都具备有效的策略表征。
需要说明的是,原帖讨论来自社区提问,尚未形成定论性的最佳实践,上述方案更多是基于强化学习通用经验的推断,具体效果仍需结合实际任务验证。
相关推荐

文本+参考音频生成AI音效:现状与可行方案
探讨能否通过文本描述结合参考音频生成AI音效。解析文本到音频、参考音频引导等技术路线,介绍现有工具与组合式工作流方案,帮助开发者和创作者理解音频生成AI的现状与局限。

UniEvo-VL:自蒸馏训练如何让多模态模型自我进化
UniEvo-VL 提出用自蒸馏训练实现多模态模型的自我改进。本文解读自蒸馏在视觉语言模型中的工作机制、潜力与局限,探讨这一自我进化路线能否破解图文数据标注瓶颈。

斯坦福团队软骨再生研究:能否终结关节炎?
斯坦福科学家被报道找到再生软骨、阻止关节炎的方法。本文梳理软骨再生的医学难点、常见研究思路,并对这一突破消息进行理性解读。