科技公司该更懂我:一位用户的逆向隐私宣言

科技公司数据虽多却理解肤浅,问题在于只采行为不究意图。
文章围绕Hacker News热议的一篇博文展开,指出科技公司虽然收集了海量用户数据,却始终未能真正理解用户。核心论点在于:它们采集的是行为数据而非意图数据,因此点击、停留等浅层信号被误读为偏好,导致推荐失准、个性化沦为低级错误。文章进一步讨论隐私悖论——用户并不排斥分享数据,只是当前的数据交换不对等,付出数据换来的体验粗糙。作者主张从被动行为追踪转向主动意图建模,让用户通过显式设置、反馈机制和对话式交互参与个性化过程。最后指出广告驱动的商业模式造成激励错位,使“更懂用户”缺乏商业优先级,并提出应将用户理解本身作为产品目标而非变现副产品。
科技巨头们收集了海量用户数据,却似乎从未真正理解我们。最近,一篇题为《I wish tech companies knew more about me》的文章在Hacker News上引发热议,获得277点积分和247条评论讨论。作者提出了一个反直觉的观点:问题不在于科技公司知道得太多,而在于它们知道得不够深、不够准。
数据丰富,理解贫乏
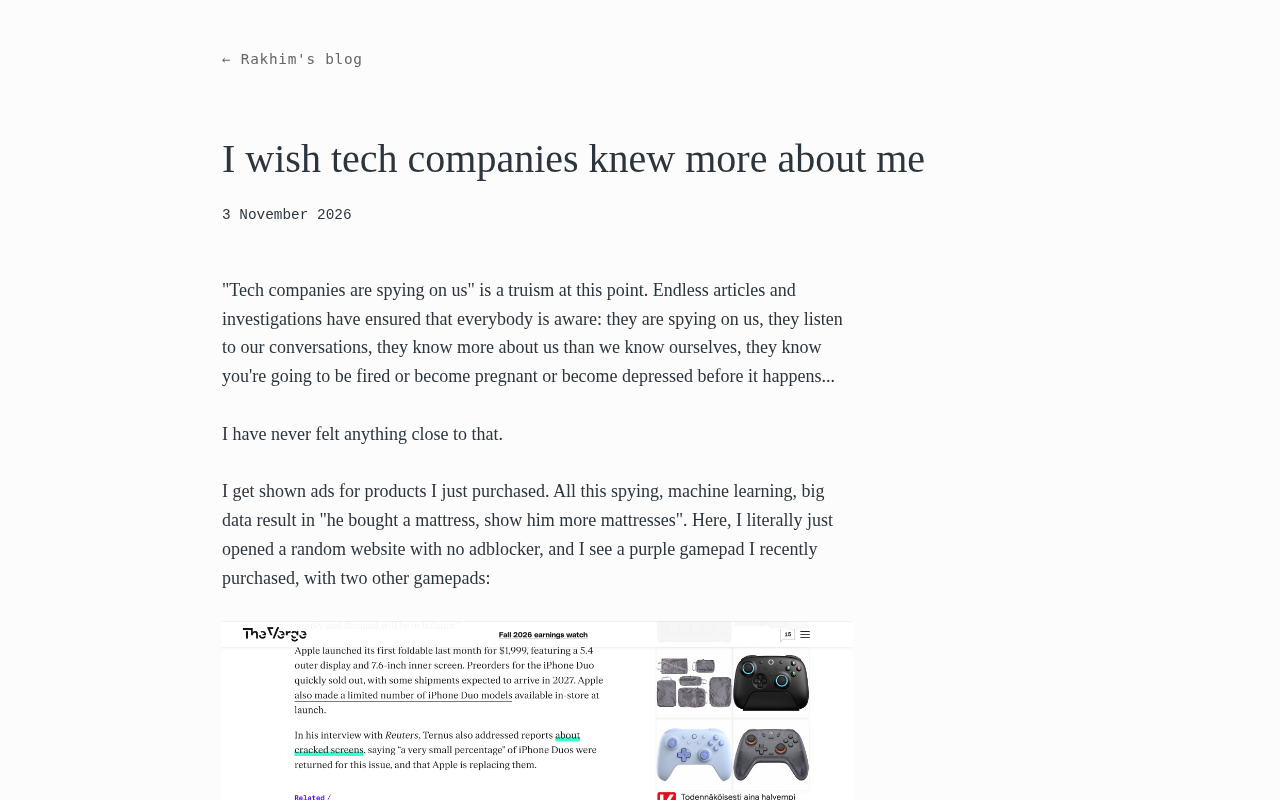
我们生活在一个被数据包裹的时代。每一次点击、每一次停留、每一次滑动都被记录在案。按理说,科技公司应该比任何人都更了解我们的偏好、习惯和需求。但现实是,推荐算法频频失准,广告推送令人困扰,个性化体验往往沦为“重复推荐你刚买过的商品”这类低级错误。
作者的核心洞察在于:科技公司收集的是行为数据,而非意图数据。它们知道你点了什么,却不知道你为什么点;它们记录了你看了多久,却不理解你真正想要什么。这种“浅层数据”的堆积,并不能转化为“深度理解”。
行为追踪的局限性
行为追踪的局限在于它只能捕捉表象。用户点击一条新闻,可能是因为感兴趣,也可能是因为误触,或者只是为了关掉弹窗。算法将这些行为一视同仁地视为“偏好信号”,自然会产生偏差。作者认为,如果科技公司真的想理解用户,就需要更主动地询问、更细致地建模用户意图,而不是仅仅依赖被动采集的行为日志。
行为数据与意图数据的区分
行为数据(behavioral data)是用户与系统交互时留下的可观测痕迹,如点击、滚动、停留时长、购买记录等,属于被动采集的“表层信号”。意图数据(intent data)则描述用户为何采取这些行为——目标、动机、约束条件和期望结果,通常需要主动获取或通过推理建模得到。二者的关键差异在于因果性:行为数据只能揭示相关性,无法说明点击是出于兴趣、误触还是习惯。这也是推荐系统容易陷入“协同过滤陷阱”的原因——它最大化的是行为相似度,而不是意图匹配度。学界与工业界近年提出的“意图理解”“对话式推荐”等方向,正是试图弥补这一缺口。
隐私悖论:用户真正想要的是什么
这一观点触及了一个长期存在的隐私悖论。传统讨论中,用户被描绘成隐私的捍卫者,对数据收集充满警惕。但作者指出,很多用户并不介意分享信息——前提是分享能带来真正的价值。如果科技公司能够用数据提供精准、有用的服务,用户是愿意让渡部分隐私的。
问题在于,当前的数据交换是不对等的。用户付出了数据,换来的却是粗糙的、甚至令人反感的体验。作者呼吁科技公司重新思考数据收集的目的:不是为了堆砌用户画像,而是为了建立真正的理解。
从“知道更多”到“理解更深”
这引出了一个关键转变:从追求数据量的“知道更多”,转向追求数据质量的“理解更深”。作者建议,科技公司应该让用户主动参与个性化过程,例如通过显式偏好设置、反馈机制和对话式交互,让用户告诉系统自己真正想要什么。这种“用户主动表达”的模式,比被动行为追踪更能建立准确的用户模型。
隐私悖论(Privacy Paradox)
隐私悖论指用户口头上高度重视隐私,实际行为中却常常主动让渡个人信息,例如随意授权应用权限、接受Cookie追踪、在社交平台披露大量私人细节。这一概念最早由学者在电子商务与在线行为研究中系统讨论,后续被用于解释“隐私态度—隐私行为”之间的落差。常见解释包括:隐私成本被即时便利所掩盖、用户对数据流向缺乏可见性、以及“反正已经被收集了”的无力感。对本案例的意义在于,隐私悖论说明用户并非一味拒绝数据共享,而是在评估交换是否划算。当企业把数据用于提升可用性时,悖论可以被缓解;当数据只服务于广告变现时,悖论就会转化为不信任。
产品设计的启示
对于产品设计者而言,这篇文章提出了一个值得深思的命题:个性化不应该只是算法的黑箱操作,而应该成为用户可感知、可控制、可参与的透明过程。当用户能够理解系统为何做出某个推荐,并能够轻松纠正偏差时,数据收集与隐私让渡才具有正当性。
Hacker News上的讨论也反映了这一共识:许多评论者认同,当前科技公司的“了解用户”更多是营销话术,实际的产品体验远未达到真正个性化的水平。有评论指出,科技公司更擅长利用数据优化广告变现,而非优化用户体验——这或许才是问题的根源。
失衡的激励结构
这种失衡的激励结构,使得“更懂用户”在商业上缺乏优先级。广告驱动的商业模式要求的是更高的点击率和停留时长,而非更精准的用户意图匹配。作者的观点实际上是在呼吁一种范式转变:将用户理解本身作为产品目标,而非变现手段的副产品。
广告驱动商业模式与激励错位
大多数消费级科技公司的收入来自广告,其计价基础通常是曝光量、点击率和转化率。这决定了产品优化的目标函数是“延长使用时长、增加可广告库存、提高点击倾向”,而非“准确满足用户意图”。当用户意图与商业目标一致时,个性化体验看起来很好;一旦二者冲突,系统更倾向于推送能带来点击的内容,而非用户真正想要的结果。这种激励错位解释了为什么“更懂用户”在路线图上优先级不高——精准理解并不直接转化为广告收入。要改变这一点,需要调整考核指标(如以任务完成率、用户留存质量替代点击率),或引入订阅制等不依赖广告的变现方式。
编辑点评
这篇文章之所以引发共鸣,是因为它戳破了一个被反复宣传的幻象:数据多不等于理解深。科技公司拥有前所未有的数据采集能力,却在理解用户意图方面进展缓慢。真正的个性化,需要从被动追踪转向主动对话,从行为记录转向意图建模。对于AI产品而言,这一启示尤为重要——大模型时代,理解用户意图的能力,或许比数据规模更能定义产品价值。
原文链接:https://rakhim.exotext.com/i-wish-tech-companies-knew-more-about-me
相关推荐

Ollama选模型完全指南:从配置到量化避坑
Ollama选模型完全指南:从查看电脑配置到逛官方模型库,详解Tools、Thinking、Vision、Decision等标签含义,以及参数规模、量化精度与上下文缓存的取舍策略,助你避开卡死闪退的坑。

Ollama默认安全吗?显卡被白嫖的真相与自查指南
Ollama 默认只绑回环地址,但改一句环境变量或照抄 Docker 命令就可能让显卡暴露。本文解析显卡被白嫖的原理、扫描规模与 DNS 重绑定路径,并给出自查与修复的三层方案。

Cherry Studio+MCP实战:搭建自动化AI智能体与本地知识库
基于B站Cherry Studio教程,详解如何配置MCP环境、搭建网页抓取与报告生成等自动化AI智能体,并用Ollama+千问3搭建本地知识库,附实际操作中的踩坑经验。