克里普克挑战「意义即使用」:大模型评估需要重思

克里普克式规则遵循挑战动摇「意义即使用」,要求NLP评估转向抽象与递归能力。
文章借助克里普克对维特根斯坦的解读,指出大型语言模型所依赖的「意义即使用」观点面临规则遵循难题:有限的使用历史无法唯一确定未来扩展的规则,因此模型在分布内表现完美也不能保证掌握正确概念。这一挑战重构了OOD泛化讨论,将焦点从统计性能差距转向模型是否在原则性领域扩展下保持规则一致。作者批评现有NLP评估依赖固定用例性能和局部鲁棒性测试,认为二者均不足以确立语义能力,并提议评估抽象与递归两种核心能力,同时给出实验范式。尽管该范式尚待验证,论文将哲学讨论转化为可操作的评估议题,提示基准设计需重新审视其底层假设。
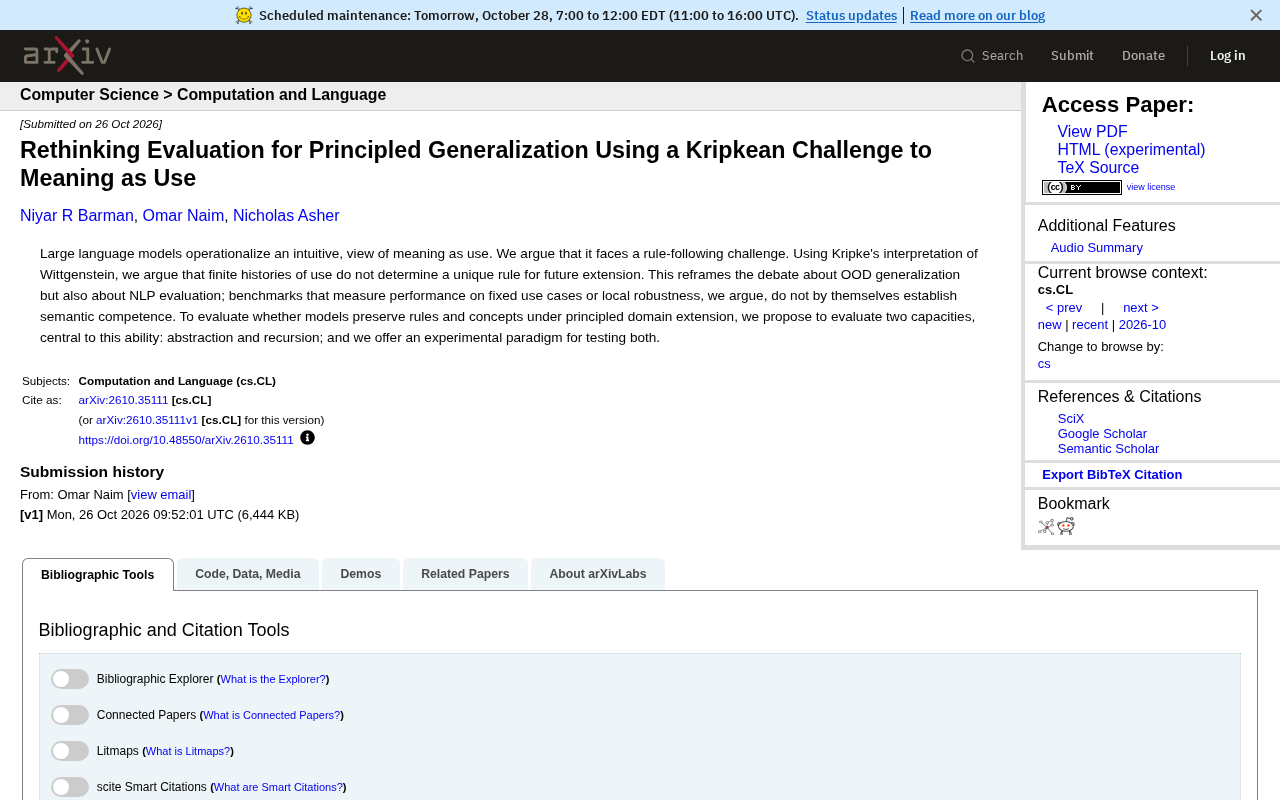
大型语言模型通常被理解为遵循「意义即使用」的直觉观点:一个词的含义由它在语料中的使用模式决定。然而,一篇最新论文借助克里普克对维特根斯坦的解读,指出这一观点面临「规则遵循」难题——有限的使用历史无法唯一确定未来扩展的规则。这一挑战不仅重新框定了分布外(OOD)泛化的讨论,也对当前NLP评估范式提出了根本性质疑。
「意义即使用」的直观与裂痕
论文开篇指出,大型语言模型在操作层面实践了一种直观的「意义即使用」观点:模型通过海量文本学习词语和概念的使用模式,并以此生成回应。这种观点在工程上非常成功,但它隐含一个假设——使用模式足以决定意义。
作者借助克里普克对维特根斯坦的解读,指出该假设存在一个根本裂痕:任何有限的使用历史都可以被无限多种规则解释,而这些规则对未来用法的延伸各不相同。换句话说,过去的使用方式不能唯一锁定未来的正确用法。对于语言模型而言,这意味着即使模型在训练分布内表现完美,也不能保证它掌握了正确的规则或概念。
克里普克对维特根斯坦的解读是理解全文论证的关键背景。在《哲学研究》中,维特根斯坦提出“规则遵循”悖论:任何有限的行为序列都可以被无限多种规则所解释,因此不存在一个“事实”能决定我们未来应当如何继续。克里普克在《维特根斯坦论规则与私人语言》中将这一悖论激进化,提出所谓“克里普克式怀疑论”:如果过去的用法总是可以被不同规则兼容,那么“正确地”遵循规则就没有客观基础,意义本身似乎变得不可确定。克里普克给出的“怀疑论解决方案”诉诸共同体的一致同意,而非个体内在事实。论文正是借用这一框架指出:语言模型从有限语料中归纳出的“使用模式”并不能唯一锁定其未来的语义延伸,因此“意义即使用”在原则上面临不确定性,而不仅仅是数据覆盖不足的问题。
规则遵循难题如何重构OOD泛化讨论
传统的OOD泛化讨论通常关注模型在分布偏移下的性能下降,并试图通过更好的正则化、数据增强或架构设计来缩小差距。但论文认为,克里普克式挑战将问题引向更深的层面:模型是否在原则性(principled)地扩展规则,而不仅仅是拟合局部模式。
如果有限历史不能决定唯一规则,那么模型在OOD场景下的成功或失败就不能简单归因于「泛化能力不足」,而可能涉及规则选择的不确定性。这要求评估方法从「在固定用例上的表现」转向「在原则性领域扩展下是否保持规则和概念一致」。
分布外(OOD)泛化是机器学习中的标准概念,指模型在训练分布与测试分布不一致时的性能表现。传统研究通常将OOD失败归因于分布偏移导致的统计不匹配,并发展出领域泛化、不变风险最小化、数据增强等方法。然而,这些方法默认存在一个“正确”的泛化规则可供学习。克里普克式挑战则指出,有限训练数据可能对应无限多种同样拟合数据但外推行为不同的规则,因此OOD成功与否不仅取决于统计泛化能力,还取决于模型“选择”了哪条规则。这一视角将OOD评估从性能指标问题提升为语义确定性问題:我们需要判断模型是否在原则性扩展下保持规则一致性,而非仅仅比较分布内外的准确率差距。
现有基准的局限:固定用例与局部鲁棒性
论文明确批评了当前NLP评估的两个常见做法:一是测量模型在固定用例上的性能,二是测试局部鲁棒性。作者认为,这两类评估本身不足以确立语义能力。
固定用例上的高分可能只反映模型对特定使用模式的记忆或插值,而局部鲁棒性测试通常只扰动输入的表面形式,不触及规则层面的延伸。二者都无法回答一个关键问题:当领域被原则性地扩展时,模型是否仍然遵循同样的规则和概念?
局部鲁棒性测试通常指对输入施加微小扰动(如字符替换、同义词替换、句式改写)并观察模型输出是否稳定。这类测试能揭示模型对表面变化的敏感性,但其扰动范围局限于输入空间,不涉及规则层面的延伸。例如,一个模型可能在所有拼写变体上表现稳定,却无法将同一概念原则性地应用于全新领域。论文因此区分了“表面鲁棒性”与“规则一致性”:前者可以通过数据增强提升,后者要求模型在领域扩展时保持概念结构不变。这一区分对基准设计有直接含义——仅靠扰动测试无法验证语义能力,需要设计探测规则延伸的实验范式。
提议评估两种核心能力:抽象与递归
为回应上述挑战,论文提出评估两种对原则性扩展至关重要的能力:抽象(abstraction)和递归(recursion)。抽象使模型能够从具体用例中提取规则,递归则使规则能够被迭代地应用于新情境。
作者还提供了一个实验范式,用于同时测试这两种能力。虽然原文摘要未披露具体实验细节,但这一框架的提出本身已经指向一个方向:评估不应停留在输入输出层面的匹配,而应探测模型是否在规则层面保持一致性。
抽象在认知科学与机器学习中有不同侧重。在论文语境下,抽象指从具体用例中提取可复用规则的能力,即忽略表面差异、保留结构不变量的过程。递归则指将已提取的规则迭代应用于新情境的能力,包括将规则应用于自身输出或嵌套结构。二者结合构成“原则性扩展”的核心:抽象提供规则,递归保证规则可被反复延伸。这一框架与心理语言学中的“规则与相似性”之争相呼应——如果模型仅依赖相似性插值,则在需要递归延伸的新领域会失败;若具备抽象与递归能力,则能在规则层面保持一致。论文提议的实验范式正是试图分离这两种能力,从而判断模型是在“使用规则”还是在“拟合模式”。
对NLP评估实践的启示
这项工作的价值在于将哲学层面的规则遵循讨论转化为可操作的评估议题。对于构建和评测语言模型的研究者而言,它提示我们重新审视基准设计的底层假设:一个在固定测试集上表现优异的模型,未必具备语义能力;真正的原则性泛化要求模型在领域扩展时保持规则和概念的不变性。
当然,抽象与递归的评估范式仍处于提议阶段,其实际可行性和区分度有待后续实验验证。但论文提出的问题足够尖锐——如果「意义即使用」无法支撑语义能力的判定,那么NLP评估需要新的理论基础。
相关推荐
思科高管:不用AI就守不住安全,漏洞利用窗口仅八九分钟
思科安全负责人 Jeetu Patel 指出,漏洞公布到被利用仅八九分钟、平均补丁周期约 45 天、仅 20% 漏洞被修补,攻防速度差已让静态安全策略失效。他主张安全控制与策略必须智能体化、动态化,并以 OpenAI 作为底层基础支撑这一转向。
Jev AI的校准概率:输出0.8意味着80%正确率
Jev AI 的核心特性是校准概率:输出0.8意味着约80%的正确率。这种可测量的置信度让开发者能在真实代码库中自信使用 Jev,并为阈值设定和工程决策提供可解释的依据。
30行Python自建MCP服务器并接入Claude Code
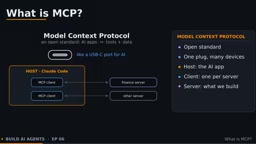
用约30行Python把财务工具封装成MCP服务器,并通过stdio传输接入Claude Code。本文拆解MCP的三种角色与Tools、Resources、Prompts三类能力,讲解装饰器与类型提示的用法、MCP Inspector自测流程,以及claude mcp add的命令格式与作用域设置。