Kimi-K2.5开源:月之暗面最强模型来了,GitHub星标飙升

月之暗面开源旗舰模型Kimi-K2.5,加入国产开源大模型竞争格局
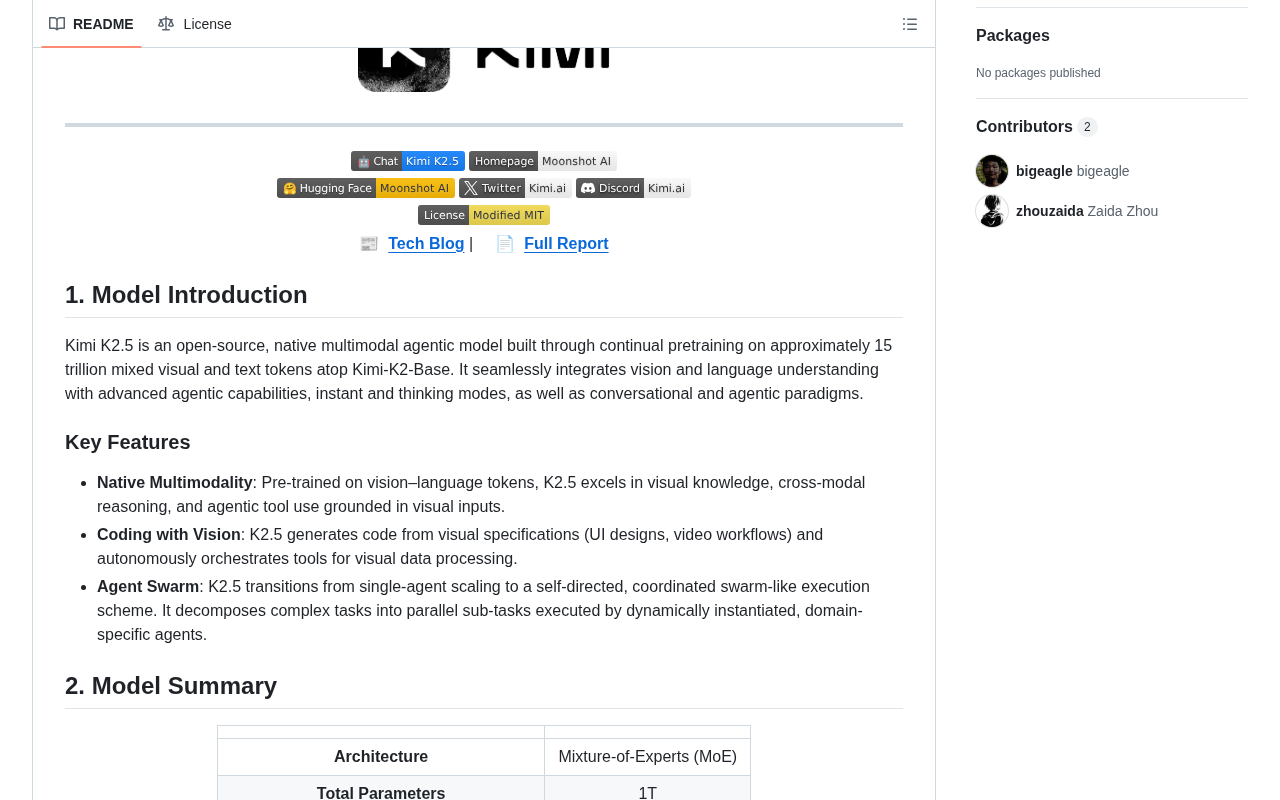
月之暗面在GitHub开源其最强模型Kimi-K2.5,短时间内获得近2000颗Star,标志着其从封闭API服务转向开放生态的战略转变。该模型采用MoE架构,兼顾模型容量与推理效率,以长文本处理为核心优势,与DeepSeek、Qwen、GLM等形成多元竞争格局,为开发者提供了高质量基座模型新选项。
概述
月之暗面(Moonshot AI)近日在GitHub上正式开源了旗舰模型 Kimi-K2.5,官方将其定位为"Moonshot's most powerful model"。项目上线后热度飙升,短时间内收获超过1900颗Star和240个Fork,在国产开源大模型中表现相当亮眼。
Kimi-K2.5开源的战略意义
月之暗面为什么要走开源路线
月之暗面是国内AI大模型赛道的头部玩家之一,此前主要通过Kimi智能助手面向C端用户。Kimi凭借出色的长文本处理能力,在国内市场积累了大量忠实用户。此次开源Kimi-K2.5,意味着月之暗面的技术路线发生了重要转变——从封闭的API服务走向开放的模型生态。
月之暗面由前清华大学教授杨植麟于2023年创立,公司名称取自Pink Floyd的经典专辑《The Dark Side of the Moon》,寓意探索未知。杨植麟在自然语言处理领域有深厚的学术积累,曾参与Transformer-XL和XLNet等重要模型的研发工作——这些模型在处理长序列文本方面具有开创性贡献,也为后来Kimi在长文本处理上的技术优势奠定了基础。公司成立后迅速获得资本市场青睐,估值一度超过30亿美元,成为国内AI独角兽企业。其核心产品Kimi智能助手最初以支持20万字超长文本输入为卖点切入市场,这在当时远超ChatGPT等竞品的上下文窗口限制,精准击中了用户阅读长文档、分析论文等高频需求。
这一动作与全球AI行业的开源大势高度吻合。AI大模型的开源运动可以追溯到2023年Meta发布Llama系列模型。在此之前,OpenAI的GPT系列和Google的PaLM等顶级模型均采用闭源策略,仅通过API对外提供服务。Meta的开源举措打破了这一格局,证明了开源模型在性能上可以逼近甚至匹敌闭源模型。开源策略的商业逻辑在于:通过免费开放模型权重吸引大量开发者使用和改进,形成围绕自身技术栈的生态系统,进而在云服务、企业解决方案、技术咨询等环节实现商业变现。这种"以开放换生态"的策略在软件行业有成熟先例,如Linux操作系统和Android移动平台。
Meta的Llama系列、阿里的Qwen系列、DeepSeek广告等头部团队都在通过开源策略扩大技术影响力、吸引开发者。月之暗面选择在这个节点放出"最强模型",目标很明确:在开源大模型的版图中拿下自己的位置。
从K2到K2.5:不只是小版本升级
"K2"取自世界第二高峰乔戈里峰的代号,寓意攀登技术高峰。而".5"的版本号在业界通常代表架构或核心能力的显著增强,而非简单的参数微调。从命名逻辑推断,Kimi-K2.5相比前代应该有实质性的能力跃升。
从技术架构层面来看,Kimi-K2系列采用了混合专家模型(Mixture of Experts, MoE)架构,这是当前大模型领域最重要的技术趋势之一。MoE的核心思想是将模型参数分成多个"专家"子网络,每次推理时只激活其中一部分专家来处理输入,而非让所有参数都参与计算。这意味着模型可以拥有极大的总参数量(从而具备强大的知识容量),但实际推理时的计算成本远低于同等参数规模的稠密模型。例如,一个总参数量为万亿级别的MoE模型,实际每次推理可能只激活其中几百亿参数。Google的Switch Transformer是MoE架构的早期代表,而Mixtral、DeepSeek-V3等模型则将这一架构推向了实用化。Kimi-K2.5在K2的MoE基础上进一步优化,有望在模型容量与推理效率之间取得更好的平衡。
社区反响与GitHub数据
星标增长速度说明了什么
截至目前,Kimi-K2.5在GitHub上的核心数据如下:
- 1935 Stars:反映开发者社区对该模型的高度关注
- 240 Forks:说明已有大量开发者着手基于该模型做二次开发和实验
这个增长速度在国产大模型开源项目中相当突出,背后是月之暗面的品牌号召力与模型本身实力的双重驱动。
Kimi-K2.5 vs DeepSeek vs Qwen:国产开源大模型怎么选
当前国内开源大模型赛道竞争激烈,Kimi-K2.5的加入让格局更加多元:
| 模型 | 核心优势 | 适用场景 |
|---|---|---|
| DeepSeek | 高性价比、强推理能力,V3和R1系列社区影响力大 | 推理密集型任务、性价比优先 |
| Qwen(通义千问广告) | 阿里持续迭代,工具链和生态完善 | 企业级应用、多模态场景 |
| GLM(智谱) | 清华系背景,学术积累深厚 | 学术研究、中文理解 |
| Kimi-K2.5 | 长文本处理见长,MoE架构兼顾容量与效率,自带Kimi品牌用户认知 | 长文档分析、内容生成 |
每个模型都有独特的技术特点,开发者可以根据实际需求选择最合适的基座模型。
开发者如何上手Kimi-K2.5
开源带来的实际价值
Kimi-K2.5的开源为开发者提供了一个高质量的基座模型新选项,具体来说:
- 模型选型更灵活:可以在更多候选模型中跑基准测试、做横向对比
- 微调与领域适配:基于Kimi-K2.5针对特定行业或任务做精调
- 私有化部署:满足数据安全和合规要求,支持本地化运行
评估Kimi-K2.5时重点关注什么
如果你打算尝试Kimi-K2.5,建议优先了解以下几点:
-
参数规模与架构设计:直接影响部署成本和推理速度。对于采用MoE架构的模型,需要区分总参数量和激活参数量——前者决定模型加载时的显存占用,后者决定实际推理时的计算开销。
-
上下文窗口长度:月之暗面在长文本处理方面一直有技术积累,这可能是K2.5的核心卖点。长上下文能力的实现依赖于位置编码的外推能力(如RoPE的频率调整)和高效的注意力机制设计,但更长的上下文也意味着推理时KV Cache占用的显存会线性增长。
-
主流Benchmark表现:MMLU(Massive Multitask Language Understanding)涵盖57个学科领域的选择题,从高中数学到专业法律、医学知识,用于衡量模型的广泛知识储备和推理能力,满分100分,当前顶级模型的得分已超过90分。HumanEval则专注于代码生成能力评测,包含164个Python编程题,要求模型根据函数签名和文档字符串生成正确的代码实现。除此之外,业界还常用MATH(数学推理)、GSM8K(小学数学应用题)、ARC(科学推理)、BBH(复杂推理)等基准来全面评估模型能力。值得注意的是,单一Benchmark的分数并不能完全反映模型的实际使用体验,开发者在选型时应结合自身业务场景进行针对性测试。
-
推理效率与显存需求:决定了实际部署的硬件门槛。大模型的私有化部署面临显著的硬件挑战——以当前主流模型为例,一个70亿参数的模型在FP16精度下需要约14GB显存仅用于加载模型权重,而推理过程中的KV Cache(键值缓存,用于存储注意力机制的中间计算结果以加速自回归生成)会额外占用大量显存,尤其在长上下文场景下增长更为显著。对于百亿甚至千亿参数级别的模型,通常需要多张高端GPU(如NVIDIA A100/H100)通过张量并行或流水线并行技术协同工作。为降低部署门槛,业界广泛采用量化技术(如GPTQ、AWQ、GGUF等格式),将模型权重从FP16压缩到INT8甚至INT4精度,可将显存需求降低2-4倍,但可能带来一定的精度损失。vLLM、TensorRT-LLM等推理框架则通过PagedAttention等技术优化显存管理和吞吐量。
-
开源协议与商用条款:关系到能否用于商业项目。大模型的开源协议直接决定了开发者和企业的使用边界。目前业界常见的协议差异显著:Apache 2.0是最宽松的协议之一,允许自由使用、修改和商业化,Qwen系列和部分DeepSeek模型采用此协议;Meta的Llama系列使用自定义的Llama Community License,对月活超过7亿的企业有额外限制;部分模型则采用非商业许可证,仅允许学术研究使用。还有一些模型采用"社区许可证"模式,免费用户有一定限制,商业使用需要单独申请授权。开发者在评估Kimi-K2.5时,务必仔细阅读其LICENSE文件,确认是否允许商业使用、是否有参数规模或营收门槛限制、是否要求署名或开源衍生作品等条款。
总结
Kimi-K2.5的开源是月之暗面在技术开放战略上的关键一步。在国内大模型竞争白热化的当下,开源既是技术实力的亮牌,也是构建开发者生态的核心手段。随着社区深入评测和更多技术细节的披露,Kimi-K2.5在开源大模型版图中的真实定位会逐渐清晰。
对开发者而言,更多高质量开源模型的涌现意味着更多选择、更低门槛。无论最终是否采用Kimi-K2.5,它的出现都在推动整个行业向更开放、更普惠的方向演进。
核心要点
- 月之暗面在GitHub开源其最强模型Kimi-K2.5,短时间内获得1935 Stars和240 Forks
- Kimi-K2.5的开源标志着月之暗面从封闭API服务走向开放模型生态的战略转变
- 该模型采用MoE(混合专家)架构,在模型容量与推理效率之间取得平衡
- 该模型加入了DeepSeek、Qwen、GLM等组成的国内开源大模型竞争格局
- 开源为开发者提供了更多基座模型选择,支持微调定制和私有化部署
- 开发者在选型时需综合考量Benchmark表现、部署成本、开源协议等多维因素
- 更多高质量开源模型的涌现将加速AI技术的普惠化进程
相关推荐
 科技前沿
In the Weights:查看你在AI领域的影响力权重分数
In the Weights 是一个AI领域个人影响力搜索引擎,通过量化评分衡量你在人工智能世界中的存在感。了解这个工具如何评估AI从业者的多维度影响力,以及它背后关于数字身份的深层思考。
 科技前沿
AI行业罕见平静日:递归自我改进暗流涌动
AI领域迎来罕见的平静一天,多个资讯源集体沉默。但平静背后,递归自我改进(RSI)研究仍在持续推进。解读AI行业发展节奏与从业者应对策略。
 科技前沿
AI行业难得的平静日:信息过载时代的冷思考
当AI行业迎来罕见的平静一天,从业者该如何应对?本文从AINews简报出发,探讨高速发展中的喘息节奏、信息疲劳与内容价值的平衡,以及如何利用平静期进行技术深耕和战略思考。