Kimi K3.1 Pro开源3万亿参数实测:硬盘当内存跑大模型

Kimi K3.1 Pro 以 3 万亿参数开源,实测硬盘兜底可跑、API 模式流畅生成。
Kimi K3.1 Pro 正式开源,总参数约 3 万亿,定位为原生多模态智能体模型,在编码、3D 创建、游戏开发等任务上处于开源模型第一梯队。B站UP主「零度解说」用 Local Model 工具做了本地部署实测:下载 550 多 G 的量化模型(14 个分片),在显存和内存都不足的情况下将模型分层放到硬盘上,生成速度仅每秒约 0.1 token,但仍能正常输出。切换到 API 接入后,输出速度达到每秒 140 多个 token,可完成动画自我介绍、交互式微观世界网页、3D 台球游戏和涡扇发动机拆解模型等复杂任务。平台还支持图片、视频、语音等开源模型,均可离线断网使用。文章认为,这展示了开源生态从权重开放到离线工具链的完整闭环。
Kimi K3.1 Pro 的正式开源,把开源大模型的参数规模推到了一个全新的量级——总参数约 3 万亿,官方定位为原生多模态智能体模型。B站UP主「零度解说」第一时间做了本地部署实测,用一台显存和内存都不够用的机器,硬是把模型跑了起来。这篇文章结合他的实测过程,聊聊这次开源到底意味着什么,以及普通用户现在能怎么用上它。
3万亿参数的开源模型,到底强在哪
据零度解说的介绍,Kimi K3.1 Pro 是迄今为止最强的开源大模型之一,采用原生多模态架构,在编码、3D 创建、金融研究、游戏开发以及其他智能体任务上,表现处于开源模型的第一梯队。
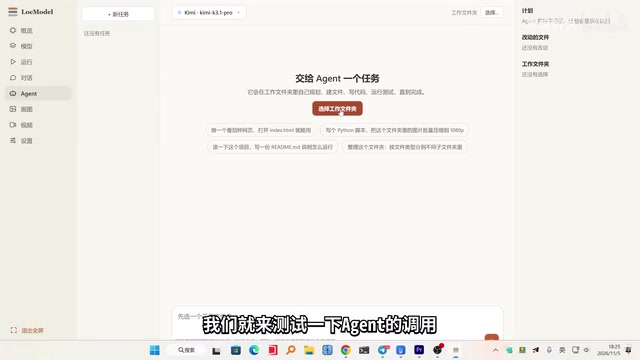
「原生多模态」和「智能体模型」这两个定语值得拆开看。前者意味着模型从训练阶段就融合了多种模态能力,而不是后期拼接;后者意味着它被设计成能够调用工具、执行多步骤任务的形态。实测中 UP 主让它调用 Agent 在本机创建游戏项目、生成 3D 台球游戏和涡扇发动机模型,正是这类能力的直接体现。
对开源社区来说,3 万亿参数的意义不只是「大」。它说明顶级闭源模型和开源模型之间的参数鸿沟正在快速收窄,而权重开放意味着企业和研究者可以在自己的环境中做微调、做私有化部署,这是 API 调用给不了的东西。
MoE(混合专家)架构是理解「3万亿参数」这个数字的关键。传统稠密模型在推理时每个 token 都要激活全部参数,而 MoE 把模型拆成许多「专家」子网络,配合一个路由网络,每个 token 只激活其中少数几个专家。因此,总参数 3 万亿不等于每次推理都要算 3 万亿次——实际计算量远小于总参数规模。这也是文章后面说模型能被「强行分层放到硬盘上」的原因:MoE 的激活稀疏性让超大模型有了在有限硬件上运行的可能。不过,MoE 对显存/内存的要求仍然很高,因为所有专家的权重都必须能被加载,只是计算时不会全部同时参与。
本地部署实测:显存不够,硬盘来凑
这次实测最有意思的部分,是「作死」式的本地部署。UP 主使用的工具是免费的 Local Model 本地模型下载器,支持 Windows、Mac 和 Linux,安装后会根据显卡类型(N卡、A卡、I卡)自动安装对应的推理引擎,省去手动配置环境的麻烦。
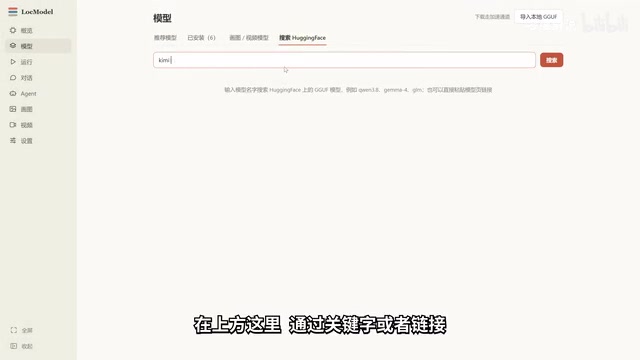
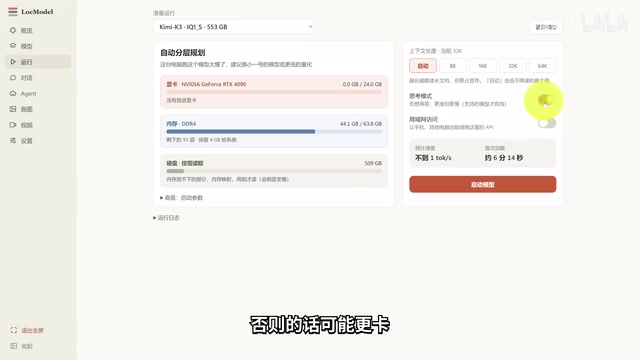
工具会根据硬件给出推荐配置:优先把模型加载到显卡显存,显存不够就转入内存,内存也不够时用硬盘兜底。UP 主下载的是 550 多 G 的 Kimi K3 量化版本,共 14 个模型分片文件,全部下载后放入同一文件夹,通过「导入本地 GGUF 格式模型」功能载入。
由于显存和内存都不足以容纳这个规模的 MoE 混合架构专家模型,模型被强行分层放到了硬盘上。1TB 的硬盘容量够用,但速度成了瓶颈——UP 主形容加载速度「一秒可能不到 1TB」,生成速度约为每秒 0.1 个 token 级别,慢到只能一个字一个字往外蹦。
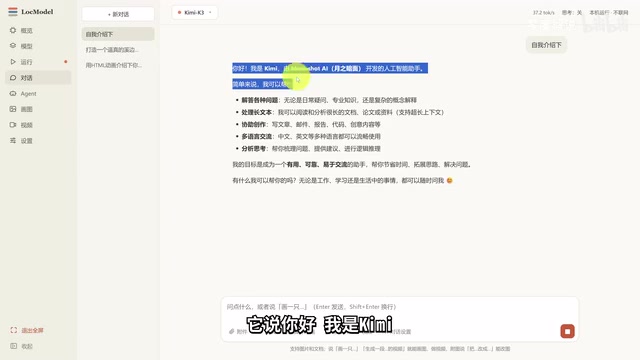
即便如此,模型最终还是输出了完整的自我介绍:「你好,我是 Kimi,由月之暗面开发的人工智能助手。」用 UP 主的话说,只要它能蹦出一个字就算赢了。这个结果的实际意义在于:超大模型的门槛不再被显存卡死,硬盘容量足够大的机器也能跑起来,只是速度要做出妥协。
GGUF 是 llama.cpp 项目推出的一种模型文件格式,专为在消费级硬件上高效推理而设计。它的核心特点是:支持多种量化精度(如 Q4、Q5、Q8),把模型权重压缩到更小的体积;同时把模型元数据、分词器信息和权重打包进单一文件,方便分发和加载。文章提到的「550 多 G 的量化版本」「14 个模型分片文件」,就是 GGUF 格式下按精度量化并切分后的产物。GGUF 还支持按层(layer)加载权重,这让「显存不够就放内存、内存不够就放硬盘」的分层推理策略成为可能——推理时按需把某一层从慢速存储调入,代价是速度大幅下降,这也解释了实测中每秒 0.1 token 的生成速度。
量化(Quantization) 是把模型权重从高精度浮点数(如 FP16/BF16)转换为低精度表示(如 INT4、INT8)的技术。以 FP16 为例,每个参数占 2 字节;3 万亿参数若全精度存储需要约 6TB。而经过 4-bit 量化后,每个参数约 0.5 字节,体积可压缩到原来的四分之一左右——这正是文中「550 多 G」量化版本的由来。量化的代价是精度损失,模型能力会有一定下降,但通常远小于体积缩减的比例,因此在本地部署场景中被广泛采用。文章所说的「14 个模型分片文件」,也是因为单个文件过大不便下载和加载,才按固定大小切分。
API 接入才是日常用法,生成效果实测
本地硬跑只是验证可行性,真正实用的路径是 API 对接。在 Local Model 的设置里添加 Kimi 服务商、填入 API Key,即可获取包括 Kimi K3.1 Pro 在内的模型列表,切换到 API 模式后输出速度达到每秒 140 多个 token,体验和本地跑完全不是一个量级。
在 API 模式下,UP 主做了几组测试:
- 动画自我介绍:要求模型用动画形式介绍自己,输出速度约每秒 140+ token,约两分钟后完成,成品带有发布会风格的视觉效果,涵盖理解、推理、创作和编程四种能力表达。
- 网页微观世界:一句提示词生成一个可交互的微观世界网页,鼠标拖拽可切换视角,滚轮缩放画面,点击水面会泛起一圈圈涟漪,水波动效和交互反馈都相当细腻。UP 主提到通过 Agent 模式生成效果会更好,但资源消耗也更大。
- 3D 游戏开发:让模型调用工具在本机创建游戏项目,授权后模型自动写入文件,生成了第一人称跑酷类和 3D 台球游戏,操作流畅,台球游戏支持 E 键俯身瞄准、左键蓄力击球。
- 工业级 3D 模型:用代码构建涡扇发动机模型,风扇叶片、压气机、燃烧室、涡轮组件都被精细还原,支持自由旋转缩放,还能拆解展示每个内部零部件的结构。
这些测试的共同点是「一次搞定」——从提示词到可运行成果,中间没有人工补代码的环节。尤其是发动机拆解模型,已经超出了普通 3D 生成的范畴,更接近一套可交互的数字化工业模型。
不止对话:离线多模态的完整玩法
除了文本和代码,Local Model 平台还支持通过免费开源模型创建图片、用开源视频生成模型(如 MiniMax 系列)生成视频,以及导入开源语音模型。所有能力都可以在断网状态下离线使用,不受调用次数限制。
这一点对特定场景很有价值:数据不能出内网的机构、需要大量生成内容的创作者、以及想研究模型行为的开发者,都能在这套组合里找到落点。UP 主在视频结尾表示,所用全部资料的下载链接都放在了视频下方。
从 3 万亿参数的开源权重,到硬盘兜底的极限部署方案,再到离线多模态工具链,这次实测展示的不只是一个模型的能力,而是开源生态正在形成的完整闭环。速度慢是现阶段的事实,但能跑起来本身,就是变化的开始。
相关推荐
 科技前沿
Caro揭秘:LBJ如何用伪装骗过种族隔离派
罗伯特·卡罗在LBJ传记中记录前参议员塔尔梅奇的采访:约翰逊初入参议院时刻意迎合南方保守派,塔尔梅奇称未察觉其民权倾向。掌权后约翰逊推动1964年民权法案与1965年投票权法案,揭示政治伪装与改革时机的关系。
 科技前沿
GitHub日报·11月07日:Agent就绪与上下文压缩
2026年09月02日(周三)午间版 AI新闻速递+热点深度讨论
 科技前沿
ToolLens:用Rust打造的MCP网关,将数千工具精简为三个
ToolLens 是一个用 Rust 编写的开源 MCP 网关,只向 AI 智能体暴露三个工具而非数千个,通过网关模式解决工具数量膨胀带来的上下文压力,为 MCP 生态提供工程化参考。