KoboldCpp能干掉Ollama吗?实测揭示同源引擎的真相
KoboldCpp与Ollama底层同为llama.cpp,真正差异只在于暴露给用户的参数控制权多少。
本文深入拆解了本地AI运行工具KoboldCpp与Ollama的技术本质:两者底层均基于llama.cpp引擎,性能差异源于默认设置而非引擎本身。所谓Ollama「白嫖上游」的道德指控缺乏事实依据——两者对llama.cpp的代码贡献数量几乎持平。核心分歧在于设计哲学:Ollama仅对外暴露8个参数,追求开箱即用的简洁体验;KoboldCpp则提供56个可调字段,甚至允许用户自定义采样器的执行顺序。值得注意的是,KoboldCpp在代码层面直接实现了Ollama的API端点,两者是兼容关系而非对立竞争。选型建议因需求而异:需要安静后台服务和生态集成选Ollama,需要深度调参和全套多模态工具选KoboldCpp。
同一个引擎,两种哲学
关于本地跑AI模型,社区里一直流传着「KoboldCpp吊打Ollama」的说法。但深入拆解两者的代码和设计后会发现,这场对决远没有想象中那么戏剧化——它们跑的是同一个引擎。
KoboldCpp(原文误称Cobalt CPP)是一个单一的可执行文件,能在本地运行AI模型、生成图像、处理语音、识别图片,还自带聊天界面。它构建在llama.cpp之上。而Ollama用的同样是llama.cpp。也就是说,这两个工具的底层完全一致,真正的差异全在「打包方式」和「默认设置」上。
KoboldCpp下载后你只会得到一个606MB的文件(koboldcpp.exe),零安装、无常驻后台服务。相比之下,Ollama是一个约1000MB的安装程序,运行后是常驻的后台服务。有趣的是,功能更全、体积更小的KoboldCpp反而没人选——在发布页面上,Ollama大安装包的下载量大约是它的30倍。
关于「白嫖上游」的道德争议
网上对Ollama最大的指责,是它「只拿社区代码从不回馈」。但真去翻GitHub提交记录,这个叙事完全站不住脚。
KoboldCpp的主开发者在llama.cpp主库里总共合并过6次提交,涵盖OpenCL内核移植、断错误修复等。而把Ollama的5个核心维护者的贡献加起来,共有4人提交过代码,合计给引擎回馈了7次提交。换句话说,被指责「白嫖」的一方,反而比被夸奖「回馈」的分叉多提交了一次上游代码。
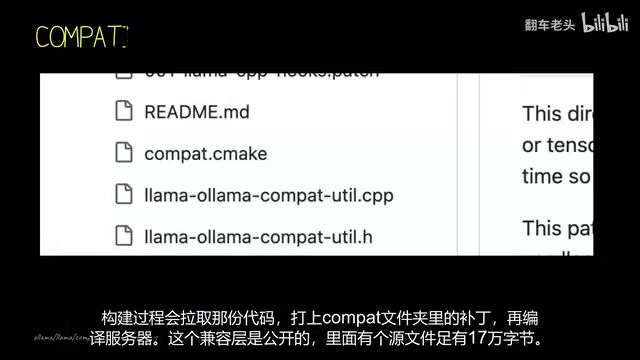
KoboldCpp在项目页面从不藏着掖着,README第一句就点名了自己源自llama.cpp,整页提了四次,还专门用MIT许可证覆盖继承来的代码。而Ollama的仓库里同样有一个llama.cpp version文件,锁定了特定的发布标签,构建时拉取代码并打上补丁再编译。两者对上游的依赖都写在明处。
GitHub上Ollama有超过18万星,比llama.cpp本身的12.8万还多出约5万。道德争议铺天盖地,但技术事实是:贡献数打平,引擎相同。
8个参数 vs 56个参数
两者真正的分野在于「给你多少控制权」。
Ollama发布的OpenAPI规范里,Options对象只有8个属性,分为采样选项(Seed、Temperature、TopK、TopP、Stop)和运行时选项(NumCtx、NumPredict等)。翻遍它的Modelfile参考,也只记录了约11个参数。这种简洁不是暂时的局限,而是产品的设计理念——它的旗舰命令就一行:ollama run gemma。

打开KoboldCpp则完全是另一番景象:一个请求结构里就有56个可调参数。除了TopA、TypicalP、Mirostat这类冷门采样器,还有4个专门防止模型重复输出的独立采样器、语法强制输出格式、禁用词表等实用设置。从命令行启动,启动器会注册165个参数,得用至少25个命令行标志。
更极致的是,KoboldCpp把采样器的执行顺序本身也当成可改参数——默认序列甚至不是从第一个采样器开始,而是从中间某处开始,每个位置都能自定义。Ollama的采样链则是锁死的,改不了。
文中提到的几个「冷门采样器」值得单独解释。**TopA(Top-A Sampling)**是基于最高概率token的绝对阈值来过滤候选词,避免低概率词干扰输出。TypicalP则从信息熵角度出发,优先选择「典型」的token而非单纯的高概率token,目的是让输出更自然流畅。Mirostat是一种动态调整采样参数的算法,通过实时测量输出的「困惑度」来反馈控制Temperature,让模型在整个生成过程中保持稳定的连贯性——这对长文本写作尤其有用。至于「采样器执行顺序」,llama.cpp的采样链是一个有序管道:每个采样器依次对候选token池进行过滤和排序,不同的顺序会导致截然不同的输出分布。KoboldCpp将这个顺序本身暴露为可配置项,而Ollama将整条链锁死,用户无法干预中间步骤。
性能差异的真相:设置,而非引擎
有用户提交过一个issue,标题是「相比llama.cpp性能大幅下降」。他用两块显卡跑700亿参数模型,llama.cpp的提示词读取速度达每秒1490 token,KoboldCpp却只有34,慢了44倍;写入速度也慢了6倍。
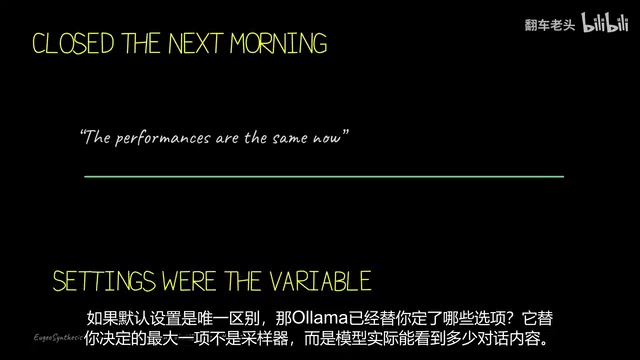
维护者的回复很直接:这是设置问题,不是缺陷。用户误选了某个显存卸载选项导致缓存无法卸载;同时Flash Attention在KoboldCpp里默认关着,而llama.cpp在源码里默认自动开启。用户第二天关掉相关选项后留言:「太完美了,现在性能一样了。」
引擎从来不是变量。所有跑分之争,最后都变成设置之争。
上下文长度:Ollama替你做的决定
默认设置里,最关键的一项不是采样器,而是「模型实际能看到多少对话内容」。Ollama不问你,直接读硬件来定:显存不到24GB默认给约4000 token,48GB给约32000,更高可拉到256000。
但它自家的Modelfile参考里写的标准默认值只有2048——而文档又说编程、智能体等场景至少需要16倍以上的上下文。这意味着普通显卡上,Ollama可能只给你一小截上下文,还得你自己动手改回来。
曾被视为KoboldCpp独门优势的「上下文切换」(Context Shift,聊天记录抄写时自动删旧token省去重建缓存),如今Ollama也已默认内置——它的Generate和Chat请求里都自带shift字段,几乎每个模型系列都自动启用,唯一例外是某代DeepSeek广告模型。
**上下文长度(Context Length)**指的是模型在生成回复时能「看到」的最大token数量,包括系统提示、历史对话和当前输入的总和。超出这个窗口的内容会被截断,模型对更早的对话内容毫无记忆。token大致对应半个到一个中文字或英文单词。2048 token约等于1500个英文单词,对于需要阅读长代码、长文档或进行多轮深度对话的场景而言极为有限。上下文越长,所需显存越大——这正是Ollama根据检测到的显存动态调整默认值的原因。**Context Shift(上下文切换)**是一种优化策略:当对话即将超出窗口时,系统不重新计算整个历史记录的KV缓存,而是将旧token滚动移出并复用已计算的部分,从而节省重建缓存的时间开销。
KoboldCpp其实在「兼容」而非「竞争」
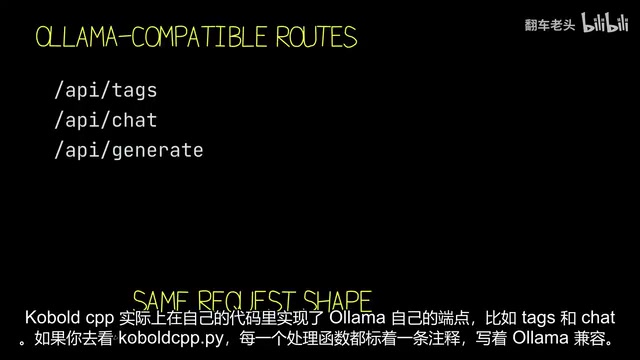
很多人以为要在「简单接口」和「全套工具」之间二选一,但KoboldCpp在自己的代码里直接实现了Ollama的端点。
查看它的处理函数,每一个都标着注释「Ollama兼容」:它把收到的Ollama格式请求转换过来,把Temperature等参数映射到自己的字段,再把工具调用打包回Ollama期望的格式发出去。被问版本时,服务器返回硬编码的版本号,注释说明这是为了兼容而伪装。同一个脚本还响应ComfyUI、转录和OpenAI端点。
KoboldCpp是在贴着Ollama的接口跑,而不是跟它对着干——为Ollama写的程序都能直接连上KoboldCpp,感觉不到区别。
到底该装哪个
对大多数人来说,答案是Ollama。它就是安静的基础设施:命令行自带启动命令,能配置并启动外部应用(官方点名了包括Claude Code、VS Code在内的五个),模型直接从自家仓库拉取。KoboldCpp没有对应的编排能力,而是靠模仿API让工具连上去。
但如果你想坐进「工作间」,摆弄56个字段、自定义采样器顺序、玩图像生成和角色卡,KoboldCpp就是你的游乐场。它还能在启动器里直接查询Hugging Face拉模型。
结论其实很朴素:两个工具都跑llama.cpp,你选的不是引擎,而是「有多少技术决策让别人替你做」。Ollama把设置写进OpenAPI只暴露8个选项,KoboldCpp在源码里声明了56个字段。两套默认值都写在明处,随时可查——这才是这场对决真正的答案。
相关推荐

AI宣传中的"毁灭叙事":为何反弹不可避免
AI支持者热衷用"AI杀死XYZ"式的毁灭叙事进行宣传,但这类夸张表述几乎从不准确。本文分析这种传播方式如何扭曲大众认知,并解释为何技术反弹不可避免,以及更健康的沟通方式。
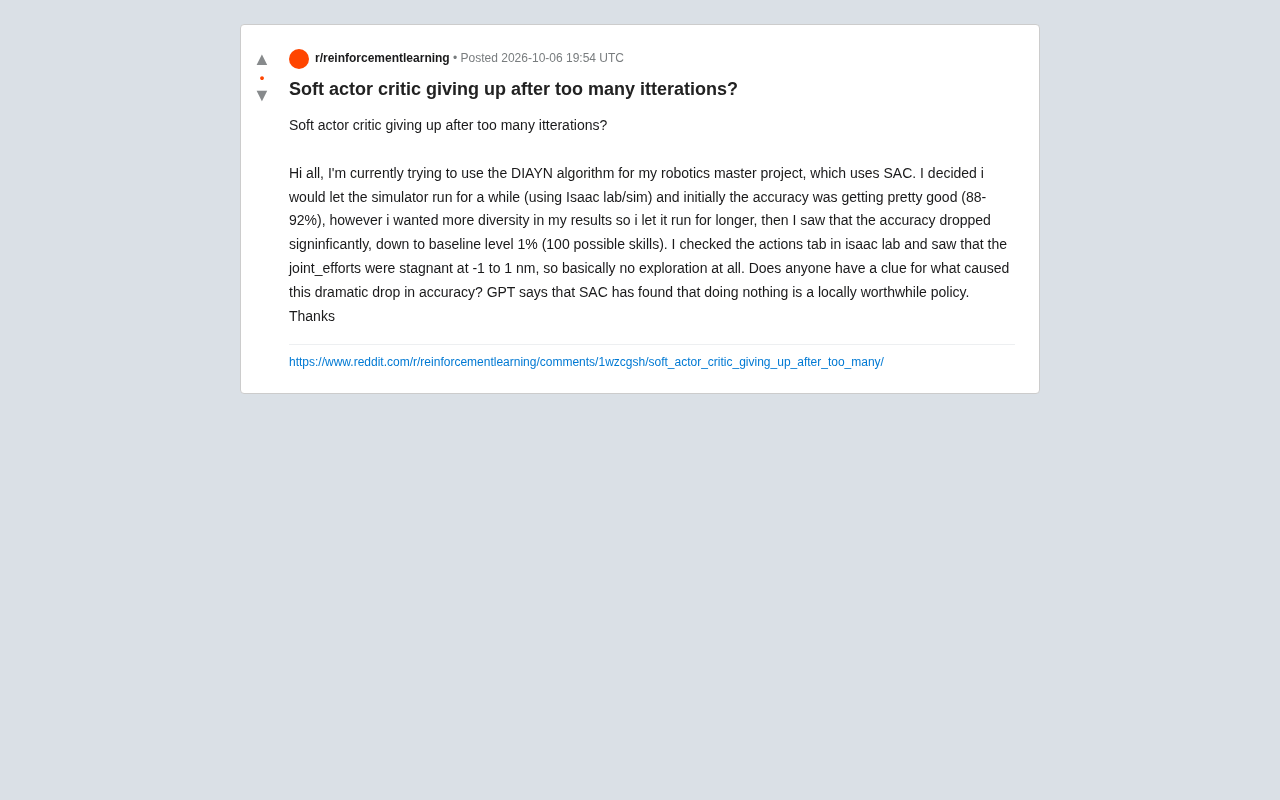
SAC训练崩溃之谜:策略熵坍塌与DIAYN调试指南
SAC(Soft Actor-Critic)训练DIAYN时准确率从90%暴跌至1%,关节力矩停滞不动?本文剖析最大熵强化学习中策略熵坍塌、温度系数失衡与判别器奖励陷阱的成因,并给出完整的排查修复指南。

用AgentCore与OpenClaw打造有记忆的AI助手
基于 Amazon Bedrock AgentCore 运行时与 OpenClaw,构建具备持久记忆的上下文感知AI助手。通过 AgentCore memory 将一次性对话转化为结构化知识,并用元数据过滤器精准检索,解决现成助手「失忆」难题。