SAC训练崩溃之谜:策略熵坍塌与DIAYN调试指南
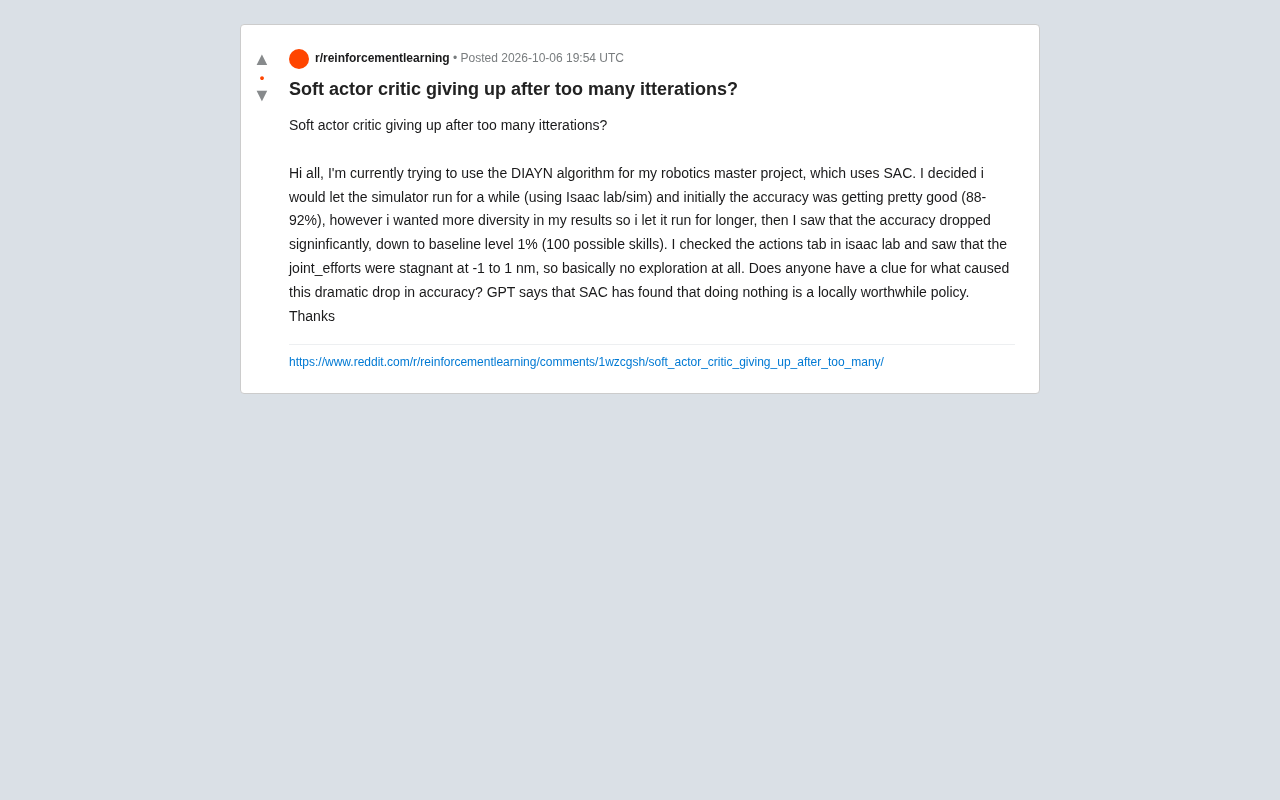
SAC训练DIAYN时因熵系数坍塌与判别器奖励失效,导致策略退化为零动作局部最优。
本文围绕一个真实案例展开分析:使用SAC算法训练DIAYN技能学习框架时,模型在达到88%-92%准确率后,随着训练延续反而崩溃至接近随机猜测的1%水平,关节力矩输出同时陷入停滞。文章从三个层面剖析根因:其一,SAC的自动温度调节机制可能将熵系数α压至极小,使探索动机消亡,策略坍塌为零动作的确定性输出;其二,DIAYN判别器在动作趋近于零时失去区分不同技能的能力,内在奖励信号随之消失,形成恶性循环;其三,长时间训练中Q函数过估计与回放池分布偏移会在某一临界点触发累积性崩溃。针对上述问题,文章提出监控熵与温度系数、调整奖励缩放、保存峰值检查点、协调判别器更新节奏等可操作建议,并指出强化学习中性能峰值往往出现在训练中段而非终点这一反直觉规律。
一位机器人学硕士研究生在Reddit上抛出了一个令许多强化学习实践者感同身受的问题:使用SAC(Soft Actor-Critic)算法训练DIAYN(Diversity Is All You Need)时,训练初期准确率表现亮眼(88%-92%),但在延长训练时间后,准确率竟然断崖式跌落至1%的基线水平——相当于在100个可能技能中纯随机猜测。更令人困惑的是,查看Isaac Lab中的动作输出后发现,关节力矩(joint_efforts)停滞在-1到1 Nm之间,几乎没有任何探索行为。
这不是个例,而是SAC类算法在长时间训练中常见的失效模式。本文结合这一具体案例,剖析背后的成因并给出可操作的排查思路。
现象还原:从高准确率到"躺平"
原帖作者描述的训练轨迹非常典型:模型先学到了有效策略,达到接近90%的准确率,但在继续运行后反而退化。他引用GPT的判断——"SAC发现什么都不做是一个局部最优策略"——这个诊断方向大体正确,但需要更深入的机制解释。
关键信号在于关节力矩的停滞。当力矩输出被压缩在狭窄区间且不再变化时,意味着策略已经收敛到一个"不动点":智能体选择近乎零动作的行为,而这种行为意外地成为了奖励景观中的一个吸引子。对于DIAYN这类依赖技能多样性的框架,一旦策略停止探索,判别器(discriminator)就无法区分不同技能,整个技能学习体系随之崩溃。
根因分析:熵系数与奖励信号的失衡
SAC的核心机制是最大熵强化学习,它在优化奖励的同时鼓励策略保持随机性。这个平衡由温度系数α控制。如果使用了自动温度调节(automatic entropy tuning),而目标熵设置不当,α可能会被优化到过小的值,导致探索动机消失。一旦熵项的权重崩塌,策略就会迅速坍缩到确定性输出,表现为力矩停滞。
DIAYN特有的奖励陷阱
DIAYN的内在奖励来自判别器对技能的预测对数概率。训练早期判别器较弱,几乎任何探索都能带来正向信号;但随着训练推进,如果策略找到了某个能被判别器轻松识别的"安全"状态(比如静止不动,所有技能都停在原地),这个状态反而可能给出看似合理的奖励。更糟的是,当动作幅度趋近于零时,不同技能的状态轨迹变得难以区分,判别器梯度随之消失,形成恶性循环。
DIAYN(Diversity Is All You Need)是一种无监督技能发现框架,其核心思想是:不依赖任何外部奖励,仅通过最大化技能(skill)与状态轨迹之间的互信息来涌现多样行为。具体做法是训练一个判别器 q_φ(z|s),尝试根据状态 s 推断出当前执行的技能编号 z;策略的内在奖励则定义为判别器的对数概率 log q_φ(z|s)——越容易被识别的技能轨迹,奖励越高。这意味着策略的优化目标是"产生让判别器易于区分的多样行为",而非完成任何具体任务。这一设计的隐患在于:如果某个静止状态(如机器人原地不动)在初始化后就能被判别器以较高概率关联到某个技能编号,策略便没有动力继续探索——静止反而成了一种"高效"的技能表达方式,彻底违背了多样性学习的初衷。
数值不稳定的叠加效应
长时间训练还会放大数值问题。Q函数的过估计、critic网络的发散、以及经验回放池中旧数据与新策略的分布偏移,都可能在某个临界点触发性能的突然崩塌。原帖中"运行一段时间后"才出现问题的时间特征,正符合这种累积性失稳的模式。
最大熵强化学习(Maximum Entropy RL)的核心思想是在传统累积奖励之外,额外最大化策略的熵(即行为的随机程度),目标函数形如 J(π) = Σ E[r(s,a) + α·H(π(·|s))]。其中 H 是策略熵,α(温度系数)决定了探索欲望与奖励最大化之间的权重。SAC 引入了自动调节机制:α 会根据实际熵与目标熵(target entropy)的差距自动更新——若策略太随机,α 下降以压制探索;若策略太确定,α 上升以鼓励探索。目标熵通常被设为 -dim(A),即动作空间维度的负值,代表"每个动作维度平均保留约 1 比特的随机性"。这一机制在训练初期工作良好,但若内在奖励信号在训练中期发生扭曲(如 DIAYN 判别器奖励失效),自动调节的 α 会将"不动"误判为高质量行为并持续压低熵,最终陷入无法自我修复的坍塌状态。
Q函数过估计(overestimation bias)是深度强化学习中的顽固问题:由于 Bellman 更新使用最大化操作,再加上函数逼近误差,critic 网络倾向于系统性高估状态-动作值。SAC 通过"取两个 Q 网络中较小值"的 Clipped Double-Q 技巧来缓解这一问题,但在长时间训练中,若经验回放池(replay buffer)中积累了大量来自早期策略的"陈旧"数据,新策略与旧数据之间的分布偏移会使 Bellman 目标的估计方差持续上升,最终可能触发 critic 梯度爆炸或 Q 值发散。一旦 Q 函数失去可靠性,actor 的策略梯度更新便失去了正确导向,整个训练过程随之崩溃。这也是为什么在实践中,适当缩短回放池长度(或使用优先经验回放)、定期检查 Q 值量级,是维持 SAC 长时间训练稳定性的重要工程手段。
排查与修复建议
针对这类问题,可以按以下顺序逐项检查:
监控熵与温度系数。实时记录策略熵和α的变化曲线。如果熵持续下降至接近零,说明探索已经消亡。可以尝试固定α为一个较大常数,或重新设定目标熵(通常设为-action_dim)。
检查奖励缩放。DIAYN的内在奖励尺度若与SAC的熵项不匹配,会导致其中一方主导优化。适当缩放判别器奖励,确保两者量级相当。
引入早停或检查点保存。既然88%-92%已经是不错的结果,在验证指标达到峰值时保存模型,避免后续训练破坏已学到的策略。这是最务实的工程防线。
审视判别器训练节奏。如果判别器更新过快或过慢,都会扭曲内在奖励信号。保持判别器与策略网络的更新频率协调,必要时降低判别器学习率。
检查动作边界与初始化。力矩被限制在-1到1 Nm可能本身就偏窄,限制了有意义的探索空间。确认动作空间的物理合理性,并检查网络输出层是否因饱和(如tanh压缩)而难以逃离零附近。
更深层的启示
这个案例揭示了一个反直觉的事实:在强化学习中,更长的训练时间不等于更好的结果。SAC与DIAYN的组合在追求多样性的同时,也埋藏了策略坍塌的风险。智能体"学会偷懒"——选择零动作作为局部最优——是最大熵框架下探索与利用失衡的直接后果。
对于机器人学习项目而言,这提醒研究者:性能曲线的峰值往往出现在训练中段,而非终点。建立完善的监控体系、保存关键检查点、理解每个超参数背后的机制,比盲目延长训练更能保证成果的可靠性。
相关推荐

Cursor AI编程工具保姆级教程:下载、模式与模型选择全解析
Cursor AI编程工具保姆级教程:从下载安装、界面布局到Agent/Ask/Manual三种模式解析,以及GPT、Claude大模型选择建议,帮你快速上手这款强大的AI代码编辑器。

Cursor Projects深度解读:云端代理会终结Claude Code吗
Cursor Projects通过云端代理解决上下文衰减问题,支持多代理并行、完整开发闭环和真实软件交付。本文解读其工作机制、实测观察,并分析它能否真正挑战Claude Code与ChatGPT Codex。

Cursor创始人深度对话:代码之死与"品味"的崛起
Cursor创始人Michael Truell深度对话:解析AI编程的真实瓶颈、"vibe coding"为何在专业开发中行不通,以及为什么"品味"将成为未来工程师唯一不可替代的能力。附AnySphere从CAD到90亿估值的创业历程。