Kotlin手写AI客服:RAG、MCP与多智能体的工程化实践

Kotlin项目用确定性代码兜底,手写RAG、MCP与多智能体客服。
文章介绍了一个名为DSupport的Kotlin Multiplatform开源项目,作者不使用任何Agent框架,从零手写RAG、MCP协议集成与多智能体编排,并以12个可运行的git tag呈现演进过程。核心主张是职责分工:模型负责理解语言、选择工具、起草回复与路由,代码负责校验类型规则、隐藏敏感数据、拦截危险操作与离线测试,项目中5个角色用模型、14个组件为纯代码。文章依次拆解了带上限的智能体循环、以相关性阈值为关键的RAG、把工具搬到独立进程的MCP、编排者不持有数据工具的强硬约束、运行在三个切点的护栏、结构化输出与生产者-审查者循环,以及带父子runId的可观测性与黄金数据集评估,最后提醒多智能体并非免费。
Kotlin手写AI客服:RAG、MCP与多智能体的工程化实践
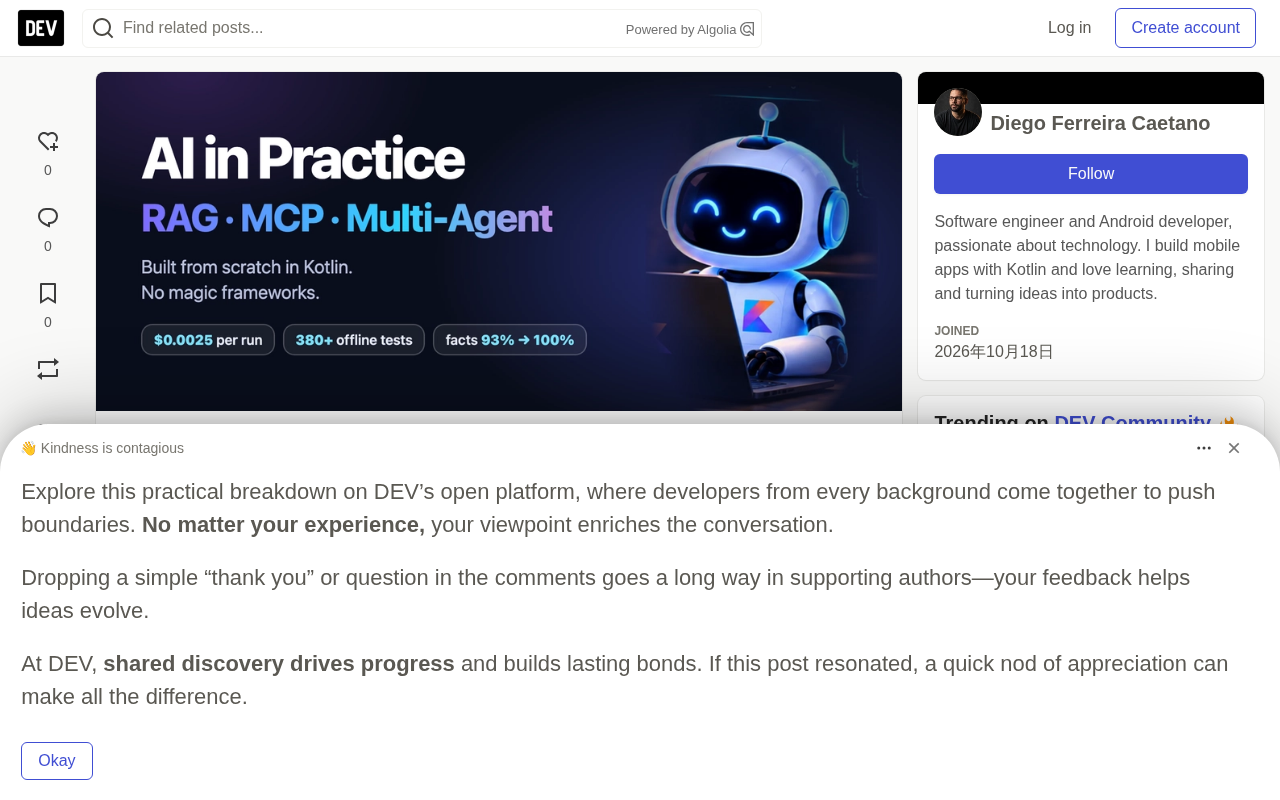
当"两行代码构建自主智能体"的框架占据技术头条时,一个现实问题被反复验证:把演示级Agent放到真实客服一线,它会幻觉、无视业务规则、泄露用户数据。开发者Diego Ferreira Caetano用一个名为DSupport的Kotlin Multiplatform项目给出了另一种答案——不用任何Agent框架,从零手写RAG、MCP与多智能体编排,并把每一步做成可运行的git tag(etapa-1到etapa-12)。
这篇文章的核心主张并非"反框架",而是一个更精细的分工问题:哪些决策该交给概率性的模型,哪些必须锁死在确定性代码里。
核心论点:模型负责理解,代码负责保证
DSupport的架构可以概括为一张职责划分表。模型(非确定性)负责四件事:理解自然语言、决定调用哪个工具、起草回复、在专家之间路由。代码(确定性)负责另外四件事:校验类型与规则、隐藏敏感数据、拦截不可放行的操作、运行离线测试。
原文给出了一个直观的对比:纯if/else路由遇到"我想要退款"这种不含"refund"字样的表达会静默落到OTHER分支;而纯模型方案则会出现不可预测的回答、无限循环与失控成本。DSupport选择了混合路径——5个角色使用模型,14个组件是纯代码(护栏、验证器、TF-IDF检索、工具、MCP传输、追踪、评估打分等)。
这个比例本身就是一种工程态度:绝大多数保障性逻辑,不应该寄希望于提示词的"建议"。
架构分层:依赖只向内,模型可替换
项目采用Clean Architecture与Ports & Adapters,模块边界清晰:
contract:共享类型定义,零外部依赖core:智能体循环、编排、护栏、审查与端口接口,不知道HTTP、Anthropic或JSON的存在adapters:实现端口,包括Anthropic客户端、RAG引擎、JSON文件、MCP客户端mcp-orders/mcp-tickets:独立的MCP协议服务端cli/server/app:终端、Ktor SSE接口、Compose桌面与iPhone应用eval:带黄金数据集的评估套件
core对模型的全部认知浓缩为一个接口:LlmClient,包含next(返回文本或工具调用请求)与structured(强制模型填充JSON表单)两个方法。更换Claude只需写一个新适配器,核心代码零改动。这种设计带来的直接收益是:380多个测试全部离线运行,没有一个测试消耗API额度。
智能体循环:一个带上限的for循环
原文把Agent loop讲得极为朴素:模型请求工具,代码执行,结果回填历史,循环直到产出答案。代码中repeat(maxTurns)是第一条不可妥协的规则——没有上限,模型会永远调用下去。
几个值得记住的细节:
- 每轮都发送完整历史与可用工具列表
- 工具调用通过
async+awaitAll并行执行,两个独立查询耗时取决于较慢的那个 - 结果按请求顺序回填,因为模型API要求对应关系
- 达到轮次上限时,由代码返回升级人工的消息,而非模型自己决定
作者的总结一针见血:模型从不执行任何东西,它只是请求。执行、校验、决定返回什么,都是代码的事。
关于“工具调用”(Tool Calling / Function Calling)机制:现代大模型在生成文本时,除了输出自然语言,还能输出一个结构化的“工具调用请求”,通常包含工具名与 JSON 参数。模型本身并不执行这个函数,它只是把“我想调用哪个工具、传什么参数”作为一次特殊的输出返回给宿主程序;宿主程序解析后真正执行函数,再把执行结果作为一条新消息追加进对话历史,模型在下一轮就能“看到”这个结果并继续推理。这套“请求—执行—回填—再推理”的往返,正是 Agent loop 的物理基础。理解这一点,就能明白为什么作者强调“模型从不执行任何东西,它只是请求”——工具调用本质上是受 schema 约束的结构化输出,执行权与校验权始终留在确定性代码一侧,这也是并行执行、超时控制、结果顺序回填等工程手段得以成立的前提。
RAG的关键不是检索,是相关性阈值
DSupport的RAG实现刻意保持简单:文章按段落切分,用TF-IDF做词权重向量化,可选接入VoyageEmbedder做语义检索。真正重要的是SearchKbTool里的minScore = 0.25这个截断值。
没有相关性阈值,检索永远会返回"某些东西",这正是"基于无关段落给出自信答案"的头号成因。当过滤后结果为空时,工具返回nothing_relevant_found,知识专家被要求回答NO_ANSWER而非编造。每个结果携带文章标题,让最终答案能够引用来源,而验证器会检查引用的来源是否真的来自本次检索。
你可能没注意到,检索本身是确定性代码,无需API密钥即可工作。
MCP:工具搬到独立进程,一行配置接入
MCP部分基于官方Kotlin SDK,通过stdio运行,客户端把服务端作为子进程启动。会话只有三条消息:initialize、tools/list、tools/call。
服务端实现的关键在于复用:任何Tool列表都能变成一个MCP服务端,同一个工具类无需重写即可远程化,readOnly与destructive标注随协议传递,供客户端决定是否要求确认。客户端侧则有严格的容错:每次远程调用都有超时,超时与异常都转为模型可读的错误结果,真正的协程取消则原样抛出。
新增一个tickets服务端只需要在config/mcp-servers.json里加一行,Agent代码完全不变——它并不知道工具是本地的还是远程的。
这里有一个容易被忽略的陷阱:stdio模式下stdout就是协议本身,一句随手的println会污染整个会话,因此服务端把System.out重定向到了System.err。
关于 stdio 传输与 JSON-RPC 会话:MCP(Model Context Protocol)是一套让模型应用与外部工具/数据源解耦的开放协议,其通信层基于 JSON-RPC 2.0,消息就是一行行的 JSON。除了基于 HTTP 的传输方式,最常见的本地模式是 stdio:客户端把服务端作为一个子进程拉起,双方通过该进程的标准输入(stdin)和标准输出(stdout)互相写 JSON 消息。这带来一个天然约束——stdout 是协议通道本身,任何非协议内容混入都会让对端解析失败,所以服务端必须把日志、调试打印改道到 stderr(这也是原文把 System.out 重定向到 System.err 的原因)。理解这一点,就能明白为什么“一行配置新增服务端”可行:协议把发现工具(tools/list)与调用工具(tools/call)标准化,客户端无需为每个服务端写专门代码,进程边界同时带来了隔离与复用。
多智能体:编排者不许拥有数据工具
DSupport的编排设计有一个强硬约束:编排者(orchestrator)被赋予资深客服协调者的角色,但不持有任何数据工具。它的职责是判断谁处理哪部分,并始终委派给专家。
专家到编排者的暴露方式很优雅——每个专家被包装成SubAgentTool,对编排者而言就是一个普通工具。代码中一个细节值得学习:SubAgentTool接收的是agent工厂而非agent实例,因为每个agent持有自己的历史,并行调用不能共享。
原文明确警告:如果也给编排者配上数据工具,它会跳过委派,整个设计就塌了。因此DSupportAssembly在编排者持有工具时会直接装配失败——用代码强制架构约束,而不是靠文档约定。
关于“面向端口编程”与子智能体即工具:Ports & Adapters(端口与适配器)是 Clean Architecture 的核心手法——核心模块只声明自己需要的接口(端口),由外层适配器去实现,依赖方向永远指向内层。DSupport 把每个专家智能体包装成 SubAgentTool,正是这一思想在 Agent 层面的复用:对编排者而言,一个专家与一个普通工具没有区别,都只是一次可调用的请求,编排逻辑不必感知专家内部如何运作、用了哪个模型、历史多长。之所以把“工厂”而非“实例”传进去,是因为智能体是有状态的——它持有自己的对话历史;若多个并行调用共享同一实例,历史就会互相污染。用工厂为每次调用生成独立实例,是并行安全的关键。这条设计也让专家可被替换、可被远程化,与 MCP 的思路一脉相承。
护栏:模型既看不见也绕不过的规则
护栏是运行在循环三个固定点的确定性代码,通过Hook接口暴露beforeTool、afterTool、beforeFinal三个切面,每个切面可以允许、拒绝或修改。
两个例子最能说明问题。IdentityGate只允许携带合法订单号与邮箱的查询通过,拒绝时返回的是一条写给模型看的指令("向客户索要订单号"),模型读到原因后能正确行动而非盲目重试。TicketDedup则用Mutex处理并行场景:两个同时发出的create_ticket调用,通过in-flight集合预留客户身份,防止重复建单。
原文的结论值得抄在墙上:提示词里写"请不要创建重复工单"是一个愿望,Mutex才是保证。
结构化输出与生产者-审查者循环
最终答案不是一段散文,而是SupportAnswer这个JSON表单:包含answer、intent、sources、confidence、escalated、ticketId。但schema只保证形状,代码才校验真伪。验证器会检查intent是否在闭集内、confidence是否在0到1之间、工单号是否真的出现在工具结果中(发明即拒绝)、引用来源是否真的来自检索。
审查者本身也是模型,所以代码先跑校验这一道便宜且精确的关卡,通过后才请审查模型评判。审查循环有硬上限(2轮修订),超限时由代码开人工工单,模型无权决定升级。
关于 TF-IDF 与相关性阈值:TF-IDF 是一种经典的词权重向量化方法,它用“词频(TF)× 逆文档频率(IDF)”衡量一个词对某段文本的代表性——在本文档出现得多、在整个语料出现得少的词权重高,像“的”“是”这类高频虚词几乎被压到零。它的优点是无需任何模型或 API、完全确定性、可离线运行,这也是 DSupport 的检索不消耗密钥的原因;缺点是它只看词面重合,无法理解同义改写,因此原文保留了接入向量嵌入模型的可选路径。阈值 minScore 则是把相似度分数当作一道门:低于门限的结果直接丢弃,宁可返回“没有相关内容”,也不把弱相关段落喂给模型。二者配合的意义在于——检索算法可以朴素,但“什么时候该判定没查到”这一决策必须由确定性阈值来兜底,否则模型会拿无关段落编出自信的答案。
可观测性与评估:黑匣子与黄金数据集
每个事件携带runId与parentRunId,父级id通过协程上下文传递,无需任何参数透传,事件列表本身就能重建调用树。服务端通过SSE把每个事件刷成一帧,flush让App能展示实时trace,API密钥始终只留在服务端。
评估模块的数据更能说明问题。黄金数据集包含15个用例,每个跑3次——因为模型不确定,原文提到有3个用例在两次单跑之间结果不同。指标从改进前到改进后:预期事实命中率93%到100%,引用来源86%到100%,升级精度80%到100%,审查失败后的降级率9%到0%。
更值得关注的是评估发现了代码审查永远发现不了的问题:两条自有规则互相矛盾、审查模型虚构反对意见、一个确定性路由错误、以及一个基于作者错误假设的测试用例。总成本约30美分,耗时一个下午。
成本提醒:多智能体不是免费的
原文给出了一个具体的运行数据:一次"订单延迟"提问消耗12次模型调用、约1.5万输入token和2千输出token,成本约0.0025美元,耗时约10秒。作者的忠告是:任务小时用一个带工具的agent,只有当提示词与工具集膨胀、角色明显不同时才拆分专家。
结语
这个项目最有价值的不是代码本身,而是它示范了一种可复用的提问方式:在你的项目里,哪条规则可以是代码而不是提示词?软件工程并没有因为AI而改变,缺少强类型、清晰架构、代码级护栏与自动化评估的Agent,仍然只是不可预测的玩具。
相关推荐

OpenAI与Shield合作:Astra智能体如何革新IT故障修复
OpenAI与Shield合作推出Astra智能体,可自动登录电脑和遗留系统,实时修复IT故障,比传统模型快35%到40%,仅在需要人类判断时引入人工。

iPhone Duo续航实测:一天一充跑不掉,大屏是耗电元凶
iPhone Duo续航实测:重度使用一天需至少充电一次,6.5小时亮屏约剩30%电量。大屏展开频率是耗电关键,MagSafe电池背夹可救场,长期衰减同样值得关注。

Kimi K3.1 Pro开源发布:2.8万亿参数逼近Opus
Moonshot发布开源MoE模型Kimi K3.1 Pro,2.8万亿总参数、1040亿激活参数,Terminal Bench 4.0仅落后Opus 5.5不到1分,单任务成本约三分之一,API价格减半,开源权重11月4日开放。