昆仑万维Matrix-Game 4.0:单卡RTX 5090跑通实时视频大模型游戏

Matrix-Game 4.0 用引擎管状态、模型管画面的分工,在单张 RTX 5090 上实现 480p/60FPS 可玩世界并开源。
昆仑万维发布并开源 Matrix-Game 4.0,称其为第一款跑在单张消费级显卡上的视频大模型游戏:RTX 5090 上 480p/60FPS,端到端延迟低于 150 毫秒,显存峰值 18.5 GiB。其核心是把游戏运行与画面呈现拆开——引擎维护世界状态并输出结构画面,视频模型只负责实时渲染,从而解决上一代世界模型状态不可验证、长期一致性漂移、规则不可靠三大卡点。支撑它的是数据、训练、推理三层链路:UE5 跨域对齐数据集、动态 Caption 机制,以及 CUDA Graph 预录制、FP8 融合 kernel、环形 KV 缓存等工程优化。借助 Coding Agent,玩家可用自然语言改写玩法,发布即开源。
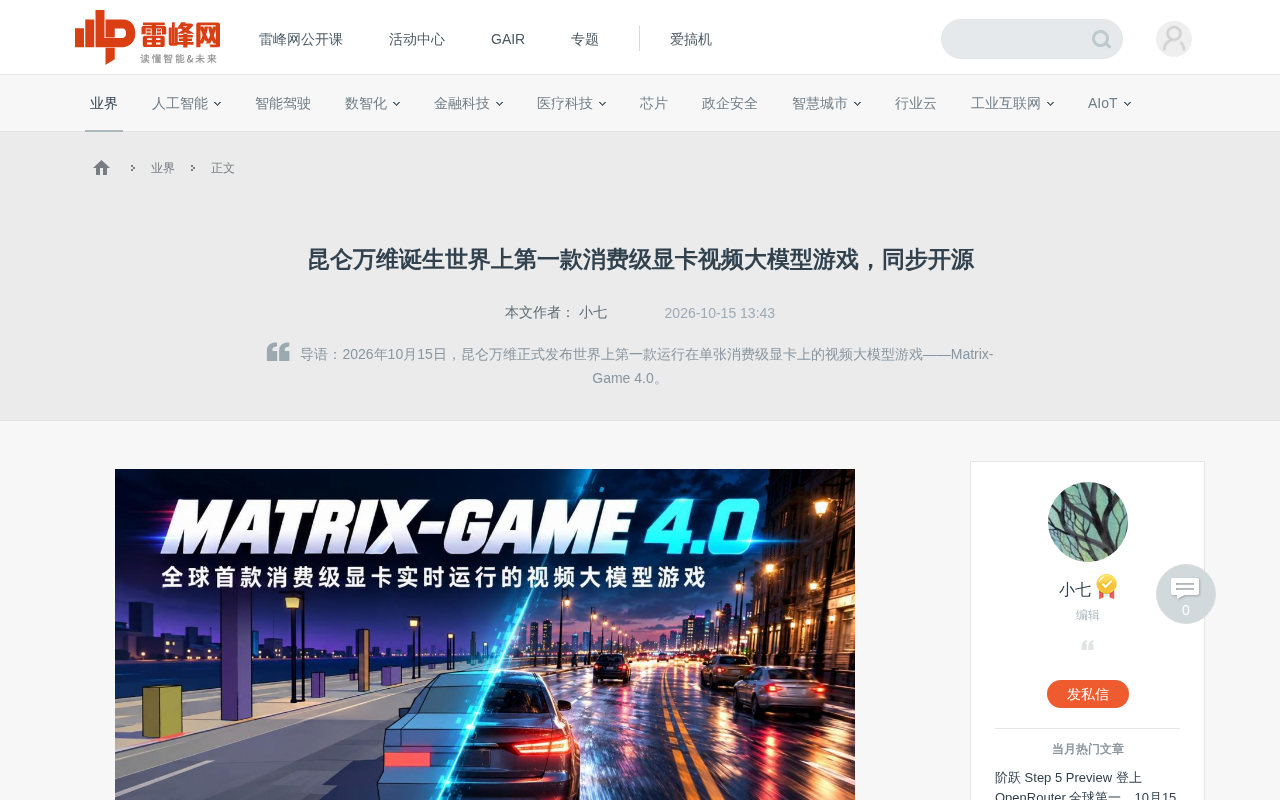
从"看 AI 生成视频"到"亲手玩 AI 生成的世界",隔着的是一道关于"实时"的坎。昆仑万维发布的 Matrix-Game 4.0 声称跨越了这道坎——它成为第一款运行在单张消费级显卡上的视频大模型游戏,并同步开源。
游戏世界模型的新范式:引擎管状态,模型管画面
Matrix-Game 4.0 最核心的架构决策,是把"游戏如何运行"与"游戏如何呈现"拆成两条并行的链路。游戏引擎负责维护世界状态与交互规则,视频生成模型只负责实时呈现精细画面。
具体来说,Coding Agent 通过代码构建轻量游戏,引擎作为"裁判"持续维护世界状态、执行交互规则,并输出结构画面与动态语义条件;视频模型作为"画师",将简单几何转化为丰富画面。
这个分工解决的是上一代交互式世界模型始终未能处理的问题:世界状态缺少独立、可验证的维护机制。在旧路线下,场景与物体的持续存在依赖模型的内部表示和历史记忆,开发者无法精确读取、修改和验证每一个物体的状态。Matrix-Game 4.0 把世界"寄存"在显式的引擎中,而不是模型的记忆里。
硬指标:480p/60FPS,延迟低于150毫秒
Matrix-Game 4.0 给出了一组明确的性能数字:
- 单张 NVIDIA RTX 5090,480p 分辨率下游戏以 60 FPS 运行
- 从玩家按键到首帧响应,端到端延迟低于 150 毫秒
- 单步去噪的稳态生成速度达 83 FPS
- 显存峰值 18.5 GiB
对比其他方案,Code World Model 延迟约 10.2 秒、StreamRender-H3 约 545 毫秒、AgentGarten 约 878 毫秒,而 Matrix-Game 4.0 只有 112 毫秒。算力需求上,其他方案分别需要 1× H200 141GB、8× GB200 与 1× H100 数据中心卡,Matrix-Game 4.0 仅需一张消费级显卡。
DiT(Diffusion Transformer) 是这里的关键技术名词。传统扩散模型多采用 U-Net 卷积结构,而 DiT 把去噪主干换成纯 Transformer,用自注意力处理被切成 patch 的潜空间特征。它天然适合吃多模态条件——文本、结构画面、历史帧都能作为 token 序列拼接进来,也让"因果"时序建模更自然:本方案采用 30 层因果 DiT,自注意力读 K/V 缓存、交叉注意力读文本 K/V,从而在逐帧生成时复用历史计算。代价是注意力开销大,必须靠 KV 缓存与算子融合压住延迟,这正是它能在单卡上跑到实时帧率的前提。
FP8 量化与融合 kernel 是低延迟的另一半。FP8 指用 8 位浮点(E4M3/E5M2 等格式)表示权重与激活,相比 FP16 显存占用与带宽减半,在支持该精度的 GPU 上矩阵乘吞吐显著提升,而对扩散模型输出画质的影响通常可接受。但量化本身不自动变快——若每层都单独启动 kernel,调度与访存开销会吃掉收益。因此团队为 RoPE、归一化和 FP8 量化编写融合 kernel,把多个逐元素操作塞进一次 GPU 调用;再用 CUDA Graph 把整段 DiT 主干预录制成图,运行时一次性重放,消除逐 kernel 的 CPU 启动开销。二者叠加,才让文本编码器、DiT、VAE 全部常驻一张消费级显卡。
三个根本卡点:为什么"能走"的世界"不好玩"
昆仑万维在发布材料中梳理了上一代交互式世界模型的三个结构性问题,这构成了 Matrix-Game 4.0 设计的出发点。
世界状态缺少独立维护机制
在没有外部引擎维护显式状态的情况下,模型可以"记住"曾经看到的画面,但这不等于开发者能精确读取、修改和验证每一个物体状态,也难以保证视野之外的角色和事件始终按指定规则演化。
长时间交互的一致性难以稳定保证
自回归生成依赖此前的生成结果,局部偏差可能随着连续交互传播、累积。当玩家长时间探索、反复返回同一地点,场景结构、物体身份和交互结果都可能发生漂移。扩大上下文、引入记忆机制能改善问题,但不带来游戏级的长期一致性保障。
合理画面不等于可靠规则
模型可以生成开门、碰撞或攻击等视觉效果,但完整游戏还需要精确的数值结算——生命值增减、道具归属、任务进度、胜负判定。这些机制必须能被开发者明确定义、修改和测试,并在长时间运行中保持一致。
三个问题指向同一件事:游戏需要的,是一个可以被读取、被修改、被验证的世界。
数据、训练与推理加速的完整链路
一个能实时运行的"游戏世界",背后是数据、训练与运行时三层能力的打通。
数据层基于虚幻引擎 5 构建了结构画面-精细画面跨域对齐数据集,覆盖 CitySample 超大城市、开放沙漠、复杂城堡、高动态空战四大场景。自研轻量化几何抽象采集管线在保持相机轨迹与时间戳严格同步的前提下,将复杂场景抽象为低模结构表征,并与高模影视级画面逐帧像素级对齐。
动态 Caption 机制让描述跟着游戏走。系统将场景中物体的 ID 与语义描述关联,从游戏引擎获取当前可见对象及实时状态,运行时填入提示词模板。结构画面提供位置、布局和运动信息,Caption 补充对象及状态等语义信息,两者共同约束生成。
推理加速方面,团队用 CUDA Graph 将 DiT 主干计算预录制、运行时一次性重放;为 RoPE、归一化与 FP8 量化编写融合的专用 GPU kernel;文本条件的 KV 只在 Caption 更新时重算;视频历史 KV 改用环形缓存。最终,文本编码器、DiT 与 VAE 可以全部常驻一张 RTX 5090。
视频模型基于 Wan2.2 5B 改造为视频到视频模式,引擎渲染的结构画面与待生成视频按通道拼接(148 通道输入),采用 30 层因果 DiT,自注意力读 K/V 缓存,交叉注意力读文本 K/V。
Coding Agent:用自然语言改写游戏
Matrix-Game 4.0 最具想象力的部分,或许是它有多容易被"改"。借助 Coding Agent,玩家可以在现有游戏代码基础上,用自然语言定制自己的游戏:调整地形、布置场景物件、修改 NPC 行为与交互逻辑,甚至设计全新玩法。
例如"让怪物从四面八方涌来",不仅意味着画面中出现更多怪物,还需要实现生成位置、移动方式、攻击行为和胜负条件。编程智能体也可以协助定义场景的语义与视觉风格:同一个简化建筑,既可以设定为海边的旧屋,也可以成为未来都市中的商店。
创意不再卡在 3D 资产的生产线上,而是可以直接进入"可玩、可迭代"的阶段。
开源策略与后续路线
Matrix-Game 4.0 在发布时同步开源,代码、权重、白模均已开放,Huggingface 仓库地址为 Skywork/Matrix-Game-4.0。对比 Code World Model 与 StreamRender-H3 的已开放、AgentGarten 的部分开放,Matrix-Game 4.0 的开源程度更高。
团队表示将持续迭代模型:部署 refiner 提高画面分辨率,探索跨玩家视角保持一致的多人联机体验,提供更细粒度的画面控制,并拓展对更多游戏类型与场景的支持。
从"可控制的视频"到"可运行的世界",这一步的技术意义在于:它让视频生成模型第一次具备了本地部署与实时交互的实际价值,而不是一段离线渲染的演示视频。对于小团队和个人创作者而言,搭建轻量游戏引擎的成本正在大幅降低,"小团队也能搭世界"或许不再只是口号。
相关推荐

OpenAI与Shield合作:Astra智能体如何革新IT故障修复
OpenAI与Shield合作推出Astra智能体,可自动登录电脑和遗留系统,实时修复IT故障,比传统模型快35%到40%,仅在需要人类判断时引入人工。

iPhone Duo续航实测:一天一充跑不掉,大屏是耗电元凶
iPhone Duo续航实测:重度使用一天需至少充电一次,6.5小时亮屏约剩30%电量。大屏展开频率是耗电关键,MagSafe电池背夹可救场,长期衰减同样值得关注。

Kimi K3.1 Pro开源发布:2.8万亿参数逼近Opus
Moonshot发布开源MoE模型Kimi K3.1 Pro,2.8万亿总参数、1040亿激活参数,Terminal Bench 4.0仅落后Opus 5.5不到1分,单任务成本约三分之一,API价格减半,开源权重11月4日开放。