Lakebase Search 正式发布:Postgres 原生向量与全文检索
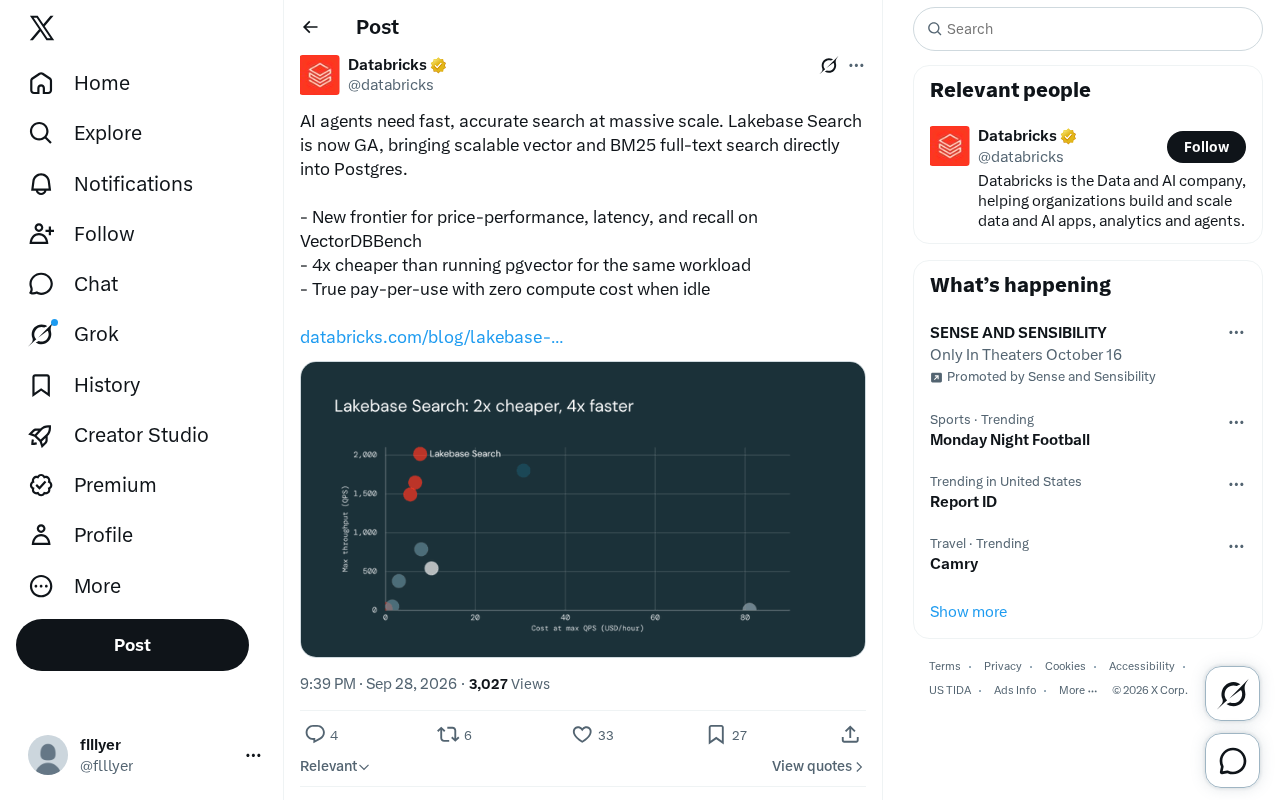
Databricks 的 Lakebase Search 正式 GA,将向量检索与 BM25 全文检索原生内建于 Postgres,主打低成本与弹性计费。
Databricks 宣布 Lakebase Search 正式进入 GA 阶段,将可扩展向量检索与 BM25 全文检索直接内建到 Postgres 数据库,目标是从基础设施层面解决 AI 智能体和 RAG 系统在大规模数据场景下面临的延迟、召回率与成本三重压力。官方给出三项量化承诺:在 VectorDBBench 基准上刷新性价比-延迟-召回综合水平;处理相同工作负载时成本为 pgvector 的四分之一;以及空闲时算力成本归零的真正按量付费模式。对开发者而言,核心价值在于无需额外拼装独立向量数据库即可获得混合检索能力,同时降低了架构复杂度和数据同步负担。文章建议以上官方数据须结合真实业务场景验证后再做选型决策。
AI 智能体(AI Agent)要在海量数据中稳定运行,检索能力是绕不开的底座。响应慢、召回不准、成本失控,都会直接拖垮上层应用的表现。Databricks 近日宣布 Lakebase Search 正式进入 GA(General Availability,正式可用)阶段,将可扩展的向量检索与 BM25 全文检索直接内建到 Postgres 之中,试图从数据库层面解决这个问题。
为什么 AI 智能体需要更强的检索
检索是 RAG(检索增强生成)和 Agent 工作流的核心环节。智能体在执行任务时,往往需要在极短时间内从大规模知识库中拉取相关上下文,任何一次高延迟或低召回的查询,都可能导致推理结果偏差或整体链路卡顿。
当业务规模扩大到百万乃至亿级向量时,传统方案常常面临三重压力:延迟难以稳定、召回率随规模下降、成本随数据量线性甚至超线性增长。Lakebase Search 的定位,正是要在「大规模」这一前提下,同时兼顾速度、准确性与经济性。
向量检索与 BM25 的融合
Lakebase Search 的一个关键设计,是把向量检索和 BM25 全文检索都直接放进 Postgres。这两种检索代表了两条互补的路径:向量检索擅长捕捉语义相似度,BM25 则在关键词精确匹配上表现更稳。
把二者统一在同一个数据库引擎内,意味着开发者可以在熟悉的 Postgres 环境里构建混合检索(Hybrid Search)能力,而无需额外拼装独立的向量数据库和搜索引擎。对于已经把数据沉淀在 Postgres 生态中的团队来说,这降低了架构复杂度和数据同步的维护负担。
混合检索(Hybrid Search)通常需要一个额外的步骤将两路结果合并——业界常用 RRF(Reciprocal Rank Fusion,倒数排名融合)等算法,把向量相似度排名与 BM25 文本相关性排名加权合并成最终结果列表。将两种检索引擎原生内置于同一数据库,意味着这一合并逻辑可以在引擎内部完成,省去了应用层自行编排两个独立服务、处理网络往返和结果序列化的开销。对于延迟敏感的 Agent 链路,减少一次跨服务调用有时就能将端到端延迟降低数十毫秒。
性能与成本:官方给出的三个数字
根据官方披露的信息,Lakebase Search 在几个维度上做了明确的量化承诺:
- 性价比、延迟与召回的新前沿:官方称其在 VectorDBBench 基准测试上,在价格-性能、延迟和召回率上达到了新的水平。VectorDBBench 是业界较为常用的向量数据库对比基准,用作横向比较有一定参考价值。
- 成本比 pgvector 便宜 4 倍:在处理相同工作负载时,官方声称成本仅为直接运行 pgvector 的四分之一。pgvector 是 Postgres 生态中广泛使用的开源向量扩展,以它作为对比基准,直接指向了同一批潜在用户。
- 真正的按量付费:空闲时算力成本归零(zero compute cost when idle)。这种「用多少付多少」的模式,对于流量波动大、峰谷明显的 Agent 应用尤为友好,避免了为闲置资源持续买单。
需要说明的是,以上数据均来自厂商官方口径,实际表现仍需结合具体工作负载和第三方评测验证。
pgvector 是 PostgreSQL 的开源扩展,由 Andrew Kane 在 2021 年发布,允许在标准 Postgres 表中存储向量并进行近似最近邻(ANN)搜索。它的广泛采用得益于与现有 Postgres 工具链的零摩擦集成,但在超大规模数据集下,其基于 IVFFlat 或 HNSW 索引的性能往往受限于单机内存和 CPU 资源,难以水平扩展。Lakebase Search 以 pgvector 作为成本对比基准,实质上是在声明:即便你已经选择了「最轻量」的 Postgres 原生方案,托管服务仍能在算力利用率上做到更优,尤其是通过空闲时归零计算成本来拉低整体 TCO(总拥有成本)。
对开发者意味着什么
对于正在搭建 AI 智能体或 RAG 系统的团队,Lakebase Search 提供了一条「留在 Postgres 内」的技术路线。如果你的数据已经在 Postgres 中,又希望获得比自建 pgvector 更优的成本和性能表现,这一 GA 版本值得纳入选型评估。
真正的价值点在于两处:一是向量与全文检索的原生融合,减少了系统集成的摩擦;二是按量付费的定价模型,把成本与实际使用量绑定。对预算敏感、且难以预估流量的早期项目,这种弹性尤为重要。
当然,选型不应只看官方基准。建议在真实业务数据上做小规模验证,重点观察在自身数据分布下的召回质量、P99 延迟,以及在实际流量曲线下的月度成本,再决定是否迁移。
小结
Lakebase Search 的 GA,反映了当前基础设施的一个明确趋势:向量检索能力正从独立组件,逐步下沉进主流数据库。把语义检索与关键词检索都收拢到 Postgres 之内,既顺应了开发者对统一技术栈的偏好,也在成本结构上给出了更具竞争力的答案。至于官方给出的 4 倍成本优势和基准领先能否在各类真实场景中兑现,仍有待更广泛的社区实践检验。
相关推荐

只想要一个自定义域名邮箱,为何如此艰难?
拥有一个自定义域名邮箱看似简单,实则涉及 SPF/DKIM/DMARC 配置、IP 信誉、托管服务成本等诸多难题。本文梳理自建与托管方案的权衡,并给出实用建议。

Claude意外帮用户发现燃气泄漏:AI助手的安全应用边界
一位Reddit用户借助AI助手Claude识别出家中燃气泄漏隐患,PG&E上门确认并修复。本文分析AI助手在家庭安全场景中的真实价值与使用边界,以及处理燃气泄漏的正确做法。

Gemini 4 Argon发布:谷歌重返前沿,但故事没那么简单
谷歌时隔半年发布前沿模型Gemini 4 Argon,跑分重返一线却暂不开放。本文解析其基准表现、与Sonnet 5.5的竞争,以及模型能力与产品体验之争。